数据结构总结(CSP-S)
wsy_I
·
2026-09-23 20:34:32
·
算法·理论
本文总共 \color{red}106336 字符,不建议一次性食用。
::::info[AI 使用声明]
保证本人的贡献远大于 LLM。
使用了 Deepseek 来查找相关算法的例题,正文部分为全部手打。
::::info[个人的声明]
文章的前后部分可能码风有一定差异,因为这样一篇篇幅巨大的文章施工过程是需要一定时间的,在这期间我稍微换了一点码风。还有部分代码我是抄的我写的远古代码,所以码风可能也存在较大差异。不影响理解。
本文是 J 组那篇的续作。可能也会掺杂一些 NOI 级的算法,但是都是对 S 组有用的那种。同时由于提高组数据结构需要更多的练习,所以有一些章节可能比较题海战术。带星号的章节是选学章节,由于不常见于 CSP-S,所以以一等奖为目标的选手可以选择性跳过。
本文在阅读到后面的时候会与前文的内容融会贯通,争取达到让大家掌握知识体系的目标,并且对于一些算法提出了自己的理解(至少我在别的专栏里面没有翻到过)。所以阅读文章的时候建议顺序阅读。
6. 堆(优先队列)
6.1 堆的基本概念
注意:本章仅讨论二叉堆。其余东西都是 NOI 级考点。
堆是什么?
一棵完全二叉树,有点权,并且满足父节点的点权大于 / 小于左右孩子的点权。
我相信假如你看懂了“二叉树与霍夫曼树”这一节,你也可以看懂这一句话。比如下面的三个图中,只有第一个是堆,后面的都不是。
为什么第二个不是?因为点权为 2 的节点的点权小于左孩子的点权,又大于右孩子的点权,所以不满足堆的性质。第三个不是的原因是它不是一棵完全二叉树。
所以这个东西有什么用?堆会维护一个集合,支持以下的三个操作,实现会在后面一一给出。
查询集合中的最值。
将集合中的最值删除。如果有多个最值,那么只删除一个。
向集合里添加一个数。
为什么堆支持最值操作?这由它的性质而决定。由于一个节点的值必定比左右孩子都要大 / 小,所以根节点代表的必然是当前集合中的最值。然后,由于堆是一个完全二叉树,高度只有 \log n ,所以堆天然支持高效的调整。
假如这个堆满足节点的点权大于左右孩子的点权,那么这个堆就是一个小根堆;反之则为大根堆。
好的,是时候实现一个堆了!
6.2 堆的代码实现
首先给出 模板题。
果然模板题就是模板题,直接把堆写在了脸上。由于模板题要求的是小根堆,所以我们使用小根堆进行演示。
为了实现方便,并且堆本身就是一棵完全二叉树,所以我们使用完全二叉树的数组表示法:节点 x 的左孩子为 2x ,右孩子为 2x + 1 。
一、插入
假设我们现在已经得到了这样的一个堆,现在要向里面插入 7 。
首先,我们不管是否满足堆性质,直接把 7 塞到后面。那么这个堆就变成了这样:
注意到这里的节点 8 不满足小根堆的性质了,因为 8 > 7 !所以,我们需要调整这个堆的结构,来让这个堆满足堆性质。对于插入的调整,叫做上浮。
什么是上浮呢?对于新插入的节点,如果这个节点的点权比父亲小,那么就交换它和父亲的点权。一直向上交换,直到这个节点的父亲和它满足小根堆性质(或者节点称为堆顶)。比如上面的堆,把 7 和它的父亲 8 的点权交换,然后发现 2\le 7 ,满足了堆性质,不需要继续交换了,于是上浮结束,形成的堆如下:
可以发现,这个堆现在满足堆性质了。容易证明在插入的节点上浮之后这个堆必定满足堆性质。
上浮的操作用迭代很好实现,下面给出示例代码:
#define fa(x) x / 2
int h[], t;//堆数组,
void surf(int x) {//上浮操作
    while(x > 1 && h[fa(x)] > h[x]) {//记得要判x>1,即不为根
        swap(h[fa(x)], h[x]);//交换点权
        x = fa(x);//现在指向新的位置,迭代下一轮
    }
}
void insert(int x) {//插入
    h[++t] = x;//直接扔到后面去
    surf(t);//上浮
}
二、删除
假如我们要从刚才的堆中删除最小值 2 。
我们还是不管是否满足堆性质,直接把 2 的点权和在最后面的 8 的点权交换,最后面这个节点删掉,也就是 t 指针减 1 。然后堆就变成了这样:
很明显,又不满足堆的性质了!
于是我们需要另一个操作来调整:下沉。这也是堆最难的一个操作。
我们现在需要把 8 这个节点放到应该的位置,也就是把它和某个孩子交换直到它到了合适的位置。这一操作就叫做下沉。具体该如何实现?分以下的步骤:
取这个节点点权较小的一个孩子。
如果这个孩子的点权比目前需要下沉的节点的点权大,那么证明这个节点的点权比左右孩子都小,也就是已经下沉到了正确的位置,那么终止。
否则将需要下沉的节点的点权与这个孩子耳朵点权交换,然后迭代。
比如对于上面的堆,下沉的过程是这样的:
可以发现这个堆也满足堆性质了。在下沉之后的堆必定满足堆性质也容易证明。
代码还是用的迭代,实现如下:
#define lc(x) x * 2
#define rc(x) x * 2 + 1
void sink(int x) {//下沉操作
    while(1) {
        if(lc(x) > t) break;//判边界,如果没有孩子了,退出,一定不要漏
        int mc = lc(x);//假设最小的孩子是左孩子
        if(rc(x) <= t && h[rc(x)] < h[mc]) mc = rc(x);//有右孩子+右孩子点权小于左孩子=最小的孩子是右孩子
        if(h[mc] >= h[x]) break;//如果最小的孩子点权大于当前节点点权,停止下沉
        swap(h[mc], h[x]);//交换这个节点和最小的孩子
        x = mc;//继续迭代
    }
}
void pop() {//删除操作
    swap(h[1], h[t]);//交换点权
    t--;//把最后一个节点删了
    sink(1);//下沉
}
三、查询最小
这一点没有什么好说的,取堆顶即可。代码如下:
int top() {
    return h[1];//取堆顶
}
四、完整模板
于是模板题的代码就很好写了:
::::success[代码]
#include<bits/stdc++.h>
#define endl '\n'
#define fa(x) x / 2
#define lc(x) x * 2
#define rc(x) x * 2 + 1
using namespace std;
const int N = 1e6 + 10;
struct heap {
    int h[N], t;
    void surf(int x) {
        while(x > 1 && h[fa(x)] > h[x]) {
            swap(h[fa(x)], h[x]);
            x = fa(x);
        }
    }
    void insert(int x) {
        h[++t] = x;
        surf(t);
    }
    void sink(int x) {
        while(1) {
            if(lc(x) > t) break;
            int mc = lc(x);
            if(rc(x) <= t && h[rc(x)] < h[mc]) mc = rc(x);
            if(h[mc] >= h[x]) break;
            swap(h[mc], h[x]);
            x = mc;
        }
    }
    void pop() {
        swap(h[1], h[t]);
        t--;
        sink(1);
    }
    int top() {
        return h[1];
    }
} hp;
int n;
int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0); cout.tie(0);
    cin >> n;
    for(int i = 1; i <= n; i++) {
        int op, x;
        cin >> op;
        if(op == 1) {
            cin >> x;
            hp.insert(x);
        } else if(op == 2) {
            cout << hp.top() << endl;
        } else {
            hp.pop();
        }
    }
    return 0;
}
::::
五、STL
当然,STL 是提供了封装好的堆的,叫做 priority_queue。这个东西主要有以下用法:
priority_queue<int> pq;//大根堆,这里int换成别的类型也可以
priority_queue<int, vector<int>, greater<int> >//小根堆
pq.push(x);//向堆中加入一个数x
pq.pop();//删除堆中最小值
pq.top();//查询最小值
pq.empty();//查询堆是否为空
于是使用 STL,模板题就很好写啦~
下面给出示例代码:
::::success[代码]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
priority_queue<int, vector<int>, greater<int> > pq;
int n;
int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0); cout.tie(0);
    cin >> n;
    for(int i = 1; i <= n; i++) {
        int op, x;
        cin >> op;
        if(op == 1) {
            cin >> x;
            pq.push(x);
        } else if(op == 2) {
            cout << pq.top() << endl;
        } else {
            pq.pop();
        }
    }
    return 0;
}
::::
后面的代码都用 STL 优先队列实现。
没有例题,例题在下一节。
6.3 堆的应用
一、建霍夫曼树(隐式)
先给出一道 例题。
首先,这个问题本质上是一个霍夫曼树压缩得到的字符串长度问题。如何抽象?把每一堆果子看成一种字符,合并两堆果子看做给这两个果子建一个父亲节点,需要的代价为两个节点的点权之和,然后父亲的点权等于两个节点的点权之和。
那么这个代价可以看做什么呢?注意,在霍夫曼编码中,每一个节点的编码长度是树根到这个节点的路径长度。给这两个节点建一个父亲就相当于把路径长度都增加了 1 ,也就是两个节点内部的所有字符的霍夫曼编码长度都加了 1 。由于霍夫曼树得到的编码长度是最优的。
那么如何实现?首先把所有的果子数量扔到堆里,然后每次取两个最小的,将代价加上这两个点的点权之和,然后把这个和扔进堆里就可以了。
好像只有 n = 10^4 暴力搞一下也可以过。
但是 STL 给我们提供了好用的优先队列,所以我们要用优先队列来维护一下。容易发现之前的实现用到的操作都是堆的基本操作。那么时间复杂度就变成 \mathcal{O}(n\log n) 了。
代码如下:
::::success[代码]
#include <bits/stdc++.h>
#define int long long
#define endl '\n'
using namespace std;
int n, ans;
priority_queue<int, vector<int>, greater<int> > pq;
signed main() {
    ios :: sync_with_stdio(0);
    cin.tie(0); cout.tie(0);
    cin >> n;
    for(int i = 1; i <= n; i++) {
        int x;
        cin >> x;
        pq.push(x);
    }
    for(int i = 1; i < n; i++) {//果子必定会被合并 n-1 次
        int t1 = pq.top();
        pq.pop();
        int t2 = pq.top();//取前2小值
        pq.pop();
        ans += t1 + t2;//累加答案
        pq.push(t1 + t2);//塞回堆里去
    }
    cout << ans << endl;
    return 0;
}
::::
二、对顶堆
这一种算法是用来维护前缀 k 大或者前缀中位数的。
首先还是把 例题 搬出来吧。
首先,我们可以考虑拆分这个数列。在某个数列的前缀中,肯定可以被拆分成两半:一半是小于等于中位数的,另一半是大于中位数的。在实际编程中,我们不用实际上这么存,我们只需要一半存前 n/2 小的数,后一半存其它的数就可以了。
假如前一半是向下取整,那么中位数就是后一半的最小的数。
然后考虑怎么插入。由于是对于“前奇数项”求中位数,所以每一次都会插入两个数,也就保证了在后面肯定每一个堆都会多一个数。
先讨论插入第一个数的情况(假如要让存储前 n/2 小数的堆多一个数)。
假如第一个数比前面的 n/2 小数要小,那么就应该被放到前 n/2 小数的堆里面。然后前面的堆已经多了一个数了,所以不需要继续调整。
否则,把这个数插入到其它数的堆里。接着,前 n/2 小数的堆应该加入一个数,所以把其它数的堆取一个最小值,然后把这个最小值塞到前 n/2 小的数的堆里面。这样就正确的调整了两个堆的大小。
插入第二个数与插入第一个数相似,区别在要让存储其它数的堆多一个数,也就是在第一种情况才要把堆顶塞到另一边去。
这个时候我们就可以解释为什么要用堆,以及为什么要“对顶”了。因为要支持高效的添加元素,删除最值,查询最值,所以这就是一个堆的模板。然后,一个堆维护的是 n/2 小数,是大根堆,另一个堆维护的是 n/2 大数,是小根堆,所以两个堆的堆顶其实是大小相邻的元素,也就是所谓“对顶”。
清楚了所有情况之后,代码就很好写了,注意千万不要讨论错。
::::success[代码]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 1e5 + 10;
int n, a[N];
priority_queue<int> q_small;//前n/2小的堆,包括中位数
priority_queue<int, vector<int>, greater<int> > q_large;//前n/2大的堆
int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0); cout.tie(0);
    cin >> n;
    for(int i = 1; i <= n; i++) cin >> a[i];
    q_small.push(a[1]);//初始处理第一个数,避免访问空堆
    cout << a[1] << endl;//前1个数的中位数肯定是第一个数
    for(int i = 2; i < n; i += 2) {
        int b = a[i];//讨论第一个数
        if(b < q_small.top()) q_small.push(b);//如果小于直接塞前n/2小的堆里
        else {
            q_large.push(b);//先塞进大堆里
            q_small.push(q_large.top());
            q_large.pop();//调整大堆小堆大小
        }
        b = a[i + 1];//讨论第二个数
        if(b < q_small.top()) {
            q_small.push(b);//先塞进小堆里
            q_large.push(q_small.top());
            q_small.pop();//调整大小
        }
        else q_large.push(b);//否则直接塞大堆里
        cout << q_small.top() << endl;//中位数必定是小根堆中最大的数
    }
    return 0;
}
::::
最后给出一些练习题:
黑匣子
荷马史诗
::::success[题解]
黑匣子
这个是对顶堆维护 k 小值的题。
其实和对顶堆维护中位数挺像的,也是开两个堆,一个存前 k 小的堆,一个存其它的数,插入的元素分类讨论一下插入到哪边,如果插入到 k 小的堆就把堆顶放到另一边去。
具体实现上,输入有一点诡异,所以处理起来有一点难写,但不是主要问题,我相信大家都能写对的。
荷马史诗
不知道为什么是青。
这其实就是一个建 k 叉霍夫曼树的题目。并且这道题需要真的把树建出来。
具体,把所有元素扔到一个堆里,每一次都弹出前 k 大,对于这些节点新开一个父亲,所有节点都向这个父亲连边。注意到这里有一个第二问,就是要求最长的长度最短,那么我们在堆里可以使用双关键字排序,对于每一个点再加一个关键字树高,按照先比权值小,然后比树高小的方法排序。开的父亲的树高明显是所有孩子的最大树高加 1 。
接着从开的最后一个节点(树根)开始,对这棵树跑一遍 dfs / bfs,求出树高。
7. 并查集
7.1 基本概念
并查集是一个支持集合合并,查询所在集合的数据结构。
我们先想想对于这个问题的朴素做法。假设要合并 x, y 所在的集合,我们就直接把 x 所在集合的元素搬到 y 所在的集合,然后更新 x 中所有元素的所在集合。这样做是 O(n^2) 的,具体 Hack 方法是把 1 合并到 2 上,然后把 1 合并到 3 上,以此类推。
这个朴素做法是可以优化的。我们基于将小的东西搬到大的东西那里比把大的东西搬到小的东西那里更加省力的常识,我们每一次把小的集合合并到大的集合上。这样做是 O(n\log n) 的,已经比较优秀了。证明比比较简单,就是一个数被移动的话,它所在集合的大小至少翻倍,所以每个数最多被移动 O(\log n) 次。
但是并查集这个东西可以将这个问题优化到 O(n\alpha(n)) 。其中 \alpha(n) 是反阿克曼函数,在 n\leq 2^{64} 的时候不超过 4 ,可以当作常数。为什么这么厉害呢?因为并查集使用了优秀的树形结构 。
我们可以将一堆集合看作森林,每一棵树的根,就是这个集合的代表元素 。那么,每一次合并两个集合的时候就不需要搬动整个集合了,只需要将一个集合的代表元素向另一个集合的代表元素连一条边就可以了,这极大的优化了集合的合并。同时,查询所在集合也可以用这个代表元素来代表所在的集合。
那么关键就来到了如何寻找一个集合的代表元素。一种朴素的想法就是从一个节点一直跳父亲,直到到了根为止。由于合并刻画的就是把一个集合的元素给搬到另一个集合中,所以一个节点找代表元素的代价就是它被搬动的次数。所以直接合并是 O(n) 的,判断大小之后合并(后文称为:启发式合并 )是 O(\log n) 的。
但是如何 \alpha(n) ?还有最后一个关键优化:路径压缩 。我们看如下一棵并查集:
现在我们查询了 4 的代表元素,总共经过了 4,3,2,1 四个节点。这意味着什么?1,2,3,4 的代表元素都是 1 !因此我们可以直接将 4,3,2 挂到 1 下面,并查集就变成了这个形态:
这意味着我们可以直接对于 2,3,4 这几个节点做到 O(1) 查询了!看起来,这个优化是一个非常强的优化。事实上,这个优化确实非常强,只使用这个优化的平均复杂度是 O(\alpha(n)) ,最劣复杂度是 O(\log n) ,并且常数很小。如果将这个优化和启发式合并相结合,就可以做到非常厉害的最劣复杂度 O(\alpha(n)) 。对于这个复杂度的证明非常复杂,我不会,想要了解的请去 OI Wiki。
但是写启发式合并会增加代码复杂度,并且在一般的题目上不会快多少,所以我个人一般不写启发式合并。因此,后面的代码除非特殊情况,均只使用路径压缩。
7.2 代码实现
先把话放在这里,这个东西没有 STL,大家别想偷懒。
为了简化实现,我们定义一个代表元素的父亲是自己,这样可以快速判断是否找到了代表元素。后文将节点 x 的父亲记为 fa_x 。
路径压缩的具体实现可以采用递归。我们定义 find(x) 表示 x 的代表元素。首先根据定义,显然有:
find(x)=\begin{cases}find(fa_x)&fa_x\neq x\\x&fa_x=x\end{cases}
因此我们可以直接实现一个递归函数做这个功能。每一次向 fa 递归的时候,直接将这个节点的 fa 赋值为最后找到的根就可以了。写出来大概是这样的:
struct union_find {
    int fa[N];
    void init(int n) { for(int i = 1; i <= n; i ++ ) fa[i] = i; }
    int find(int x) {
        if(fa[x] == x) return x;
        return fa[x] = find(fa[x]);
    }
    void merge(int x, int y) { fa[find(x)] = find(y); }
};当然,find 上面的这种写法只是为了清晰易懂,实际上有用三目运算符常数更小的写法,我通常采用下面这种写法。
int find(int x) { return fa[x] == x ? x : fa[x] = find(fa[x]); }下面给出 模板题 的完整代码。
::::success[code]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

const int N = 2e5 + 5;
int n, m;
struct union_find {
    int fa[N];
    void init(int n) { for(int i = 1; i <= n; i ++ ) fa[i] = i; }
    int find(int x) { return fa[x] == x ? x : fa[x] = find(fa[x]); }
    void merge(int x, int y) { fa[find(x)] = find(y); }
} u;

int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> m;
    u.init(n);
    while(m -- ) {
        int z, x, y;
        cin >> z >> x >> y;
        if(z == 1) u.merge(x, y);
        else cout << (u.find(x) == u.find(y) ? "Y" : "N") << endl;
    }
    return 0;
}
::::
下面是一些练习题:
::::success[题解]
亲戚
模板题。甚至数据范围这么小可以随意暴力(?)
时间复杂度 O(n^2) ,O(n\log n) ,O(n\alpha(n)) 均可。
01 迷宫
我们对于每一个节点遍历其四联通的节点,如果可以到达,那么在并查集上做合并。
对于每一个关键节点,维护其子树大小,合并的时候加一下就可以了。然后,每一个节点可以到达的节点数量就是其集合的关键节点的子树大小。
时间复杂度 O(n\log n) 或 O(n\alpha(n)) 。
营救
看到最大值最小,果断考虑二分这个最大值。然后判定 x 是否可行的时候直接把所有权值 \leq x 的边两端节点的集合给合并一下,然后看 s, t 是否在同一集合即可。
时间复杂度 O(n\log^2n) 或 O(n\alpha(n)\log n) 。有使用 MST 的 O(n\log n) 做法,在此不表。
修复公路
全部联通,相当于从某一个节点出发,找到的集合大小为 n 。这个条件显然充要。
因此我们按照时间排序,顺序模拟合并即可,时间复杂度 O(n\log n) 。
或者还有一种做法是注意到单调性,所以二分答案,然后暴力判定每一个节点的集合是否相同,时间复杂度 O(n\log^2n) 或者 O(n\alpha(n)\log n) 。
算了后文默认并查集是 O(\alpha(n)) 的吧。
集合
怎么感觉就两个板子拼一起啊 /fad。
首先我们可以筛出来 [1,b] 中的所有质数,然后枚举其中大于 p 的所有质数,将模 p 等于 0 的数全部合并到一起。具体表现就是将 p,2p 合并到一起,然后将 2p,3p 合并到一起,以此类推。显然对于单个 p 可以做到 O(k\alpha(k)) ,其中 k=\frac{n}{p} 。
根据经典结论,质数的倒数和是 O(\log\log n) 的。所以总时间复杂度 O(n\alpha(n)\log\log n) ,显然可过。
关押罪犯
一个比较典型的扩展域并查集。
我们首先拆点,把一个点 u 拆成 u 和 u' ,分别表示 u 在一号监狱和 u 在二号监狱的状态。然后我们从大到小考虑,假如可以避免这个冲突发生,那么答案可以更小,否则就是当前冲突的影响力。
具体的,每一次冲突,我们希望避免的话,肯定 u,v 不能在一个监狱中。反之,u 和 v' 必定在一个监狱中,v 和 u' 也必定在一个监狱中。所以在并查集做一下这个合并。
但是具体如何处理?假如 u 和 u' 或 v 和 v' 在合并之后处于了同一个集合里,那么肯定就没办法避免这一次冲突了。所以直接这么判断就可以,因为一次合并只会影响 u,v 与其反状态的连通性。
7.3 带权并查集
所谓带权并查集,就是带权的并查集。废话
那么问题具体在于:
第一个问题是简单的,肯定是挂在并查集的节点上嘛。有的题目会挂在所有节点上,有的题目会只挂在树根上。
第二个问题丰富多样,因题而异。我们通过一道简单的例题来一探究竟。
不难想到对于 i,j 之间有多少战舰这一个询问做差分,维护 i 到队头的元素个数和 j 到队头的元素个数,将这个数组记为 f ,那么答案显然就是 f_j-f_i+1 。
接下来问题来到了如何维护 f 。每一次将 i 接到 j 后面的时候,我们可以直接将 i 集合中整体的权值加上 f_i 。这一个是简单的,直接在根节点打一个标记就可以了。
但是有一个困难的点:直接做似乎并不能怎么优化,因为启发式合并的话我们假如要将 j 合并到 i 上,这样直接在 i 上打标记难免会对 j 中元素也造成影响。假如路径压缩的话,我们压缩的时候,似乎被压缩节点并不好处理。但是事实上,这两种方法都可以稍微修改,就适配于这道题了。
对于启发式合并,既然无法去除对 j 的影响,那么就直接抵消掉!我们将 j 这里的标记加上 -siz_j (siz 表示集合大小),就可以直接去除掉这个的影响了。同样,合并到父亲的时候,我们把到父亲的标记这一部分需要去除掉。然后这里标记会冲突,所以我们分成两个标记维护。(感觉这里表达能力有点稀烂 /ll,感觉这篇题解写的比较好)
对于路径压缩,我们把这个节点压缩的时候,将其自身的加标记加上父亲的加标记。这样,父亲离队头的距离就自然的传递到了它的上面。此时父亲的状态需要被正确的更新,所以我们只能够在回溯的时候更新状态。
任取其一是 O(n\log n) 的。当然两者兼用并不影响,所以可以做到 O(n\alpha(n)) 。下面给出的代码是只采用启发式合并的写法。权值复杂,有些时候使用路径压缩可能难以维护,但是启发式合并通常不会增加太多维护的难度。
::::success[code]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

const int N = 2e5 + 5;
int T, fa[N], siz[N], add[N], f[N];

int find(int x) { return fa[x] == x ? x : find(fa[x]); }
int get(int x) { return fa[x] == x ? add[x] : get(fa[x]) + f[x] + add[x]; }
void merge(int x, int y) {
    x = find(x), y = find(y);
    if(x == y) return;
    if(siz[x] > siz[y]) {
        fa[y] = x;
        add[x] += siz[y];
        f[y] = -add[x];
        siz[x] += siz[y];
    } else {
        fa[x] = y;
        f[x] = siz[y] - add[y];
        siz[y] += siz[x];
    }
}
int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> T;
    for(int i = 1; i <= 3e4; i ++ ) fa[i] = i, siz[i] = 1;
    while(T -- ) {
        char c;
        int i, j;
        cin >> c >> i >> j;
        if(c == 'M') merge(i, j);
        else {
            if(find(i) != find(j)) cout << "-1\n";
            else cout << abs(get(j) - get(i)) - 1 << endl;
        }
    }
    return 0;
}
::::
练习:
Propagating Edges
Cave Paintings
水箱
::::success[题解]
Propagating Edges
这题我写过题解。
Cave Paintings
并查集和 DP 的一个结合。
首先,这里水要从上往下流,所以从上往下考虑并不简单,因为下面的会被上面给流下水,因此从下往上考虑。
然后这里,对于每一个节点,假如其下面 / 左边有节点,那么这个节点应该与之合并成为一个大的部分。哎,这里看到合并了,所以考虑并查集。
合并的时候直接乘法原理,这个节点的方案数是合并集合两边的方案数之乘积。接着,每一行都可以在这一行选择填或者不填水,所以这一行剩余的每一个集合的方案数都要加一。
最后使用乘法原理,对于所有集合的方案数乘起来就是答案。
时间复杂度 O(nm\alpha(nm)) 。
水箱
这题比上一个难啊。为什么上一个蓝,这个青。
首先考虑两个格子水位必须相同的条件,也就是一个格子可以通过一条路径,其中隔板高度都不超过当前水位,到达另一个格子。这显然是图论中的最小瓶颈路 ,根据经典结论,这是 MST 两点间最小边权。因此考虑在 MST 上转移。
我们模仿 kruskal 的过程,从小到大考虑边权。那么其两边必定是独立的,也就是如果中间隔板被水盖住了,那么两边连通块都应该被水盖住。合并的时候,连通块整体不漫过最高的隔板的方案数(对于一个连通块,定义为 f ,左边记作 f_l ,右边记作 f_r )可以这么算:
首先左右两边可以任意组合。然后还可以左边水位高于左边的最高隔板(记为 w_l ,w_r 同理),但是不超过中间隔板。所以方案数就是 f=(f_l+w-w_l)(f_r+w-w_r) 。
最后答案就是唯一剩余的连通块的方案数,加上全部溢出的方案数(H 减去 MST 上最大挡板高度)。时间复杂度 O(n^2\alpha(n)) 。
*7.4 可撤销并查集
并查集支持集合合并和查询所在集合。
可撤销并查集比并查集多一个操作,就是撤销上一次合并操作,并且复杂度保持 O(n\log n) 。具体是怎么做到的呢?
首先这个并查集不能使用路径压缩,因为均摊性质会被破坏。例如,我们构造一条长度为 O(n) 的链(可以通过合并 1,2 ,然后合并 2,3 ,以此类推做到),然后查询链底这个节点的所在集合代表元素。那么这样整条链都会被缩起来,如果我们想要撤销这个操作,那么需要还原这个并查集的形态,撤销代价就变成 O(n) 的了。然后再合并回去再撤销,这样复杂度就炸了。
因此只能够使用启发式合并。(或者加上路径压缩也可以,但是这样还是 O(\log n) 的,但是会难写很多,没有意义)我们每一次合并的时候,按照启发式合并的方法维护集合的大小。然后假设这一次合并是将 x 的父亲设置为 y ,那么令操作前的 x,y 所对应的父亲为 f_x',f_y' ,集合大小为 siz_x',siz_y' ,那么有如下的等式:
\begin{cases}f_x'=x\\f_y'=f_y=y\\siz_x'=siz_x\\siz_y'=siz_y-siz_x\end{cases}
理解一下。第一个式子是因为 x 在合并之前,父亲就是自己,因为它是代表元素。第二个式子是显然的。第三个式子是因为 siz_x 始终没有被修改。第四个式子是因为 siz_y 只被加上了 siz_x' 。所以每一次合并的时候只需要记录 x,y 就可以了,没有必要记录 siz_x 和 siz_y 。
原理知道了,代码实现其实并不复杂。最应该注意的部分就是 find 函数千万不能路径压缩。
struct dsu {
    int f[N], sz[N];
    stack<pair<int, int> > st;
    void init(int x) { for(int i = 1; i <= n; i ++ ) f[i] = i, sz[i] = 1; }
    int find(int x) { return f[x] == x ? f[x] : find(f[x]); }
    void merge(int x, int y) {
        x = find(x), y = find(y);
        if(x == y) return;
        if(sz[x] > sz[y]) {
            f[y] = x;
            st.push({y, x});
            sz[x] += sz[y];
        } else {
            f[x] = y;
            st.push({x, y});
            sz[y] += sz[x];
        }
    }
    void del(int tp) {
        int x = st.top().first, y = st.top().second;
        st.pop();
        sz[y] -= sz[x];
        f[x] = x;
    }
} u;
练习:
::::success[题解]
半彩三重奏
首先边数是 O(n) 的,这保证了我们算法的时间正确性。所以考虑预处理所有查询。假如我们现在已经把图缩成了若干合法的连通块,那么答案显然为连通块大小的平方和。
我们思考一个查询 \{x, y\} 该怎么做。显然经过的边两个端点只能是 \{x, y\} ,\{x, x\} ,\{y, y\} 。对于每一条边的 \{x, y\} ,我们直接暴力遍历每一条边做。然后 \{x, x\} 和 \{y, y\} 这一部分,也可以根据边数的均摊来做。首先按照第一关键字排序,在第一关键字为 x 的时候把所有的 \{x, x\} 边都加进去。然后按照第二关键字排序,具体操作同理。
时间复杂度 O(n\log n) 。可能轻微卡常。
最小 mex 生成树
复杂度分析的时候默认 w,n,m 同阶。
首先判定一个值是否可行非常简单,把除了这个值以外的所有边权的边全部合并,如果整个图还是组成一个连通块那么这个值合法。
直接枚举这个值是 O(n^2\alpha(n)) 的,显然会超时。但是我们可以优化枚举,采用一种叫做缺一分治的 Trick,具体可以看这篇文章。当然,本题不能够记录并查集状态回滚,这样变成 O(n^2) 的了。但是可以使用可撤销并查集撤销掉对于另一边的加入操作,这样撤销的代价比合并代价要小,就直接忽略掉了。
8. 哈希表
注意:本章中所讨论“哈希表”均采用挂表法实现(感觉比开放寻址表现稳定一点?)。本章节不讨论 字符串哈希。
8.1 基本概念
哈希表支持在一个很大的值域上做期望 O(1) 单点修改,单点查询。
同时这个值域可以不是数字,也可以是二元组,字符串什么的,只要你能够提供合适的函数将其转化为合理范围内(通常指 [0, 2^{64}-1] )的正整数即可。然后,哈希表不是稳定的,所以可能存在卡哈希 的问题,当然 CCF 一般不会干这种亏心事。有一种稳定的做法是平衡树,只不过这种做法时间会多一个 \log 。总之哈希表确实是一种短小精悍的数据结构。
哈希表基于数据分组 。我们可以将索引下表给映射到若干分组中,对于每一组分别维护。假如对于组的映射足够随机,并且组数是 O(n) 的,那么每一组中期望只有 O(1) 个元素,如果可以 O(1) 计算这个分组,那么就可以在期望 O(1) 时间内找到这个元素对应的位置。
具体的分组方法有很多,一种常用的方法是基于取模的。我们取一个大质数 ,记为 p (不是质数也可以,但是不够优秀),然后把下表按照 p 的同余类分组。这种方法分组的话,显然随机生成的数字被分到的组也是随机的,所以质量比较高。当然,卡这个哈希也比较简单,构造一堆对于 p 同余的数就可以了,但是平时测试的时候鬼知道你用的什么模数。
8.2 代码实现
我们可以对于每一个模数开一个链表,比如 p=5 ,插入 7,13,12,5,2,9 的时候哈希表长这样:
具体维护这个东西的写法可以类似于图论中的链式向前星,每一次向一个链表中插入一个数字的时候,都将这个数字置于链头,对于每一个节点维护其下一个节点。代码还是很短的(代码中 ull 是 unsigned long long 类型)。
struct hash_table {
    static const int P = 1145141; //这里要 static,否则会 CE
    int head[P], nxt[N], tot;
    ull val[N], id[N];
    ull& operator [] (ull x) {
        int p = head[x % P];
        while(p) {
            if(id[p] == x) return val[p];
            p = nxt[p];
        }
        id[ ++ tot] = x;
        nxt[tot] = head[x % P];
        head[x % P] = tot;
        return val[tot];
    }
} h;
然后直接把 h 当数组用就可以通过模板题了,下面是完整实现:
::::success[code]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

const int N = 5e6 + 5;
using ull = unsigned long long;
struct hash_table {
    static const int P = 1145141;
    int head[P], nxt[N], tot;
    ull val[N], id[N];
    ull& operator [] (ull x) {
        int p = head[x % P];
        while(p) {
            if(id[p] == x) return val[p];
            p = nxt[p];
        }
        id[ ++ tot] = x;
        nxt[tot] = head[x % P];
        head[x % P] = tot;
        return val[tot];
    }
} h;
int n;
ull x, y, ans;

int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n;
    for(int i = 1; i <= n; i ++ ) {
        cin >> x >> y;
        ans += 1ULL * i * h[x];
        h[x] = y;
    }
    cout << ans << endl;
    return 0;
}
::::
这种东西,C++ 肯定是良心的给我们提供了 STL 的,这个 STL 就是 unordered_map。用法也是直接当做数组用。除此之外,还有 map,这个是平衡树实现的,平均情况比 unordered_map 要慢,无法通过本题。然后由于模板题黑心的卡掉了 unordered_map,也无法通过。但是众所周知这个东西是基于同余的,所以我们只需要对输入的数做一些映射,来破坏其同余性质就可以了!
比如说,你可以生成一个随机数 x ,然后每次查询 v 的时候位置都是 v\oplus x ,其中 \oplus 代表按位异或。这样就可以很好的破坏同余性质了。哈希表还有 __gnu_cxx::gp_hash_table 和 __gnu_cxx::cc_hash_table,但是其实我感觉知道 unordered_map 就够了。
使用 unordered_map 通过模板题的代码如下:
::::success[code]
我测过了,不加快读会超时。
所以 STL 常数大,卡常的时候可以尝试手搓。
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

char buf[1<<23],*p1=buf,*p2=buf;
#define gc() (p1==p2&&(p2=(p1=buf)+fread(buf,1,1<<21,stdin),p1==p2)?EOF:*p1++)
inline unsigned long long rd() {//读入一个 64 位无符号整数
    unsigned long long x=0;
    char ch=gc();
    while(!isdigit(ch))ch=gc();
    while(isdigit(ch)) x=x*10+(ch^48),ch=gc();
    return x;
}

const int N = 5e6 + 5;
using ull = unsigned long long;
mt19937_64 rnd(chrono::steady_clock::now().time_since_epoch().count());
int n, v;
ull x, y, ans;
unordered_map<ull, ull> h;

int main() {
    cin >> n;
    v = rnd();
    for(int i = 1; i <= n; i ++ ) {
        x = rd(), y = rd();
        ans += 1ULL * i * h[x ^ v];
        h[x ^ v] = y;
    }
    cout << ans << endl;
    return 0;
}
::::
哈希表在题目中通常起辅助作用,不是主要算法,没有练习。
9. 树状数组
9.1 基本概念
树状数组可以在数据满足结合律的时候 O(n\log n) 小常数查询前缀信息,并且支持单点修改,最好的一点是代码长度和暴力差不多。
假如信息还存在逆元,那么可以支持区间查询(与前缀和类似)。有的时候也可以通过推式子支持区间修改。
我们首先定义 \operatorname{lowbit}(x) 为 x 二进制位下最靠后一个 1 对应的数值。例如 \operatorname{lowbit}(12)=4 ,\operatorname{lowbit}(6)=2 。接下来,我们构造一个数组 t ,满足(其中 a 是原数组):
t_x=\sum^{x}_{i=x-\operatorname{lowbit}(x)+1}a_x
或者形象的,我们对于 11 长度的数组构建如下关系,可以使用下图表示:
其中黑框中的数表示在 t 数组中的位置,红框表示这个数在 a 数组中求和的这一段。随即我们发现了一个非常重要的性质:
\operatorname{lowbit}(x\pm \operatorname{lowbit}(x))>\operatorname{lowbit}(x)\\\forall i\in[x-\operatorname{lowbit}(x)+1,x+\operatorname{lowbit}(x)-1],i\neq x\operatorname{lowbit}(i)<\operatorname{lowbit}(x)
理解是简单的,向前 / 向后 \operatorname{lowbit}(x) 位的话,最后一位的 1 就被抵消成 0 了,\operatorname{lowbit} 自然就增加了。然后假如没有移动这么多位,那么肯定在最后一位的 1 后面还有 1 ,所以 \operatorname{lowbit} 必定会更少。
那么首先考虑怎么做前缀和,比如我们想要求 [1, 7] 数字的和。我们发现这个实际上等于 t_7+t_6+t_4 ,并且 6=7-\operatorname{lowbit}(7),4=6-\operatorname{lowbit}(6) 。也就相当于你在 \operatorname{lowbit} 上一直往前跳。这个是容易理解的,因为每一次你把当前 t 的值求了之后,就应该找到上一个位置,然后往前求了。具体图示如下:
现在为什么是“树状”也就清楚了。假如把每一个数 x 和 x-\operatorname{lowbit}(x) 连边,那么会形成一个森林。
这么求前缀和的复杂度是 O(\log n) 的,理由如下:每一次向前跳 \operatorname{lowbit} 都会增加,然后 \operatorname{lowbit} 至多有 \log n 种。
接着问题就来到做修改了。我们对于一个点,需要找到包含它这个点的所有区间。于是,我们来看这棵树状数组呈现出来的另一棵树(将 x 和 x+\operatorname{lowbit}(x) 连边):
我们发现,这棵树上从 x 往上找,就可以找到包含 x 的所有节点!证明是简单的。由于 \operatorname{lowbit}(x+\operatorname{lowbit}(x))>\operatorname{lowbit}(x) ,我们可以发现 x+\operatorname{lowbit}(x) 必定包含了 x 。接着证明 [x+1,x+\operatorname{lowbit}(x)-1] 中不可能有包含 x 的数。
令 y<x+2^k ,其中 2^k<\operatorname{lowbit}(x) 。那么必然有 \operatorname{lowbit}(y)\leq2^{k-1} ,因为后面 k-1 位必定有 1 。那么容易发现 y-\operatorname{lowbit}(y)+1\leq y-2^k+1 ,假如我们给出来的这个 k 是最大的 k 满足 y<x+2^k ,就可以得到 y-\operatorname{lowbit}(y)+1>x 了。
所以我们成功的证明了这么找肯定能不重不漏的够找到所有包含 x 的区间。于是修改的时候一直这么往上找,就可以正确的更新 t 了。时间复杂度证明类似求前缀和,是 O(\log n) 的。emm,小小的一个数组中竟然包含了两棵树,很精妙的数据结构啊。
9.2 代码实现
这玩意也没有 STL,所以老老实实手打吧。
概念已经很清楚了,假设我们能够 O(1) 的求出 \operatorname{lowbit}(x) ,那么我们就可以做到高效的 O(\log n) 操作了。我们先给出结论:x & -x。
原理在哪里呢?假如你认真的预习了 J 组初赛,你就会知道负数使用的是补码表示,也就是 2^{32}+x 的二进制。例如 -1 ,会被表示为 0xFFFFFFFF,而 1 会被表示为 0x00000001。这个时候,与起来就正好是 1 !接下来严谨证明这个结论:
由于补码是 2^{32}+x ,所以就相当于 (2^{32}-1)-(|x|-1) ,也就是把 31 个 1 中 |x|-1 中的 1 的位数都给翻转。首先令 \operatorname{lowbit}(x)=k ,那么,|x|-1 也就相当于 |x| 的二进制表示中最后 k-1 位变成了 1 而 k 位变成了 0 。
这个时候,我们发现 k 位前面的 1 对应的补码正好变成了 0 ,k 位所对应的补码正好是 1 !所以与出来就只有 2^k 了!感觉非常巧妙啊,老祖宗的智慧。
至于树状数组的初始化,显然可以使用前缀和达到 O(n) ,但是由于树状数组常数超级小,所以一般大家懒得写这个东西,直接单点修改一个一个点改上去。所以很容易写出一个简单的树状数组(维护单点修改和前缀和):
struct BIT {
    int t[N];
    int lowbit(int x) { return x & -x; }
    void update(int x, int v) {
        for(; x <= n; x += lowbit(x)) t[x] += v;
    }
    int query(int x) {
        int res = 0;
        for(; x; x -= lowbit(x)) res += t[x];
        return res;
    }
} T;
我就说跟暴力差不多长吧。稍微加一些处理就可以通过模板题了,完整代码如下(区间 [x,y] 的和可以拆成 [1,y] 的和减去 [1,x-1] 的和):
::::success[code]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

const int N = 5e5 + 5;
int n, m;

struct BIT {
    int t[N];
    int lowbit(int x) { return x & -x; }
    void update(int x, int v) {
        for(; x <= n; x += lowbit(x)) t[x] += v;
    }
    int query(int x) {
        int res = 0;
        for(; x; x -= lowbit(x)) res += t[x];
        return res;
    }
} T;

int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> m;
    for(int i = 1; i <= n; i ++ ) {
        int a;
        cin >> a;
        T.update(i, a);
    }
    for(int i = 1; i <= m; i ++ ) {
        int op, x, k;
        cin >> op >> x >> k;
        if(op == 1) T.update(x, k);
        else cout << T.query(k) - T.query(x - 1) << endl;
    }
    return 0;
}
::::
然后是练习:
::::success[题解]
【模板】树状数组 2
树状数组无法直接做区间修改。所以考虑化区间修改为单点修改。
我们维护原数组的差分数组 s ,那么一个元素 i 的值就正好是 [1,i] 的前缀和。然后,对于 [l,r] 的区间加,可以被转化为对于 l 做加法,然后对 r+1 做减法。用差分维护原数组是一个很常见的树状数组 Trick。
时间复杂度 O(n\log n) 。
统计和
和模板完全相同。
【模板】线段树 1
是的我们的树状数组来喧宾夺主了。并且这道题的最优解就是树状数组的。
首先维护原数组显然没有前途,所以我们还是从差分数组 s 的角度考虑。首先,区间查询 [l,r] ,可以首先拆成对于 [1,l-1] 的查询和对于 [1,r] 的查询,然后对于 [1,x] 的查询做如下变形:
\begin{aligned}&\sum^{x}_{i=1}a_i\\=&\sum^{x}_{i=1}\sum^{i}_{j=1}s_j\\=&\sum^{x}_{i=1}(x-i+1)s_i\\=&x\sum^{x}_{i=1}s_i-\sum^{x}_{i=1}(i-1)s_i\end{aligned}
第一步是直接利用差分数组性质。第二步是考虑每一个 s_i 被求到的次数,其实就是 i 及后面的每一个数都会贡献一次,所以次数是 x-i+1 。第三部分是去掉式子里面的 x ,这样就可以便于树状数组维护前缀和了。
这样就很好维护了,是两个树状数组,都按照【模板】树状数组 2 做就可以了。
*9.3 二维树状数组
普通的树状数组维护的是一个序列,支持单点修改和 [1,x] 子序列查询。以此类推,二维树状数组维护的是一个平面,支持单点修改和 (1,1,x,y) 子矩形查询。
具体怎么做?横向和竖向拼起来!我们定义 t_{x,y} 表示 (x-\operatorname{lowbit}(x)+1,y-\operatorname{lowbit}(y)+1,x,y) 这个子矩形的数字和。接着,直接进行一个拼接,如图所示:
容易发现就是把横向和竖向跳的 \operatorname{lowbit}(x) 给拼了起来!所以查询的时候可以直接把一重循环改成二重循环。修改的时候类似,同样把一重循环改成二重循环即可。依然等同于暴力的代码长度。
struct BIT {
    int s[N][N];
    void update(int x, int y, int k) {
        int j;
        for(;x <= n; x += lowbit(x)) {
            for(j = y; j <= m; j += lowbit(j)) s[x][j] += k;
        }
    }
    int query(int x, int y) {
        int ret = 0, j;
        for(;x > 0; x -= lowbit(x)) {
            for(j = y ; j > 0; j -= lowbit(j)) ret += s[x][j];
        }
        return ret;
    }
};
由于对于 x, y 分别做了 O(\log n) 代价的遍历,所以一次操作复杂度是 O(\log^2 n) 的。
练习题:
::::success[题解]
计数问题
大炮打蚊子的来了。大家可以自行思考黄题难度的做法。本题复杂度分析认为 n,m 同阶。
由于只有 100 种元素,开 100 个二维树状数组维护即可,容易做到时间复杂度 O(Q\log^2 n) ,空间复杂度 O(cn^2) 。
上帝造题的七分钟
比较纯粹的一个二维树状数组,还是要推一定的式子。首先对于数组做二维差分,得到差分数组 s ,把关于 (a,b,c,d) 的询问拆成 (1,1,a-1,b-1) ,(1,1,a-1,d) ,(1,1,c,b-1) ,(1,1,c,d) 四个询问。那么对于查询,就可以这么推式子:
\begin{aligned}&\sum^{x}_{i=1}\sum^{y}_{j=1}a_{x,y}\\=&\sum^{x}_{i=1}\sum^{y}_{j=1}\sum^{i}_{k=1}\sum^{j}_{l=1}s_{k,l}\\=&\sum^{x}_{i=1}\sum^{y}_{j=1}s_{i,j}(x-i+1)(y-j+1)\\=&xy\sum^{x}_{i=1}\sum^{y}_{j=1}s_{i,j}-x\sum^{x}_{i=1}\sum^{y}_{j=1}(j-1)s_{i,j}-y\sum^{x}_{i=1}\sum^{y}_{j=1}(i-1)s_{i,j}+\sum^{x}_{i=1}\sum^{y}_{j=1}(i-1)(j-1)s_{i,j}&\end{aligned}
具体过程类似于【模板】线段树 1 的式子拆解方法,在此不做解释。那么我们就发现这道题需要维护四个二维树状数组。
设 q 为操作数,那么时间复杂度为 O(q\log^2n) 。
9.4 逆序对
首先我们为了解决这个题,需要知道一个东西,叫做权值树状数组。其实这个跟普通的树状数组区别不大,只不过普通树状数组维护的是序列 ,而权值树状数组维护的是值域 。
首先先给出模板题。简化题意如下:
给出序列 a ,求满足 i<j\land a_i>a_j 的 (i,j) 对数。
这个东西可以用归并排序求,也可以用树状数组求。本章讲解的显然是用树状数组求啦。
首先我们设 f(x)=\sum^{x-1}_{i=1}[a_i>a_x] ,那么答案显然为 \sum^{n}_{i=1}f(i) 。所以我们考虑怎么高效的求出 f(i) 。首先我们可以尝试维护一个集合 S ,然后把序列从前往后扫描。每一次扫描到一个数 x 的时候,首先求 \sum_{v\in S} [v>x] ,容易发现这个值就是 f(x) 。接着,我们把 x 加入 S 中。
那么关键就来到了如何维护一个集合,支持添加元素,查询比一个元素大的元素个数。这个东西,恰好可以使用权值树状数组 来维护。每一次添加一个元素 x ,就是对于 x 做单点加一,查询比它大的元素就是查询 [x+1, V] 的和,其中 V 是值域。
这道题目的值域太大了,有 10^9 ,树状数组开不下。但是注意到元素只有相对大小有用,所以可以把序列离散化,这样值域就变成 O(n) 的了。那么本题可以做到 O(n\log n) 。下面给出完整代码:
::::success[code]
#include <bits/stdc++.h>
#define int long long
#define endl '\n'
using namespace std;

const int N = 5e5 + 5;
int n, a[N], c, temp[N], ans;

struct BIT {
    int t[N];
    int lowbit(int x) { return x & -x; }
    void update(int x, int v) {
        for(; x <= c; x += lowbit(x)) t[x] += v;
    }
    int query(int x) {
        int res = 0;
        for(; x; x -= lowbit(x)) res += t[x];
        return res;
    }
} T;

void lsh() {
    for(int i = 1; i <= n; i ++ ) temp[i] = a[i];
    sort(temp + 1, temp + n + 1);
    c = unique(temp + 1, temp + n + 1) - temp - 1;
    for(int i = 1; i <= n; i ++ )
        a[i] = lower_bound(temp + 1, temp + c + 1, a[i]) - temp;
}

signed main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n;
    for(int i = 1; i <= n; i ++ ) cin >> a[i];
    lsh();
    for(int i = 1; i <= n; i ++ ) {
        ans += T.query(c) - T.query(a[i]);
        T.update(a[i], 1);
    }
    cout << ans << endl;
    return 0;
}
::::
练习:
小杨的握手问题
最接近神的人
三元上升子序列
楼兰图腾
火柴排队
::::success[题解]
小杨的握手问题
认真读题可以发现等价于求逆序对。
最接近神的人
根据经典结论,交换相邻两个数把序列排序的最小次数等价于逆序对数。
于是求出数组逆序对即可。
三元上升子序列
我们可以枚举中间节点 j ,前面的 i 和后面的 k 可以两两配对。所以我们需要求出如下的两个值:
f(x)=\sum^{x-1}_{i=1}[a_i<a_x]\\g(x)=\sum^{n}_{i=x+1}[a_i>a_x]
显然都可以仿照求逆序对的方法用树状数组求。答案显然为 \sum^{n}_{i=1}f(i)g(i) 。
楼兰图腾
还是跟上一道题一样,枚举中间节点。这个题求的复杂一点,但是主题思想不变。容易发现可以设如下的式子:
f_p(x)=\sum^{x-1}_{i=1}[a_i<a_x]\\g_p(x)=\sum^{x-1}_{i=1}[a_i>a_x]\\f_s(x)=\sum^{n}_{i=x+1}[a_i<a_x]\\g_s(x)=\sum^{n}_{i=x+1}[a_i>a_x]
同样使用树状数组求解这四个值。然后,尖刀图腾的数量就是 \sum^{n}_{i=1}g_p(i)g_s(i) ,铁锨图腾的数量就是 \sum^{n}_{i=1}f_p(i)f_s(i) 。
火柴排队
首先发现假如 a_i 排名为 x 的数正好对应的 b_i 排名也是 x ,那么这个方案就是最优秀的。证明是简单的,通过一些简单的初中数学就可以知道,对于这个排法假如交换两个位置上的数,那么总和一定会增加。
然后我们发现固定 a 或者 b 不动一定是最优的。否则的话,交换次数等价于把 b 先交换成 a ,然后再整体交换成我们给定的大小顺序,显然不优秀。然后将 a 的大小顺序交换为 b 和将 b 交换为 a 是等价的,我们只需要把每一次对于 a 数组的交换改成对于 b 数组的交换就可以得到从 b 交换到 a 与从 a 交换到 b 等价的方案了。
我们考虑固定 a ,然后对于 b 赋权。我们希望将 b_j 交换到的位置为 i ,那么就将 d_j 赋权为 i ,然后求出 d 的逆序对数,就是答案。
具体求出 d 的方法就是将 a, b 离散化后首先求出 c 数组,c_i 表示 i 在 a 中的位置。然后 d_i 就等价于 c_{b_i} 了,这样就可以直接求逆序对了。
*9.5 树状数组倍增
首先用一道例题来引出这个算法。首先我们认为 set 是大常数的东西,所以不用这个 STL。
首先,对于这道题,假如我们只做插入和求排名的话,是非常简单的,仿照之前逆序对的做法,使用一个权值树状数组维护值域即可,记得离散化。
但是这个题需要求的是 k 大,而不是排名。但是,我们可以通过简单方法转化为排名:我们二分这个值,然后假如比它大的数多于 k ,就证明目前的答案小了,否则大了。这样很容易使用树状数组维护,得到一个 O(\log^2n) 单次询问的做法,虽然能够过这道题,但是万一别的题卡掉了这个复杂度,必须 O(\log n) 呢。所以我们需要优化这个做法。
首先树状数组的结构非常特殊,完全不是任何和二分类似的结构,所以直接在树状数组的结构上二分应该是没救的。但是,二分不止有二分一种写法,还有倍增的写法!具体做法是根据每个数都可以二进制拆分的性质,从高位到低位依次考虑二进制这一位是多少,假如可以填 1 就填 1 ,否则填 0 。容易发现这样做是等价于正常二分的。
然后这个类似倍增的二分就可以套到树状数组上去了。因为一个非常优美的性质:倍增每一次都是在最后一位试图填 1 ,而在最后一位填的 1 正好对应 \operatorname{lowbit} 。因此,假设我们目前倍增到的右端点是 p ,要访问 p+2^k 的值,那么 t_{p+2^k} 就正好等于区间 [p+1,p+2^k] 的信息,直接将其合并就可以得到新区间的信息,就不需要在树状数组上单独开查询了。因此树状数组的查询 O(\log n) 被优化掉了,复杂度只有 O(\log n) 单次询问了。
对于本题,我们查询的是 k 大而不是 k 小,树状数组是没法倒着倍增的(因为自身结构是严格维护它前面的信息),所以我们需要把问题转化为正着倍增。具体转化是比较简单的,比如可以转化为 |S|-k+1 小,或者正着倍增,但是维护的是整体之和减去前缀和就可以了。因此代码实现是简单的。树状数组小常数,甚至没有任何卡常就吊打一众权值线段树平衡树 set,成为了最优解第一页(截止 2026-9-9 20:00)。
::::success[code]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

const int N = 2e5 + 5;
int n, q, v[N], op[N], w[N], temp[N], c;

void lsh() {
    int tot = 0;
    for(int i = 1; i <= n; i ++ ) temp[ ++ tot] = v[i];
    for(int i = 1; i <= q; i ++ ) if(op[i] == 2) temp[ ++ tot] = w[i];
    sort(temp + 1, temp + tot + 1);
    c = unique(temp + 1, temp + tot + 1) - temp - 1;
    for(int i = 1; i <= n; i ++ )
        v[i] = lower_bound(temp + 1, temp + c + 1, v[i]) - temp;
    for(int i = 1; i <= q; i ++ )
        if(op[i] == 2) w[i] = lower_bound(temp + 1, temp + c + 1, w[i]) - temp;
}

struct BIT {
    int t[N], sum;
    int lowbit(int x) { return x & -x; }
    void update(int x, int v) {
        sum += v;
        for(; x <= c; x += lowbit(x)) t[x] += v;
    }
    int qkth(int x) {
        int su = 0, ans = 0;
        for(int k = __lg(c); k >= 0; k -- ) {
            int np = ans + (1 << k);
            if(np > c) continue;
            if(sum - (su + t[np]) >= x) {
                ans = np;
                su += t[np];
            }
        }
        return ans + 1;
    }
} T;

int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> q;
    for(int i = 1; i <= n; i ++ ) cin >> v[i];
    for(int i = 1; i <= q; i ++ ) cin >> op[i] >> w[i];
    lsh();
    for(int i = 1; i <= n; i ++ ) T.update(v[i], 1);
    for(int i = 1; i <= q; i ++ ) {
        if(op[i] == 1) cout << temp[T.qkth(w[i])] << endl;
        else T.update(w[i], 1);
    }
    return 0;
}
::::
然后是练习:
可能还有一些可以树状数组倍增的题放在了线段树二分章节。
::::success[题解]
冰火战士
容易发现冰系战士的实力是关于温度的一个前缀和,火系战士的实力是关于温度的一个后缀和。这个东西,直接树状数组维护即可。
看到值域很大果断离散化,但是这里必须把冰系战士和火系战士的温度放在一起离散化,否则会因为树状数组下标对不上出现一些问题。
在这里,冰系战士实力单调不减,火系战士实力单调不增,于是消耗的能量值(两者最小值的两倍)构成了一个单峰有台函数,由于有台所以不能三分,但是可以想出来一个替代:二分出比火系能量比冰系大的最后一个节点,以及二分出冰系能量比火系大的第一个节点。
这个二分显然不能直接做,树状数组倍增即可,O(n\log n) 。出题人似乎卡常掉了其它的所有大常数写法。
【模板】普通平衡树
一想到这道题将会被使用很多种不同的算法,轮番吊打我就想笑。但是这里讲解的确实是常数最小的做法。
首先使用权值树状数组来维护这个集合是显然的,因为有两个操作和例题一样。可以离散化,也可以不离散化。那么添加元素就是单点加一,删除元素就是单点减一。操作 3 其实就是查询 [x+1,V] 的和加一,操作 4 同样直接做树状数组二分即可。
操作 5 可以首先求出 [x,V] 中一共有多少个数,记为 r ,然后查询排名为 r+1 的数就可以了,这显然是操作 4 。操作 6 类似,求出 [x+1,V] 中有多少个数,记为 r ,然后查询排名为 r 的数。
由于有负数,可以将所有数整体加上 10^7 。时间复杂度 O(n\log n) 。
10. ST 表
10.1 基本概念
ST 表可以支持如下的操作:预处理 O(n\log n) ,区间 O(1) 查询满足结合律,幂等律 的信息。
幂等律是什么呢?设运算为 \oplus ,那么 a\oplus a=a 的时候,称 \oplus 为有幂等律的。比如 \max, \min, \gcd ,按位与,按位或之类的运算。
ST 表基于一个常识:每一个区间都可以被两个长度为 2^k 的区间给完全覆盖(允许重叠)。这个证明是简单的,令 k 为最大的 2^k\leq n ,那么 2^{k+1}=2\times 2^k>n ,也就是可以完全覆盖。所以我们可以预处理出所有长度为 2^k 的区间的信息,然后每一次拿出来两个区间就可以算出答案了。在这里幂等律是必要的,因为重叠的那一部分区间必须不影响结果。
具体做法可以这么处理:设 st_{i,j} 表示 [i,i+2^j-1] 的信息,那么可以写出一个类似动态规划的式子:
st_{i,j}=st_{i,j-1}\oplus st_{i+2^{j-1},j-1}
也就相当于利用已经处理过的区间当做左右半边,把这个区间给拼了出来。初始值显然是 st_{i,0}=a_i ,其中 a 是初始化的数组。
每一次查询的时候,我们都需要知道左右半边的区间,那么首先可以算出应该的区间长度,设查询区间为 [l, r] ,区间长度也就是 2^{\lfloor\log_2(r-l+1)\rfloor} ,ST 表的第二维应该是 k=\lfloor\log_2(r-l+1)\rfloor 。
首先显然左半边区间是 st_{l,k} 。右半边区间可以这么算:解方程 x+2^k-1=r ,解得 x=r-2^k+1 。于是答案就是 st_{l,k}\oplus st_{r-2^k+1,k} 。
那么差不多理论就这些了。
10.2 代码实现
大概就是朴素的使用二维数组 st 来动态规划吧。我觉得大部分实现细节在上面都讲清晰了。就是要注意一些边界情况,避免出现一些值改加减一的没有加减导致的错误。
使用模板题的求区间 \max 来给出代码。
struct ST_table {
    int st[N][22], lg2[N];
    void init(int n, int a[]) {
        for(int i = 2; i <= n; i ++ ) lg2[i] = lg2[i / 2] + 1;
        for(int i = 1; i <= n; i ++ ) st[i][0] = a[i];
        for(int i = 1; i <= lg2[n]; i ++ )
            for(int j = 1; j <= n - (1 << i) + 1; j ++ )
                st[j][i] = max(st[j][i - 1], st[j + (1 << (i - 1))][i - 1]);
    }
    int query(int l, int r) {
        int k = lg2[r - l + 1];
        return max(st[l][k], st[r - (1 << k) + 1][k]);
    }
};
还是很短对吧。下一章就没这么短了。模板题的完整实现如下:
::::success[code]
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;

const int N = 1e5 + 5;
int n, m, a[N];

struct ST_table {
    int st[N][22], lg2[N];
    void init(int n, int a[]) {
        for(int i = 2; i <= n; i ++ ) lg2[i] = lg2[i / 2] + 1;
        for(int i = 1; i <= n; i ++ ) st[i][0] = a[i];
        for(int i = 1; i <= lg2[n]; i ++ )
            for(int j = 1; j <= n - (1 << i) + 1; j ++ )
                st[j][i] = max(st[j][i - 1], st[j + (1 << (i - 1))][i - 1]);
    }
    int query(int l, int r) {
        int k = lg2[r - l + 1];
        return max(st[l][k], st[r - (1 << k) + 1][k]);
    }
} S;

int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> m;
    for(int i = 1; i <= n; i ++ ) cin >> a[i];
    S.init(n, a);
    while(m -- ) {
        int l, r;
        cin >> l >> r;
        cout << S.query(l, r) << endl;
    }
    return 0;
}
::::
然后是一些练习题:
忠诚
gcd 区间
最大数
01 序列
船
萌萌哒
::::success[题解]
忠诚,gcd 区间
显然 \min, \gcd 满足结合律和幂等律,所以直接 ST 表维护即可。
时间复杂度 O(n\log n) ,gcd 区间朴素实现是 O(n\log n\log V) 的,但是有一些比较牛的科技可以做到亚线性预处理,O(1) 查询 gcd。当然那个科技太难了,而且是数论方面的,暂不讨论。
最大数
ST 表这个东西显然不支持修改,但是它可以从后面插入。
因为你发现,在后面插入的时候,前面的 st 数组都不受到影响,我们只需要处理出右端点为新插入的数的 st 数组了。这个问题可以类似于预处理 ST 表的 DP 做,每一次插入一个新的数就把 \log n 层新更新一遍。
那么就可以做到 O(m\log m) 了。
01 序列
首先我们注意到这是一个 01 序列,所以最长上升子序列肯定是长度为 2 的 01 ,或者不存在 01 那么长度只能为 1 。这个是简单的,把所有 01 开头的位置存下来,然后二分找到对应的左右端点在序列中的位置,如果位置相同那么就不存在 01 ,否则存在。
最长不下降子序列肯定形式是一段 0 接上一段 1 。所以我们对于每一个点可以维护从这一个点往前最长的一段 0 (记为 f_i ),以及往后最长的一段 1 (记为 g_i ),这个显然可以线性时间复杂度 DP 预处理。
然后我们就可以对于一个区间求解 \max f_i+g_i ,就是最长不下降子序列的长度了。但是前面有一段 0 可能被吃掉了,所以跟前面处理出的长度减一下,然后分类讨论这段 0 是不是最靠前的一段 0 就可以了。
船
首先我们发挥注意力,假如序列长度是偶数,那么肯定是配对出若干长度为 2 的上升子序列是最优的(否则你多拿一个数只会增加构造难度),具体的,序列排序后,肯定选择 A_i 和 A_{i+\frac{n}{2}} 是最优的,否则假如你交换配对,最小值必定变小。
然后假如是奇数就必须存在长度为 3 的三元上升子序列。然后存在至少两个长度为 3 的三元上升子序列就是不优秀的,因为 (a,b,c),(d,e,f) 可以排序之后规约为 n 为偶数的情况。
然后问题来到了找三元上升子序列。一种简单的方法是枚举两个数,然后判断是否存在第三个数,可以直接哈希表做到 O(n^2) 。然后你会发现三元上升子序列的个数也是 O(n^2) 的,所以你必须做到 O(1) 状物查询。
我们发现一个三元上升子序列只会把元素平移 3 位。因此,可以使用四个 ST 表,分别维护 \min a_i-a_{i-1} ,\min a_i-a_{i-2} ,\min a_i-a_{i-3} ,\min a_i-a_{i-4} 。然后我们就可以使用一个超级构式的分讨,来查询这很多种情况中的最小值了。这个分讨全都是体力活,大家应该可以自己手推,我就不说了,因为具体过程很长。
萌萌哒
ST 表的另一种用法。
ST 表不仅可以把一个区间拆成两个相交的区间,还可以把一个区间拆成 \log n 个不相交的区间。具体做法如下:
类似倍增。我们从高到低考虑二进制位次,并且维护现在所在的左端点指针 p 。如果 p+2^k-1 还在区间内,那么肯定可以拆出来一个区间 st_{p,k} ,然后 p\leftarrow p+2^k 。由于每一个数都是可二进制拆分的,所以这样一定可以拆出来 \log n 个不交的区间。
在这里,我们显然需要使用并查集进行一个维护,因为涉及集合的合并,以及判断相等。暴力做法是显然的,就是区间节点两两合并,但是这样显然太暴力了,于是,我们考虑利用上述 ST 表区间拆分的性质来优化。
于是我们定义 st_{i,j} 为 i 为左端点的集合,向右 2^j 个数所在集合的根的左端点。于是每一次合并操作的直接合并相对应的上层区间,最后对于每一个合并标记下传即可。具体的,每一次将每一个 ST 表节点的左右两边做合并就可以了,也就是合并 st_{i,j-1} 和 st_{i+2^{j-1}-1,j-1} 。
那么总时间复杂度 O(n\alpha(n)\log n) 。感觉这是一个比较好的 Trick,但是这个东西在大多数情况下(只需要使用到拆分为 \log n 个区间的性质的时候)都可以被线段树给上位平替。虽然这个题线段树没法做,因为我们需要每个点为左端点的区间。
11. 线段树
那个在洛谷 \geq 绿的模板题提交次数最多的题目,那个所有数据结构模板题里面提交最多的题目,那个在洛谷上拥有二创最多的题目,那个成为中高级 OIer 的门槛,那个……毋庸置疑!
11.1 基本概念
本章除法运算默认向下取整 。
线段树基于区间划分,以及树形结构。由于二叉树是一种非常优秀的结构,可以优化很多东西到 O(\log n) ,所以我们直接考虑让序列上树。具体的,根节点代表的区间是 [l,r] ,每一个节点的左右儿子是 [l, \frac{l+r}{2}] 和 [\frac{l+r}{2}+1,r] ,叶子结点 l=r 。比如说,我们对于区间 [1,6] 建一棵线段树,就长这样:
然后考虑这棵树有什么用。首先尝试做查询。我们可以从根节点开始递归,递归到节点 x 的时候,做如下判断:
假如 x 所在的区间被查询区间完全包含,那么我们直接返回这个区间代表的信息。
假如 x 所在的区间和查询区间完全不交,那么我们返回单位元。
否则,递归两边子树。
看起来这样可以很好的做区间查询。举一个例子,设序列 a=\{1, 1, 4, 5, 1, 4\} ,查询 [3, 5] 的区间和。
其中黄色节点是被访问了的节点。其中,在 [1, 2], [6, 6] 这两个节点因为完全不交返回了,在 [3, 3], [4, 5] 这两个节点返回了区间和。可以发现正确的计算了区间和 10 。但是这一次询问几乎遍历了整棵树,这样复杂度真的是对的吗?复杂度是对的。证明如下:
首先给出结论:每一层被访问的节点数量不超过 4 个。那么这个结论的依据就是上一层只有最多两个节点递归了左右儿子。于是我们分类讨论:
上一层递归的节点只有一个节点包含了整个查询区间。那么只有这个节点会递归两边。
上一层递归的节点有两个节点分别包含了查询区间的一部分。那么这两个节点都会递归两边。
上一层多余两个节点包含了区间的一部分。我们会发现上一层所有节点区间的并在值域上是连续的,所以位于最左边和左右边的两个节点才部分被查询区间包含,中间的所有区间都被查询区间全部包含了。所以只有两个区间会递归两边的儿子。
于是得证。每一层的访问节点数最多是 4 ,线段树的树高是 O(\log n) 的(每一层区间长度减半)所以时间复杂度是 O(\log n) 的。并且这个查询需要信息满足的条件很少:
具有结合律。
具有单位元。其实这一部分不是必要的,我们加一个 bool 变量表示这个是不是单位元就可以了。
但是线段树这么优秀的结构肯定不会止步于区间查询。首先发现线段树支持单点修改。直接递归到某个节点,然后把这个节点的信息改了,一路向上更新信息就可以了。
线段树还支持区间修改,只要是可以快速维护区间经过某种修改之后的信息就可以了。比如说,加法和区间求和,区间 \max 这些都是可以区间修改的。我们以加法和区间求和为例吧。令区间的长度为 l ,原本的和为 v' ,加上的数为 x ,那么新的数 v=v'+xl ,这个是很容易计算的。
我们创立一个概念:懒标记 。它起到一个“暂存”的作用。具体原理如下:我们目前不需要知道具体信息的节点,为什么要在修改的时候全部更新了呢?我们只需要先记录一下这个节点到底需要哪些更新,然后在需要这个节点正确信息的时候再去更新这个节点信息就可以了。
所以说,每一次做区间修改的时候,可以这样:
假如当前节点被修改区间完全包含,那么在这个节点上打一个懒标记,更新这个节点的信息,然后返回。
假如当前节点和修改区间完全不交,那么直接返回。
假如当前节点和修改区间部分有交,那么递归两边节点,修改完之后再更新这一个节点的信息。
时间复杂度证明与区间查询类似。但是我们需要注意一件事情:
假如我们修改或者查询的时候,假如这个节点已经被修改过了,但是懒标记积压在上面,那么返回的信息是错误的,假如是修改的话父节点也会被错误的更新,最后整棵树的信息错完了。所以我们需要保证每一个访问到的节点信息都是正确的,所以需要一个操作:下传标记 。
假设我们已经对 [2, 5] 执行了一次区间加 2 操作,其中节点的蓝色数字表示懒标记。由于叶子的懒标记没什么用所以没写。现在我们希望查询区间 [5, 6] 的和,我们现在已经递归到 [4, 5] 这个节点了。
假如我们现在不下传标记,那么查询到的 [5,5] 区间和就会错误,得到的区间和也就错了。然后下传方式其实是比较简单的,就是把这个节点的左右孩子都按照 v'=v+xl 这个方法更新就可以了,然后不要忘记,下传之后这个标记就没用了,然后这个标记也不应该被再次下传,所以要清零。同时,也要更新左右孩子的标记,注意标记是累加而不是赋值,因为儿子还可能有待下传的标签,显然是不能吃掉的。
标记下传是 O(1) 的,所以说,标记下传并不改变时间复杂度。所以我们的线段树是非常强大的一个数据结构,可以做 O(\log n) 区间查询,O(\log n) 单点修改,O(\log n) 做可以快速更新区间答案的区间修改。其实后文“势能线段树”还可以让线段树支持更多的区间修改。
11.2 代码实现
本章实现的线段树基于模板题。
首先考虑怎么存储线段树。线段树是一棵二叉树,所以采用存储普通的二叉树的方法存储显然是没有问题的,每个节点记录左右孩子。但是这样写常数比较大,其实有好一点的方法:我们注意到线段树接近于一棵完全二叉树,所以我们可以直接采用 2x 和 2x+1 来表示这个节点的左右儿子,所以一个数组存储信息就够了。
这样存储需要开多少数组呢?树高是 \lfloor\log_2n\rfloor+1 的,所以我们开的数组大小也应该是 2^{\lfloor\log_2n\rfloor+2} 的。当然有的时候情况会比较坏(n=2^k+1 的时候最坏),有的时候情况会比较好(n=2^k 的时候),但是肯定有一个上界是 4n ,所以通常开 4n 就够了。当然,也可以对于常见的数据范围记一下,n=10^6 的时候开 2097152=2^{21} 就可以了,n=10^5 的时候开 2^{18}=262144 就可以了。所以先给出一些基本的东西:
#define lc(x) (x << 1)
#define rc(x) (x << 1 | 1)
int sum[N << 2], lazy[N << 2];

void pushup(int x) { sum[x] = sum[lc(x)] + sum[rc(x)]; }
void addtag(int l, int r, int x, int v) {
    sum[x] += (r - l + 1) * v;
    lazy[x] += v;
}
其中函数的意义相信大家是清晰的,这一部分比较显然,解释略过。然后是线段树的建树:
void build(int l, int r, int x, int a[]) {
    if(l == r) {
        sum[x] = a[l];
        return;
    }
    build(l, l + r >> 1, lc(x), a);
    build((l + r >> 1) + 1, r, rc(x), a);
    pushup(x);
}
其中 l, r 表示当前节点区间为 [l, r] ,编号为 x ,需要初始化的数组是 a 。然后由于 C++ 的历史遗留问题,传数组传的是指针,所以不会每一次把 n 个元素传下去然后炸掉。如果用 vector 初始化的话记得传引用。
假如到了叶子,我们应该赋值当前节点为序列中这个位置的值。除此之外,这个节点的左右孩子都应该被正确更新了,这个节点直接合并左右孩子的信息即可。然后下传标记。
void push_down(int l, int r, int x) {
    if(lazy[x]) {
        addtag(l, l + r >> 1, lc(x), lazy[x]);
        addtag((l + r >> 1) + 1, r, rc(x), lazy[x]);
        lazy[x] = 0;
    }
}
其实是容易的,直接对于左右孩子打上标记再清零自身标记就可以了。注意打标记函数是同时更新了 lazy 的,自己写的时候不要漏了。
接下来看修改。
void update(int l, int r, int x, int ul, int ur, int v) {
    if(ul <= l && r <= ur) {
        addtag(l, r, x, v);
        return;
    }
    if(l > ur || ul > r) return;
    push_down(l, r, x);
    update(l, l + r >> 1, lc(x), ul, ur, v);
    update((l + r >> 1) + 1, r, rc(x), ul, ur, v);
    pushup(x);
}
其实还是比较容易理解的,具体干的事情在院里介绍部分都说明白了。这里提醒一定不要漏了 push_down,并且区间的包含和不交判断不要写错或写反。
最后是查询部分,其实我感觉这个代码还是比较巧妙的。
int query(int l, int r, int x, int ql, int qr) {
    if(ql <= l && r <= qr) return sum[x];
    if(l > qr || ql > r) return 0;
    push_down(l, r, x);
    return query(l, l + r >> 1, lc(x), ql, qr)
        + query((l + r >> 1) + 1, r, rc(x), ql, qr);
}主要的妙处是巧妙的利用了递归的特性,把返回左右子树查询值之和给写到了一行之内。注意事项和修改大致相同。所以线段树差不多就写完了!好吧有点长。
模板题的完整实现如下:
::::success[code]
#include <bits/stdc++.h>
#define int long long
#define rep(i, l, r) for(int i = l; i <= r; i ++ )
#define endl '\n'
using namespace std;

const int N = 1e5 + 5;
struct Segment_Tree {
    #define lc(x) (x << 1)
    #define rc(x) (x << 1 | 1)
    int sum[N << 2], lazy[N << 2];

    void pushup(int x) { sum[x] = sum[lc(x)] + sum[rc(x)]; }
    void addtag(int l, int r, int x, int v) {
        sum[x] += (r - l + 1) * v;
        lazy[x] += v;
    }
    void push_down(int l, int r, int x) {
        if(lazy[x]) {
            addtag(l, l + r >> 1, lc(x), lazy[x]);
            addtag((l + r >> 1) + 1, r, rc(x), lazy[x]);
            lazy[x] = 0;
        }
    }

    void build(int l, int r, int x, int a[]) {
        if(l == r) {
            sum[x] = a[l];
            return;
        }
        build(l, l + r >> 1, lc(x), a);
        build((l + r >> 1) + 1, r, rc(x), a);
        pushup(x);
    }

    void update(int l, int r, int x, int ul, int ur, int v) {
        if(ul <= l && r <= ur) {
            addtag(l, r, x, v);
            return;
        }
        if(l > ur || ul > r) return;
        push_down(l, r, x);
        update(l, l + r >> 1, lc(x), ul, ur, v);
        update((l + r >> 1) + 1, r, rc(x), ul, ur, v);
        pushup(x);
    }

    int query(int l, int r, int x, int ql, int qr) {
        if(ql <= l && r <= qr) return sum[x];
        if(l > qr || ql > r) return 0;
        push_down(l, r, x);
        return query(l, l + r >> 1, lc(x), ql, qr)
            + query((l + r >> 1) + 1, r, rc(x), ql, qr);
    }
} T;

int n, m, a[N];

signed main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> m;
    rep(i, 1, n) cin >> a[i];
    T.build(1, n, 1, a);
    rep(i, 1, m) {
        int op, l, r, v;
        cin >> op >> l >> r;
        if(op == 1) {
            cin >> v;
            T.update(1, n, 1, l, r, v);
        } else cout << T.query(1, n, 1, l, r) << endl;
    }
    return 0;
}
::::
然后给出一些练习题:
【模板】线段树 2
扶苏的问题
无聊的数列
Barn Allocation
方差
区间加区间 sin 和
排序
由乃与大母神原型和偶像崇拜
::::success[题解]
【模板】线段树 2
重点在于怎么维护两个操作。首先显然应该在节点上维护加法标记和乘法标记。记加法标记为 x ,乘法标记为 y ,这个节点原本区间和为 v' ,长度为 l ,那么有 v=yv'+lx 。所以我们维护的应该是一个节点 v\leftarrow v'y+x 。
因此添加乘法标记的时候也要对加法标记给乘上 y ,但是添加加法标记的时候不要对乘法标记操作。下传标记的时候,要先下传乘法,然后下传加法。
扶苏的问题
显然维护覆盖标记和加法标记。那么覆盖标记就是对于最大值赋值,加法标记就是对最大值做加法。
打标记的时候,假如覆盖,就把加法标记清零。瞎传的时候,先下传覆盖再下传加法。
到了这里也可以总结一下线段树下传标记的顺序了。首先下传优先级高的运算,然后下传优先级低的运算。
无聊的数列
直接做似乎是难以维护的。但是注意到这里只有单点查询,所以可以差分变成前缀查询。
差分之后,区间加一段等差数列就变简单了。直接将 l\sim r 的数全部加上 d ,然后将 r+1 减去 d(r-l+1) 就可以了。
Barn Allocation
首先想一个贪心策略,就是类似线段覆盖的做法,按照右端点从小到大排序,这样可以让后面尽可能多的选进来,这样显然是最优的。
然后我们的问题来到了维护一个线段能否被加入。有如下的方法:首先对于所有点赋权 -c_i ,然后每次加入一个区间就是区间加 1 。这样能否加入区间就变成了区间最大值是否 \leq -1 的问题,也就是是不是每一个位置都有空闲的容量。
区间加,区间最大值显然可以使用线段树维护。
方差
乍一看方差这个东西并不好维护,因为式子比较复杂。但是我们可以通过拆式子使其变为容易维护的形式。后文记区间平均值为 \overline{A} ,区间长度为 l 。
\begin{aligned}&\sum(a_i-\overline{A})^2\\=&\sum(a_i^2+2a_i\overline{A}+\overline{A}^2)\\=&l\overline{A}^2+2\overline{A}\sum a_i+\sum a_i^2\end{aligned}
这样大概明确了,区间平均值可以直接维护区间和求得,那么维护区间和,区间平方和就可以了。但是平方和一看也不太好做啊,所以还是拆式子,假设区间操作是 +v 。
\begin{aligned}&\sum(a_i+v)^2\\=&\sum(a_i^2+2a_iv+v^2)\\=&v^2l+2v\sum a_i+\sum a_i^2\end{aligned}
所以我们发现我们可以使用区间和以及之前的区间平方和来更新区间平方和,记之前的 区间和为 s' ,平方和为 q' ,那么有 q\leftarrow q'+2vs'+v^2l 。
那么这下就可以维护了,记录加法标记,按照上述式子处理区间加,计算方差即可。然后这个题不卡精度是好的。
区间加区间 sin 和
依旧推式子。首先直接下传显然是困难的。注意到这里有三角函数,所以我们直接使用和角公式:
\sin(\alpha+\beta)=\sin(\alpha)\cos(\beta)+\sin(\beta)\cos(\alpha)\\\cos(\alpha+\beta)=\cos(\alpha)\cos(\beta)-\sin(\alpha)\cos(\beta)
所以我们想要维护 sin 和,必定需要维护 cos 和。但是具体如何维护呢?我们还是发挥传统艺能,拆式子。记区间长度为 l 。
\begin{aligned}&\sum\sin(a_i+v)\\=&\sum(\sin(a_i)\cos(v)+\sin(v)\cos(a_i))\\=&\cos(v)\sum\sin(a_i)+\sin(v)\sum\cos(a_i)\end{aligned}
\begin{aligned}&\sum\cos(a_i+v)\\=&\sum(\cos(a_i)\cos(v)-\sin(a_i)\sin(v))\\=&\cos(v)\sum \cos(a_i)+\sin(v)\sum\sin(a_i)\end{aligned}
那么拆到这里应该大家都知道怎么维护了,记录区间 \cos 和和 \sin 和,维护区间加标记,按照上面式子做就可以了。
排序
这道题和后面一道题都稍微偏思维,主要是为了让大家初探线段树的高阶用法。
这个题直接维护序列是可以的,但是需要复杂且超纲的线段树分裂合并,所以我们认为直接维护这个序列没有前途。那么我们尝试简化问题:假设序列只有 0/1 ,那么该怎么维护?
其实这个区间排序是简单的,0 给全部移到了最前面,把 1 移到了后面。那么我们需要的就是区间 1 的个数,维护区间和即可,然后对于区间前面一段覆盖 0 ,后面一段覆盖 1 。所以我们需要区间覆盖和区间求和,这显然可以线段树维护。
然后我们可以拓展一下朴素方法。我们可以直接二分答案,设当前判定的数是 x ,然后将 \geq x 的数赋权为 1 ,<x 的数赋权为 0 ,按照上述方法做区间排序,假如最后这个位置是 1 ,就说明答案 \geq x ,否则就 <x 。因此就可以二分了。
时间复杂度 O(n\log^2 n) 。
由乃与大母神原型和偶像崇拜
这是一道因为太简单被踢出 Ynoi 了的题目。
显然这道题有很多乱搞方式,比如维护区间和,区间平方和,区间最大值,区间最小值,使用最大值和最小值去推导这个区间在值域上应该对应的连续段,然后用区间和和区间平方和去判断是不是这个连续段。这个做法显然是错的并且可以构造数据卡掉,但是出错率很低,然后随便加上一些信息就可以过了。
那我来讲一个比较对的方式吧,基于随机赋权 。就是一个大概是随机哈希的思想,对于每一个数 x 赋予一个权值 v_x ,然后计算 v_x 的前缀和,这样可以快速计算一个连续段中的权值和。然后对于序列的区间也维护最大值最小值用于推导连续段,再维护一个权值和来判断是不是连续段的权值和就可以了。
由于你赋权是随机的,所以直觉上来说只要值域是无限就不可能出错。但是实际上值域不可能做到无限,所以是有概率出错的,只不过概率特别小,可以忽略,所以可以通过本题。具体概率是啥我也不会证。
11.3 左-中-右线段树
这个名字是我自己起的,主要针对线段树中一种特殊的信息维护方式:维护一个区间最左边一段的信息,一个区间最右边一段的信息,以及这的区间自己的最优信息。
这种维护方式可以维护一些比较有趣的东西,比如区间内最长连续颜色段,最大子段和之类的信息。
比如我们以这道题引入。省流就是单点修改,区间最大子段和。首先对于每一个节点只维护一个最大子段和显然是无法合并信息的。
于是我们思考我们漏了哪些信息,发现恰好是经过中点的情况。经过中点的情况,最优的显然是左边和最大的一段后缀加上右边和最大的一段前缀。所以,我们对于区间额外维护和最大的一段前缀 ,以及和最大的一段后缀 。
那么我们思考怎么维护区间和最大的一段前缀。我们需要考虑的有两种情况:前缀跨过中点,或者前缀不跨过中点。前者是左孩子区间的和加上右孩子和最大的一段前缀,后者是左孩子最大的一段前缀。所以我们再维护一个区间和就可以支持合并了。
单点修改的时候直接递归到叶子修改,然后一路合并就可以了。假如区间长度为 1 ,其中这个点的值为 x ,那么显然有:这个点的前缀,后缀,区间最大子段和以及区间和都是 x 。那么代码就容易实现了。但是早期码风,可能看着有点怪怪的。
::::success[code]
#include<bits/stdc++.h>
#define lc(x) (x << 1)
#define rc(x) (x << 1 | 1)
#define endl '\n'
using namespace std;

using i64 = long long;
using u64 = unsigned long long;
using i128 = __int128_t;
using u128 = __uint128_t;

const int N = 5e5 + 5;
const int INF = 0x3f3f3f3f;
struct node { int lef, mid, rit, sum; } t[4 * N];
struct Qans { int l, r, m, s; };
int n, m, a[N];

inline int max(int a, int b, int c)
    { return max(a, max(b, c)); }

void pushup(int x)
{
    t[x].sum = t[lc(x)].sum + t[rc(x)].sum;
    t[x].lef = max(t[lc(x)].lef, t[lc(x)].sum + t[rc(x)].lef);
    t[x].rit = max(t[rc(x)].rit, t[rc(x)].sum + t[lc(x)].rit);
    t[x].mid = max(t[lc(x)].mid, t[rc(x)].mid, t[lc(x)].rit + t[rc(x)].lef);
}

void build(int l, int r, int x)
{
    if(l == r)
    {
        t[x].lef = t[x].mid = t[x].rit = t[x].sum = a[l];
        return;
    }
    build(l, l + r >> 1, lc(x));
    build((l + r >> 1) + 1, r, rc(x));
    pushup(x);
}

void update(int l, int r, int x, int pos, int val)
{
    if(l == r)
    {
        t[x].lef = t[x].rit = t[x].mid = t[x].sum = val;
        return;
    }
    int mid = l + r >> 1;
    if(pos <= mid) update(l, mid, lc(x), pos, val);
    else update(mid + 1, r, rc(x), pos, val);
    pushup(x);
}

Qans query(int l, int r, int x, int ql, int qr)
{
    if(ql <= l && r <= qr) return Qans{t[x].lef, t[x].rit, t[x].mid, t[x].sum};
    if(qr < l || ql > r) return Qans{0, 0, 0, INF};
    Qans lef, rig, ans;
    lef = query(l, l + r >> 1, lc(x), ql, qr);
    rig = query((l + r >> 1) + 1, r, rc(x), ql, qr);
    if(lef.s == INF) return rig;
    if(rig.s == INF) return lef;
    ans.s = lef.s + rig.s;
    ans.l = max(lef.l, lef.s + rig.l);
    ans.r = max(rig.r, rig.s + lef.r);
    ans.m = max(lef.m, rig.m, lef.r + rig.l);
    return ans;
}

int main()
{
    ios :: sync_with_stdio(0);
    cin.tie(0); cout.tie(0);
    cin >> n >> m;
    for(int i = 1; i <= n; i ++ ) cin >> a[i];
    build(1, n, 1);
    for(int i = 1; i <= m; i ++ )
    {
        int k, l, r;
        cin >> k >> l >> r;
        if(k == 1)
        {
            if(l > r) swap(l, r);
            cout << query(1, n, 1, l, r).m << endl;
        }
        else update(1, n, 1, l, r);
    }
    return 0;
}
::::
接下来是一些练习题:
::::success[题解]
染色简化版
首先大家需要明确我们做的不是树上的版本,是拍到一个序列上的版本,我们需要对于一个序列支持区间赋值和区间询问颜色段数。
颜色段数显然是左边的颜色段数加上右边的颜色段数,但是有可能中间可以跨过中点组成一个颜色段,所以我们还需要记录每一个节点最左边的颜色和最右边的颜色,然后合并的时候假如左孩子最右边和右孩子最左边是同色的,那么就将这个点的颜色段数减一。
区间修改的时候直接对于颜色段数改成 1 ,然后最左边和最右边赋值就可以整体更新区间了,所以直接用一个修改标记维护即可。
序列操作
巨大神秘题。
首先显然使用两个标记:覆盖和翻转 ,来记录这个序列被做的修改。然后为了维护这些询问,我们首先得维护区间最长的一段 1 ,以及维护区间的 1 个数。第二个信息是容易合并的,第一个信息我们套用左中右方法。
维护最长的一段前缀 1 ,最长的一段后缀 1 ,和区间最长的一段 1 的长度。然后合并的时候,前缀直接判断左区间是不是全都是 1 ,如果全都是 1 ,那么长度就是左区间长度加上右区间最长前缀 1 ,否则是左区间最长前缀 1 。对于后缀的维护类似,不再赘述。合并的时候就取左区间最大的一段,右区间的最大一段,以及左区间后缀 1 和右区间前缀 1 拼起来的最大值即可。
对于覆盖标记,区间的 1 个数是容易更新的,前缀后缀,最长连续段这个也是容易做的,不多说。对于翻转标记,我们直接对于 0 维护和 1 一样的信息,然后区间翻转的时候把 01 的信息交换即可。由于覆盖的优先级是高于翻转的,所以我们应该先下推覆盖标记再下推翻转标记。
大概思路全部说完了,但是代码是很难写的(应该是我写过最长的青题),大家努力去实现一下代码吧,相信可以提高你的代码实现能力。
*11.4 线段树与矩阵
对于一些复杂的修改,或者一些需要维护神秘信息(比如 DP,或者轮换式)的线段树,使用普通的信息来合并通常难以满足要求,所以我们考虑使用矩阵来维护信息。由于矩阵乘法是满足结合律的,所以和线段树搭配,可以起到很好的效果。
使用一道例题来引入这一个专题。问题就相当于单点修改,求最大权独立集。那么我们令 dp_{i,0} 表示第 i 台不选,[1,i] 最大的挤奶量,dp_{i,1} 表示选择第 i 台机器,[1,i] 区间最大的挤奶量。那么很容易写出朴素的 DP 式子:
\begin{cases}dp_{i,0}=\max(dp_{i-1,0},dp_{i-1,1})\\dp_{i,1}=m_i+dp_{i-1,0}\end{cases}
这个朴素的 DP 式子直接使用线段树维护显然是不好做的。但是我们可以使用矩阵,把这个 DP 写成一个更加优美的形式。具体的,我们令矩阵 M 满足如下性质(其中乘法显然应该为 (\max,+) 矩阵乘法):
\begin{bmatrix}dp_{i,0},dp_{i,1}\end{bmatrix}=[dp_{i-1,0},dp_{i-1,1}]\times M
可以推出来,M 的值为:\begin{bmatrix}0&m_i\\0&-\infin\end{bmatrix} 。具体的推导过程可以这么想:
首先写成这个形式:\begin{aligned}&dp_{i,0}&dp_{i,1}\\dp_{i-1,0}&\ \ \ a&b\ \ \ \\dp_{i-1,1}&\ \ \ c&d\ \ \ \end{aligned}
然后我们的目标是推导出 a, b, c, d ,注意到 a 代表的是 dp_{i-1,0}\to dp_{i,0} 的贡献权值,b,c,d 同理。于是我们稍微差分就可以知道 a=c=0 ,b=m_i 。然后 dp_{i-1,1} 不能对 dp_{i,1} 贡献,所以我们直接调成 -\infin 既可以禁止贡献了。由此可以得到上述矩阵。
于是我们每一次修改的时候直接修改某一个点上矩阵的值,最后查询的时候查询根节点上矩阵的 dp_{i,0} 和 dp_{i,1} ,取 \max 就可以得到答案。注意由于矩阵乘法不具有交换律,所以这里只能左乘右,不能右乘左。
下面给出代码实现,个人认为还是比较好写的。
::::success[code]
#include <bits/stdc++.h>
#define int long long
#define rep(i, l, r) for(int i = l; i <= r; i ++ )
#define endl '\n'
using namespace std;

inline int& chkmax(int &x, int y) { return x = x > y ? x : y; }
inline int& chkmin(int &x, int y) { return x = x < y ? x : y; }

const int N = 40000 + 5;
const int INF = 0x3f3f3f3f3f3f3f3f;
int n, d, m[N], ans;
struct Matrix { int mt[2][2]; } ;

Matrix operator * (Matrix a, Matrix b) {
    Matrix c;
    memset(c.mt, -0x3f, sizeof c.mt);
    rep(i, 0, 1)
        rep(k, 0, 1)
            rep(j, 0, 1)
                chkmax(c.mt[i][j], a.mt[i][k] + b.mt[k][j]);
    return c;
}

struct Segment_Tree {
    Matrix t[N << 2];

    #define lc(x) (x << 1)
    #define rc(x) (x << 1 | 1)
    void pushup(int x) { t[x] = t[lc(x)] * t[rc(x)]; }

    void build(int l, int r, int x, int m[]) {
        if(l == r) {
            t[x].mt[0][0] = 0; t[x].mt[0][1] = m[l];
            t[x].mt[1][0] = 0; t[x].mt[1][1] = -INF;
            return;
        }
        build(l, l + r >> 1, lc(x), m);
        build((l + r >> 1) + 1, r, rc(x), m);
        pushup(x);
    }

    void update(int l, int r, int x, int pos, int v) {
        if(l == r) {
            t[x].mt[0][1] = v;
            return;
        }
        int mid = l + r >> 1;
        if(pos <= mid) update(l, mid, lc(x), pos, v);
        else update(mid + 1, r, rc(x), pos, v);
        pushup(x);
    }
} T;


signed main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> d;
    rep(i, 1, n) cin >> m[i];
    T.build(1, n, 1, m);
    rep(i, 1, d) {
        int p, v;
        cin >> p >> v;
        T.update(1, n, 1, p, v);
        ans += max(T.t[1].mt[0][0], T.t[1].mt[0][1]);
    }
    cout << ans << endl;
    return 0;
}
::::
::::success[题解]
大魔法师
这个题不是 DP,是一个比较综合的线段树维护矩阵题目。首先容易想到维护 [a,b,c] 这样一个行向量表示单个节点的信息。
但是一个 [a,b,c] 向量并不足以维护,因为还有加法操作,这样只使用 [a,b,c] 的话没法做,所以需要维护 [a,b,c,1] 这个行向量。接着推出六个转移矩阵(矩阵乘法为 (+,\times) 矩阵乘法):
火元素激发水元素:
\begin{bmatrix}1&0&0&0\\1&1&0&0\\0&0&1&0\\0&0&0&1\end{bmatrix}
土元素激发火元素:
\begin{bmatrix}1&0&0&0\\0&1&0&0\\0&1&1&0\\0&0&0&1\end{bmatrix}
水元素激发火元素:
\begin{bmatrix}1&0&1&0\\0&1&0&0\\0&0&1&0\\0&0&0&1\end{bmatrix}
水元素能量定值增强:
\begin{bmatrix}1&0&0&v\\0&1&0&0\\0&0&1&0\\0&0&0&1\end{bmatrix}
火元素能量翻倍增强:
\begin{bmatrix}1&0&0&0\\0&v&0&0\\0&0&1&0\\0&0&0&1\end{bmatrix}
土元素能量吸收融合:
\begin{bmatrix}1&0&0&0\\0&1&0&0\\0&0&0&0\\0&0&v&1\end{bmatrix}
然后由于矩阵乘法具有结合律,矩阵乘法和加法具有分配率,所以我们可以对于区间直接维护区间矩阵之和,在懒标记维护区间乘上的矩阵。
然后要注意矩阵乘法不具有交换律,所以加标记的时候要用标记乘上加的矩阵,不能用加的矩阵乘上标记。
写作业
首先把作业按照开始时间从小到大的顺序写肯定是最优的。
然后考虑转移。在这里,有转移:
dp_i=\max(dp_{i-1}+1,s_i)+t_i-1
于是我们可以定义 (\max,+) 矩阵乘法来做转移。同样的,直接 [dp_i] 作为一个矩阵是没有办法的,因为要处理加法这些东西。于是我们定义 [dp_i,0] 为一个状态。
那么转移矩阵是好推的,如下:
\begin{bmatrix}t_i&-\infin\\s_i+t_i-1&0\end{bmatrix}
于是直接线段树维护单点修改矩阵,区间做矩阵乘法就可以了。注意到这里是从小到大做乘法,所以我们维护值域上的线段树。
11.5 线段树二分
其实这个东西比树状数组倍增好理解,虽然稍微难写但是不容易写错,所以我一般就算可以树状数组倍增也用线段树二分(?)
有的时候我们在一个题目需要用到两个操作:二分和线段树。这个时候,直接做是 O(\log^2n) 的。但是,我们可以在线段树上直接做,来做到 O(\log n) 。
依旧使用宝石管理系统。那么之前的转化在树状数组倍增这一章节已经讲过了,重点在于:如何使用线段树查询和 < k 的最长前缀。
首先显然可以二分前缀的长度,然后使用线段树求和来判断前缀是否 < k 。但是这么做是 O(\log^2n) 的,所以考虑利用线段树的结构来动态的二分。
我们设 f(x,k) 表示来到节点 x ,查询的是节点区间中的和 <k 的一段最长前缀的右端点。那么我们来到这个节点,需要判断的只有应该向左边还是向右边递归。然后我们约定记号,l_x 表示 x 的左孩子,r_x 表示 x 的右孩子,\operatorname{sum}(x) 表示 x 代表区间的区间和,pl_x 表示 x 区间的左端点,pr_x 表示 x 区间的右端点。
可以这么做:假设左边的和 >k ,那么区间和 <k 的右端点必然落在左区间,所以递归左区间 f(l_x,k) 求解即可。否则,右端点肯定落在右区间,我们希望求得右区间所对应的前缀 <k ,其中的 k 已经被左区间的和给抵消掉一部分了,所以应该是 f(r_x,k-\operatorname{sum}(l_x)) 。形式化的,
f(x,k)=\begin{cases}pl_x&pl_x=pr_x\\f(l_x,k)&\operatorname{sum}(l_x)>k\land pl_x\neq pr_x\\f(r_x,k-\operatorname{sum}(l_x))&sum(l_x)\leq k\land pl_x\neq pr_x&\end{cases}
所以现在就可以做了。由于每一层只会递归一个节点,所以复杂度是 O(\log n) 的。下面是代码实现:
::::success[code]
#include <bits/stdc++.h>
#define lc(x) (x << 1)
#define rc(x) (x << 1 | 1)
#define endl '\n'
using namespace std;

const int M = 1.1e5 + 5;
int m, q, a[M], temp[M], op[M], c[M], cnt;

struct SegmentTree {
    int t[M << 4];

    void insert(int l, int r, int x, int v) {
        if(l == r) return t[x] ++ , void();
        int mid = l + r >> 1;
        if(v <= mid) insert(l, mid, lc(x), v);
        else insert(mid + 1, r, rc(x), v);
        t[x] = t[lc(x)] + t[rc(x)];
    }

    int query(int l, int r, int x, int k) {
        if(l == r) return l;
        if(t[rc(x)] >= k) return query((l + r >> 1) + 1, r, rc(x), k);
        else return query(l, l + r >> 1, lc(x), k - t[rc(x)]);
    }
} T;

void lsh() {
    sort(temp + 1, temp + cnt + 1);
    cnt = unique(temp + 1, temp + cnt + 1) - temp - 1;
    for(int i = 1; i <= m; i ++ ) a[i] = lower_bound(temp + 1, temp + cnt + 1, a[i]) - temp;
    for(int i = 1; i <= q; i ++ )
        if(op[i] == 2) c[i] = lower_bound(temp + 1, temp + cnt + 1, c[i]) - temp;
}

int main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> m >> q;
    cnt = m;
    for(int i = 1; i <= m; i ++ ) cin >> a[i], temp[i] = a[i];
    for(int i = 1; i <= q; i ++ ) {
        cin >> op[i] >> c[i];
        if(op[i] == 2) temp[ ++ cnt] = c[i];
    }
    lsh();
    for(int i = 1; i <= m; i ++ ) T.insert(1, cnt, 1, a[i]);
    for(int i = 1; i <= q; i ++ ) {
        if(op[i] == 1) cout << temp[T.query(1, cnt, 1, c[i])] << endl;
        else T.insert(1, cnt, 1, c[i]);
    }
    return 0;
}
::::
然后是练习题:
::::success[题解]
怎么两个题都可以树状数组倍增。
youyou 的垃圾桶
首先从前往后总共打了多少次是容易求出来的,使用序列和直接模拟就可以求出来了,复杂度 O(\log V) 。
于是就可以求出来最后一次翻了多少倍,以及最后一次的翻倍数。然后就可以求出最后一次需要多少和的前缀。
然后问题就变为了找到 <x 的最长前缀右端点,显然可以仿照上面已经给出的做法来做。时间复杂度 O(q\log V) 。
ycz 的妹子
第一问和第二问都是单点修改,最后最后一问是直接区间查询,所以问题就在于第三问如何求出第 x 个妹子。
我们可以对于有妹子的城市赋权 1 ,没有妹子的城市赋权 0 ,那么目标就变成了找出权值和 <x 的最长前缀,那个妹子的位置就是最长前缀右端点加一。
于是可以直接做了,时间复杂度 O(n\log n) 。
*11.6 动态开点线段树
根据我们之前章节证明的一个经典结论,线段树一次操作只会访问 O(\log n) 个节点。
所以说,假如我们只做了 m 次修改,访问的总节点数是 O(m\log n) 的。所以说,假如我们线段树开的序列长度很大,远大于 O(m\log n) ,那么我们可以考虑动态开点,需要一个点就开一个。
由这道模板引入。在这里区间长度为 10^9 ,而 m\log n 只有 1.7\times 10^6 ,显然可以考虑动态开点。注意:动态开点只适用于一个节点初始状态容易计算的时候。比如说这个题,就是等差数列求和公式。
具体实现的时候,我们可以在 push_down 函数中,假如没有左右儿子就动态开点,这是一种比较简便的写法。但是假如涉及单点修改之类的,这样写一般比较慢,所以我们也可以针对需要访问的孩子动态开点。我个人之前写第一种写法被某道题卡空间了,然后就换成第二种写法了。但是带 push_down 的动态开点我还是一般写第一种写法。
然后动态开点线段树的节点数量是非常大的,所以我们需要注意一个节点挂的信息不能太多,比如推荐在递归过程中计算节点对应的区间而不是对于每一个节点存储左右区间,这样可以每一个节点砍掉两个 int。
然后实现的时候别的地方和线段树大同小异,就不说了。直接给出代码吧,采用第一种写法。下面是最重要的 push_down,容易发现其实就是多了对于左右孩子开点这么一个操作。
void push_down(int l, int r, int x) {
    int mid = l + r >> 1;
    if(!lc(x)) lc(x) = newn(l, mid);
    if(!rc(x)) rc(x) = newn(mid + 1, r);
    if(t[x].lazy) {
        addtag(l, mid, lc(x), t[x].lazy);
        addtag(mid + 1, r, rc(x), t[x].lazy);
        t[x].lazy = 0;
    }
}
最后给出完整实现:
::::success[代码]
#include <bits/stdc++.h>
#define int unsigned long long
#define rep(i, l, r) for(int i = l; i <= r; i ++ )
#define endl '\n'
using namespace std;

const int N = 1e5 + 5;
int n, m;

struct Segment_Tree {
    #define lc(x) t[x].lc
    #define rc(x) t[x].rc
    int rt, tot;
    struct Node { int sum, lazy, lc, rc; } t[N << 6];
    void pushup(int x) { t[x].sum = t[lc(x)].sum + t[rc(x)].sum; }

    int newn(int l, int r) {
        tot ++ ;
        t[tot].sum = (l + r) * (r - l + 1) / 2;
        return tot;
    }

    void addtag(int l, int r, int x, int v) {
        t[x].sum += (r - l + 1) * v;
        t[x].lazy += v;
    }

    void push_down(int l, int r, int x) {
        int mid = l + r >> 1;
        if(!lc(x)) lc(x) = newn(l, mid);
        if(!rc(x)) rc(x) = newn(mid + 1, r);
        if(t[x].lazy) {
            addtag(l, mid, lc(x), t[x].lazy);
            addtag(mid + 1, r, rc(x), t[x].lazy);
            t[x].lazy = 0;
        }
    }

    void update(int l, int r, int x, int ul, int ur, int v) {
        if(ul <= l && r <= ur) {
            addtag(l, r, x, v);
            return;
        }
        if(l > ur || ul > r) return;
        push_down(l, r, x);
        update(l, l + r >> 1, lc(x), ul, ur, v);
        update((l + r >> 1) + 1, r, rc(x), ul, ur, v);
        pushup(x);
    }

    int query(int l, int r, int x, int ql, int qr) {
        if(ql <= l && r <= qr) return t[x].sum;
        if(l > qr || ql > r) return 0;
        push_down(l, r, x);
        return query(l, l + r >> 1, lc(x), ql, qr)
            + query((l + r >> 1) + 1, r, rc(x), ql, qr);
    }

    void update(int l, int r, int v) {
        if(!rt) rt = newn(1, n);
        update(1, n, 1, l, r, v);
    }

    int query(int l, int r) {
        if(!rt) rt = newn(1, n);
        return query(1, n, 1, l, r);
    }
} T;

signed main() {
    ios :: sync_with_stdio(0);
    cin.tie(0), cout.tie(0);
    cin >> n >> m;
    rep(i, 1, m) {
        int op, l, r, k;
        cin >> op >> l >> r;
        if(op == 1) {
            cin >> k;
            T.update(l, r, k);
        } else {
            cout << T.query(l, r) << endl;
        }
    }
    return 0;
}
::::
然后给出练习题目:
::::success[题解]
贴海报
但是其实这个题需要求所有的单点值,这该怎么做呢?其实有一个比较牛的写法,不需要开整棵线段树,只需要在已经开过的节点上递归就可以了。
我们已经开过的节点显然构成一个树。假如我们递归到了这个树的叶子,我们会发现这个叶子在整棵线段树所代表的区间上的点受到的修改是一样的。所以对于求的答案数组,直接对于这个节点所代表的区间上赋值就可以了。
感觉是一个可以深入理解动态开点线段树的题目~~虽然这题动态开点线段树是歪解~~。
### 方伯伯的 OJ
实际上转化一下题意就发现是若干单点修改加上查询排名和第 $k$ 大。那么我们就发现了,可以直接开一棵权值线段树来维护,使用线段树二分来查询 $k$ 大,此事在线段树二分章节有记载。
由于值域很大,而且~~邪恶的~~出题人强制在线不让我们离散化,所以要使用动态开点线段树。
然后对于修改编号这种东西,可以直接开一个哈希表来记录每一个编号对应的用户排名。所以这个题都做完了,感觉蓝有一点德不配位(?)可能是因为正解平衡树。
::::
## *11.7 势能线段树
势能线段树,是什么呢?其实是时间复杂度需要势能分析的线段树。
势能线段树用于处理一类懒标记无法维护的区间操作和区间查询。比如说,区间开根号和区间求和的[模板题](https://www.luogu.com.cn/problem/P4145)。首先我们需要知道一件事情,就是 $\sum \sqrt{a_i}$ 是无法通过任何容易维护的信息推出来的,所以直接拆式子然后线段树维护基本不可能。
但是我们发挥注意力,根据经典结论,在 $a\leftarrow \lfloor\sqrt n\rfloor$ 这个操作,操作 $O(\log\log a)$ 次 $a$ 就会变成 $1$,而对于 $1$ 开根号之后还是 $1$,所以有用的开根号操作只有 $O(n\log\log V)$ 次,这个时候难点就来到如何找出有用的操作就可以了。
首先直接暴力是不可行的,因为你需要判断每个点,这样找的复杂度就炸了,是 $O(n)$ 单次操作的。
但是我们发现线段树可以维护一些区间信息,或许这可以帮助我们判断一个区间是否全部不需要操作。比如说,一种方法是维护区间 $\max$,然后判断区间 $\max$ 是否为 $1$,如果区间 $\max$ 是 $1$ 那么这个区间不需要操作。或者还有一种做法就是维护区间的开根号最小次数,假如这个最小次数达到了阈值那么这个区间不需要操作。其中这道题 $10^{12}$ 开六次根号就变成 $1$ 了。(注意这里是开**六次**根号,不是开一次六次根)
所以就可以使用线段树快速的剪掉一些不需要的分支。那么分析一下复杂度,线段树访问单点是 $O(\log n)$ 的,每个点至多操作 $O(\log\log V)$ 次(因为 $1$ 会在递归过程中直接剪掉,剩下的节点都是通往非 $1$ 的),所以总复杂度 $O(n\log n\log\log V)$。下面给出代码关键部分,也就是修改部分。
```cpp
void update(int l, int r, int x, int ul, int ur) {
if(l > ur || ul > r) return;
if(l == r) {
mi[x] = sum[x] = sqrt(mi[x]);
return;
}
if(mi[lc(x)] > 1) update(l, l + r >> 1, lc(x), ul, ur);
if(mi[rc(x)] > 1) update((l + r >> 1) + 1, r, rc(x), ul, ur);
pushup(x);
}
```
这一部分最主要需要注意的就是一定要把判断区间不交放在单点修改前面。再次重申为什么叫势能线段树:我们分析复杂度的时候使用了均摊分析中的**聚合分析**,所以叫做势能线段树。下面给出完整实现:
::::success[code]
```cpp
#include <bits/stdc++.h>
#define rep(i, l, r) for(int i = l; i <= r; i ++ )
#define int long long
#define endl '\n'
using namespace std;
const int N = 1e5 + 5;
int n, m, a[N];
struct Segment_Tree {
#define lc(x) (x << 1)
#define rc(x) (x << 1 | 1)
int mi[N << 2], sum[N << 2];
void pushup(int x) {
mi[x] = max(mi[lc(x)], mi[rc(x)]);
sum[x] = sum[lc(x)] + sum[rc(x)];
}
void build(int l, int r, int x, int a[]) {
if(l == r) {
mi[x] = sum[x] = a[l];
return;
}
build(l, l + r >> 1, lc(x), a);
build((l + r >> 1) + 1, r, rc(x), a);
pushup(x);
}
void update(int l, int r, int x, int ul, int ur) {
if(l > ur || ul > r) return;
if(l == r) {
mi[x] = sum[x] = sqrt(mi[x]);
return;
}
if(mi[lc(x)] > 1) update(l, l + r >> 1, lc(x), ul, ur);
if(mi[rc(x)] > 1) update((l + r >> 1) + 1, r, rc(x), ul, ur);
pushup(x);
}
int query(int l, int r, int x, int ql, int qr) {
if(ql <= l && r <= qr) return sum[x];
if(l > qr || ql > r) return 0;
return query(l, l + r >> 1, lc(x), ql, qr)
+ query((l + r >> 1) + 1, r, rc(x), ql, qr);
}
} T;
signed main() {
ios :: sync_with_stdio(0);
cin.tie(0), cout.tie(0);
cin >> n;
rep(i, 1, n) cin >> a[i];
T.build(1, n, 1, a);
cin >> m;
rep(i, 1, m) {
int op, l, r;
cin >> op >> l >> r;
if(l > r) swap(l, r);
if(op == 0) T.update(1, n, 1, l, r);
else cout << T.query(1, n, 1, l, r) << endl;
}
return 0;
}
```
::::
接着给出一些练习题。
- [SUM and REPLACE](https://www.luogu.com.cn/problem/CF920F)
- [The Child and Sequence](https://www.luogu.com.cn/problem/CF438D)
- [TEST_69](https://www.luogu.com.cn/problem/P9989)
::::success[题解]
### SUM and REPLACE
我们有 $d(1)=1$,$d(2)=2$,其余的数字均有 $d(x)<x$,因为必然有 $x-1\perp x$。
然后使用经典结论,$d(x)=O(x^{\frac{1}{\log\log x}})$,显然这个东西强于开根号,所以复杂度也是有保证的。
于是我们将势能设计为区间 $1$ 的个数加上区间 $2$ 的个数,假如区间全部为 $1/2$,那么修改是没有用的,直接跳过即可。这样就可以做到比较优秀的复杂度了。
### The Child and Sequence
这道题也具有势能,根据结论:$\forall k<x, x\bmod k<\frac{x}{2}$。证明是简单的,若 $k<\frac{x}{2}$ 那么取模出来 $<\frac{x}{2}$,若 $k=\frac{x}{2}$ 则取模出来是 $0$,若 $k>\frac{x}{2}$ 则取模出来是 $x-k$,这个 $<\frac{x}{2}$。
所以我们可以维护区间的最大值作为势能,假如当前取模的数大于区间最大值了,那么这个区间就不应该被修改。然后证明一下复杂度。
定义势能函数 $\phi(x)=\sum\log x_i$。那么我们线段树的一次区间修改会耗费 $k\log n$ 的复杂度使得势能降低 $k$,一次单点修改会使势能增加 $\log V$。
那么总共的势能大小最多是 $O(n\log V)$ 的,每一次减少势能只使用了 $O(\log n)$ 的复杂度,所以总复杂度 $O(n\log n\log V)$。
### TEST_69
对于一次有用的操作,$\gcd(a_i, x)$ 都会使 $a_i$ 至少减半,因为会除一个非 $1$ 因数。所以有用的总操作次数是 $O(n\log V)$ 的,直接上势能线段树!
一个区间取 $\gcd$ 没用的条件是这个区间中所有的数都是 $x$ 的约数,换言之,区间 $\operatorname{lcm}$ 假如是 $x$ 的因数,那么这个区间就不需要被修改,于是维护区间 $\operatorname{lcm}$ 作为势能。
注意区间 $\operatorname{lcm}$ 是很大的,直接存储会爆炸,具体实现的时候和一个极大数(比如 $10^{18}+1$)取 $\min$ 就可以了。
那么总共在线段树内访问 $O(n\log n\log V)$ 个节点,每一次维护 $\operatorname{lcm}$ 是 $O(\log V)$ 的,所以总时间复杂度 $O(n\log n\log^2 V)$。但是其实常数很小所以可以过。
::::
# 12. 字典树
## 12.1 基本概念
字典树是一类用于维护字符串的前缀查询的数据结构。它能解决什么问题呢?比如说,给定一些字符串 $s$,再给定一些字符串 $t$,查询有多少个 $s$ 包含 $t$ 作为前缀。
我们可以考虑这样一种思想:把所有前缀相同的字符串压缩在一起。比如说,我们可以将 $ab$ 和 $ac$ 给压缩为 $a\to b$ 和 $a\to c$,其中 $a$ 我们共用一个位置。
接着我们推广一下这个结构。我们维护一个树形结构,$u$ 的所有儿子表示 $u$ 后面接上一个字符之后到达的点,每一次插入字符串的时候首先把所有已经存在于树上的节点给遍历了,作为一段公共前缀,然后对于剩余的后缀添加节点。
首先一开始就把整棵树建出来显然是不可行的,因为可能的状态有 $\Sigma^l$ 种(其中 $l$ 为串长,$\Sigma$ 表示字符集大小),所以空间肯定会炸掉。于是可以仿照动态开点线段树的思想,每一次需要用到一个点就开一个点,这样开的总点数不会超过 $\sum l$(后文记为 $L$),所以空间复杂度是 $O(\Sigma L)$ 的。
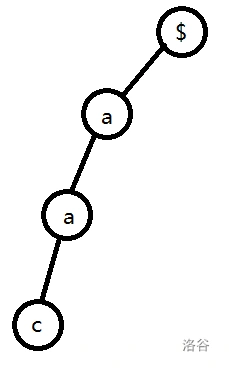
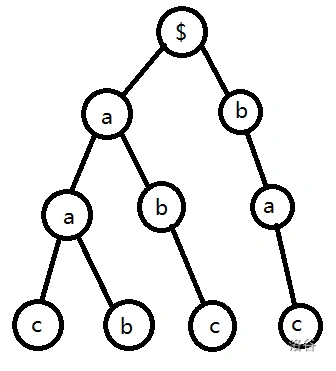
可能看了上面这段话太抽象了,你不是很能理解,就举一个例子吧,假设我们往字典树里面插入 $aac$,$aab$ 和 $abc$,$bac$ 四个字符串。首先,为了从一个点可以出发到所有节点,所以我们初始的时候必须要有一个根。就像这样(演示是插入 $aac$ 之后,其中 `$` 代表根节点):
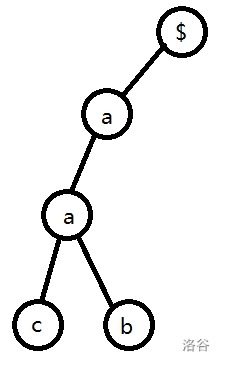
接着插入 $aab$:
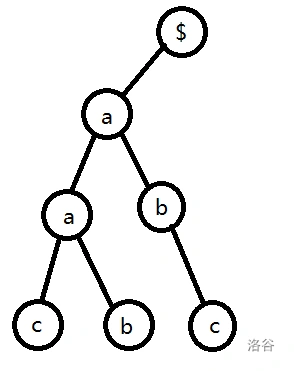
然后插入 $abc$:
最后插入 $bac$:
为了查询前缀个数,我们对于每一次插入字符串的时候都把访问的所有节点的权值 $+1$,然后每一次查询一个包含字符串作为前缀的询问的时候,直接递归那个字符串,到达的点的权值就是答案了。
正确性是容易理解的,因为包含它作为前缀的字符串一定对于这个点只贡献过一次,否则就一次都没有贡献。于是我们插入和查询都只会递归字符串长度的字符个数,所以时间复杂度就是 $O(L)$ 的,非常快速。字典树的唯一缺点就是空间比较大,而且几乎无法优化。
## 12.2 代码实现
虽然上面使用了很多的递归描述,但是实际上实现的时候可以使用迭代,这样常数会小很多。代码都是用于解决[模板题](https://www.luogu.com.cn/problem/P8306)的。首先给出一些数组定义与函数:
```cpp
struct TrieNode { int ch[65], cnt; } t[N];
int tot, root = 0;
int yw(char c) {
if('0' <= c && c <= '9') return c - '0';
else if('a' <= c && c <= 'z') return c - 'a' + 10;
else return c - 'A' + 36;
}
```
`yw` 函数就是将字符转化为一个数字,便于处理。相信这里是容易理解的,其中 `ch` 数组存储孩子。这样做会有一点浪费,但是假如我们用哈希表什么的存储的话会常数太大,而且空间其实也不能优化多少,所以就懒得优化空间了。
然后是插入字符串部分:
```cpp
int newn() {
tot ++;
t[tot].cnt = 0;
for(int i = 0; i < 65; i++) t[tot].ch[i] = 0;
if(tot == 1) root = tot;
return tot;
}
void insert(string s) {
if(root == 0) newn();
int u = root;
t[u].cnt ++;
for(int i = 0; i < s.size(); i++) {
char c = s[i];
if(t[u].ch[yw(c)] == 0) t[u].ch[yw(c)] = newn();
u = t[u].ch[yw(c)];
t[u].cnt ++;
}
}
```
`newn` 就是用来新开节点的。`insert` 的逻辑在之前就已经讲解过了,相信并不是太难,可以自行理解,主要就是使用 $u$ 表示目前已经递归到的节点。
接着就是查询前缀了,逻辑也已经讲过。这里与插入不同的是,遇到没有的节点可以直接返回 $0$,因为再往下找肯定没有字符串了。
```cpp
int query(string s) {
int u = root;
for(int i = 0; i < s.size(); i++) {
char c = s[i];
if(t[u].ch[yw(c)] == 0) return 0;
u = t[u].ch[yw(c)];
}
return t[u].cnt;
}
```
最后给出模板题的完整实现。
::::success[code]
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 3e6 + 10;
struct TrieNode { int ch[65], cnt; } t[N];
int tot, root = 0, n, q;
string s;
int yw(char c) {
if('0' <= c && c <= '9') return c - '0';
else if('a' <= c && c <= 'z') return c - 'a' + 10;
else return c - 'A' + 36;
}
int newn() {
tot ++;
t[tot].cnt = 0;
for(int i = 0; i < 65; i ++ ) t[tot].ch[i] = 0;
if(tot == 1) root = tot;
return tot;
}
void insert(string s) {
if(root == 0) newn();
int u = root;
t[u].cnt ++;
for(int i = 0; i < s.size(); i ++ ) {
char c = s[i];
if(t[u].ch[yw(c)] == 0) t[u].ch[yw(c)] = newn();
u = t[u].ch[yw(c)];
t[u].cnt ++;
}
}
int query(string s) {
int u = root;
for(int i = 0; i < s.size(); i ++ ) {
char c = s[i];
if(t[u].ch[yw(c)] == 0) return 0;
u = t[u].ch[yw(c)];
}
return t[u].cnt;
}
inline void solve() {
cin >> n >> q;
root = tot = 0;
for(int i = 1; i <= n; i ++ ) {
cin >> s;
insert(s);
}
for(int i = 1; i <= q; i ++ ) {
cin >> s;
cout << query(s) << endl;
}
}
int main() {
ios :: sync_with_stdio(0);
cin.tie(0); cout.tie(0);
int T;
cin >> T;
while(T -- ) solve();
return 0;
}
```
::::
- [于是他错误的点名开始了](https://www.luogu.com.cn/problem/P2580)
- [学籍管理](https://www.luogu.com.cn/problem/P5266)
- [前缀统计](https://www.luogu.com.cn/problem/P10470)
::::success[题解]
你问我为什么都是简单题,这是因为比较困难的题目都在 0-1 Trie。
### 于是他错误的点名开始了
我们每一次在字典树插入一个字符串的时候,将最后一个节点标记为“末尾节点”。
对于查询一个字符串,假如这个字符串走到的最后一个点是“末尾节点”的话,那么点名就重复了,否则没有。其实也可以使用 `map` 直接存储。
### 学籍管理
也是仿照上一题,在字典树访问的最后一个节点存储信息。然后仔细想一下就会发现四个操作都是好做的。
### 前缀统计
这道题与模板的区别在于:一个统计的是 $s$ 为 $t$ 的前缀,一个统计的是 $t$ 为 $s$ 的前缀。
这里我们可以这么做:对于每一个字符串,对于其末尾节点的权值 $+1$,那么查询答案就是这个字符串所对应路径的权值和。
简单理解一下就是每一个点的权值代表了这个前缀的字符串个数,将查询字符串的所有前缀求和就可以了。
::::
## *12.3 0-1 Trie
0-1 Trie 本质也是字典树,只不过它不维护数字,维护值。其实这个东西和动态开点线段树好像区别不大,只是更加便于维护每一位上的信息。
字典树是维护字符串的,也就是要求字符集很小,但是数字的字符集是很大的,怎么维护呢?很容易想到拆位这个 Trick,对于数字进行二进制拆分,这样字符集就从 $V$ 变成了 $2$,这样就可以直接塞到字典树里了。
听着非常的简单,实际上用法非常的巧妙,可以快速地支持很多奇妙的全局操作。比如说,[这个题目](https://www.luogu.com.cn/problem/P11872)。乍一看,别的数据结构都基本没法维护。
首先字典树不支持修改,但是支持插入和删除,所以我们可以将单点修改变为一次删除和一次插入,把之前的那个字符串给删了,然后插入一个新的。
然后想想怎么维护全局异或和。假如我们现在已经知道了一个节点的 $0$ 子树的异或和为 $x$,$1$ 子树的异或和为 $y$。请注意,其中 $x, y$ 均为子树内部的数的异或和,而不是子树内部结尾节点对应的整个数的异或和,不然没法做。
然后发现 pushup 是非常困难的,于是换思路,倒着插入数字,也就是叶子结点表示最高位,这个时候 pushup 就变得容易了。首先两个子树转移到目前这个节点就只需要平移一位。所以假设当前子树树高为 $k$,那么 $[2,k]$ 这段位置的答案就是 $x\oplus y$,于是考虑最后一位的答案。其实最后一位的答案只有 $1$ 子树有贡献,而且 $1$ 子树每多一个数字就相当于给最后一位异或 $1$,所以最后一位就是 $1$ 子树中数字结尾的奇偶性。
然后就到了最巧妙的全局 $+1$ 了,这个操作也巧妙的利用了倒着插入数字的性质。首先,假如最后一位是 $1$,那么这一位的 $1$ 应该变成 $0$,否则 $0$ 应该变成 $1$,也就是**交换左右子树**。然后,假如这一位 $1\to 0$ 了,但是下一位还是 $1$ 的话,还应该继续进位,所以我们应该递归 $0$ 子树,然后仿照上述考虑,对于这一位也是先交换左右子树,然后递归 $0$ 子树。我认为竖式加法对于这一点的理解有帮助,交换相当于进位。
由于树高是 $\log V$ 的,所以上述操作是 $O(\log V)$ 的。那么代码也就很好写了(其中 `cnt` 维护的是奇偶性,因为只有奇偶性有用):
```cpp
struct Node { int cnt, xsum, ch[2]; } t[N];
void pushup(int x) {
t[x].xsum = 0;
if(t[x].ch[0]) t[x].xsum ^= t[t[x].ch[0]].xsum;
if(t[x].ch[1]) t[x].xsum ^= t[t[x].ch[1]].xsum;
t[x].xsum = (t[x].xsum << 1) | t[t[x].ch[1]].cnt;
}
void insert(int x) {
int u = 1;
t[u].cnt ^= 1;
for(int i = 0; i <= 20; i ++ ) {
int k = (x >> i) & 1;
if(!t[u].ch[k]) t[u].ch[k] = ++ tot, pr[tot] = u;
u = t[u].ch[k];
t[u].cnt ^= 1;
}
while(u) pushup(u), u = pr[u];
}
void del(int x) {
int u = 1;
t[u].cnt ^= 1;
for(int i = 0; i <= 20; i ++ ) {
int k = (x >> i) & 1;
u = t[u].ch[k];
t[u].cnt ^= 1;
}
while(u) pushup(u), u = pr[u];
}
void add(int u) {
swap(t[u].ch[0], t[u].ch[1]);
if(t[u].ch[0]) add(t[u].ch[0]);
pushup(u);
}
```
完整实现如下:
::::success[code]
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 5e6 + 5;
int n, q, tot = 1, v[N], tg, pr[N];
struct Node { int cnt, xsum, ch[2]; } t[N];
void pushup(int x) {
t[x].xsum = 0;
if(t[x].ch[0]) t[x].xsum ^= t[t[x].ch[0]].xsum;
if(t[x].ch[1]) t[x].xsum ^= t[t[x].ch[1]].xsum;
t[x].xsum = (t[x].xsum << 1) | t[t[x].ch[1]].cnt;
}
void insert(int x) {
int u = 1;
t[u].cnt ^= 1;
for(int i = 0; i <= 20; i ++ ) {
int k = (x >> i) & 1;
if(!t[u].ch[k]) t[u].ch[k] = ++ tot, pr[tot] = u;
u = t[u].ch[k];
t[u].cnt ^= 1;
}
while(u) pushup(u), u = pr[u];
}
void del(int x) {
int u = 1;
t[u].cnt ^= 1;
for(int i = 0; i <= 20; i ++ ) {
int k = (x >> i) & 1;
u = t[u].ch[k];
t[u].cnt ^= 1;
}
while(u) pushup(u), u = pr[u];
}
void add(int u) {
swap(t[u].ch[0], t[u].ch[1]);
if(t[u].ch[0]) add(t[u].ch[0]);
pushup(u);
}
signed main() {
ios :: sync_with_stdio(0);
cin.tie(0), cout.tie(0);
cin >> n >> q;
for(int i = 1; i <= n; i ++ ) {
cin >> v[i];
insert(v[i]);
}
for(int i = 1; i <= q; i ++ ) {
int op, x, p;
cin >> op;
if(op == 0) {
cin >> x >> p;
del(v[x] + tg);
v[x] = p - tg;
insert(p);
} else if(op == 1) {
tg ++ ;
add(1);
} else {
cout << t[1].xsum << endl;
}
}
return 0;
}
```
::::
给出一些练习题:
- [逆序对](https://www.luogu.com.cn/problem/P1908)
- [【模板】普通平衡树](https://www.luogu.com.cn/problem/P3369)
- [Fusion Tree](https://www.luogu.com.cn/problem/P6018)
::::success[题解]
### 逆序对
是的,这道题可以 0-1 Trie,而且是比较自然的应用。只是空间有点大。
首先仿照树状数组做法,每一次查询集合中 $>x$ 的数字个数,然后插入一个数字。首先插入数字是天生支持的,所以考虑查询 $>x$ 怎么做。
其实比较简单,你顺着这个 $x$ 一路递归下去,假如这一位是 $0$,那么这一位填 $1$ 的数字都比它大,所以直接将这一位填 $1$ 的子树大小加上去就好了。
~~但是好像常数很大啊。~~
### 【模板】普通平衡树
直接根据权值树状数组做法转化,这道题要求查询 $k$ 大,以及一个数的排名,插入,删除。
排名,插入,删除在前面已经讲解过了,那么具体就来到了求 $k$ 大,这个时候就需要用到 0-1 Trie 与线段树的相似性了,你可以考察这一位填 $0$ 的个数与左孩子的节点数的关系,然后递归下去做就可以了。具体的实现非常像线段树二分,如果不太理解上面这句话可以结合线段树二分张杰理解。
### Fusion Tree
这个题其实就是对于树上的相邻节点做异或盒子。
那么我们利用字典树自身实现就带动态开点的性质,发现假如对于每个节点维护相邻节点的异或盒子的空间复杂度是不会爆炸的。
但是时间复杂度会爆,考虑一个菊花,然后每一次改花心,这样每一次修改都会影响到 $O(n)$ 个异或盒子。
只不过上面的做法可以沿用,但是不维护父亲,因为父亲只有一个,查询的时候可以直接单点查一下然后合并进去。那么这样每次修改的时候就只会影响到两个异或盒子了,自己的异或盒子和父亲的异或盒子。
于是可以 $O(n\log V)$ 做了。
::::
# *13. 平衡树
图最多的一集。
感觉这是一个非常厉害的东西啊,融合了线段树二分思想,0-1 Trie 二分思想,以及调整法思想于一炉。并且做法丰富众多。
## 13.1 基本概念
【模板】普通平衡树这道题已经被我们做了三次了,所以相信大家都记得题面是什么了。虽然我们使用了很多的邪魔外道来解决这个题,但是我们还是来看看正经做法长什么样子吧(悲)。
首先,对于一个有序的数列,查询 $k$ 大,前驱,后继,排名都是简单的。第一个就是直接输出第 $k$ 个数,后三个就是首先在序列上二分找到位置,然后直接输出前一个数 / 后一个数 / 位置就可以了。
~~然后你用 vector 插入,又过了。~~
好吧,我们需要一个不那么暴力的做法。由于二叉树很优秀,所以我们考虑使用二叉树来维护这个有序序列。然后我们令这个二叉树的每个节点上都维护一个值,并且其中序遍历为一个有序的序列。
那么这棵树就满足如下的性质:左子树的值均小于该节点的值,该节点的值小于右子树所有节点的值。这个性质是优美的,保证了我们可以在这棵树上二分,具体的,查找一个值的时候,假如这个值等于该节点那么就找到了,小于就走左孩子,大于就走右孩子。然后可以去重一下,每个节点存储等于 $x$ 的数的个数,这样就不会出现一些奇怪的问题了。
比如下面这棵树是对于 $1,9,8,0,4,5$ 构造的一种可能的二叉搜索树:
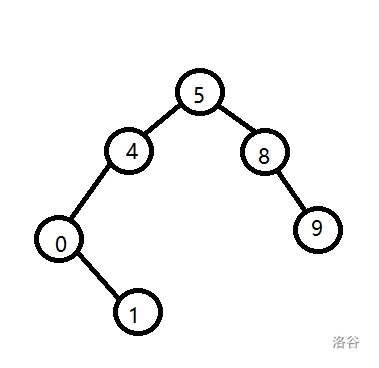
对于插入,我们可以直接在树上使用我说的方式递归,假如找不到这个节点了就说明我们应该在这个地方新开一个节点插进去。
比如我们现在要插入 $6$,$6>5$ 所以走右子树,然后 $6<8$ 所以走左子树,你发现没有左子树,所以就新开一个左子树把 $6$ 塞进去就插入完毕了。插入完毕之后的树长这样:
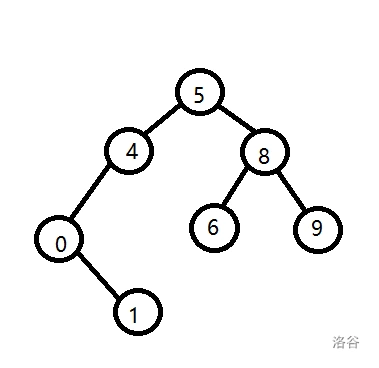
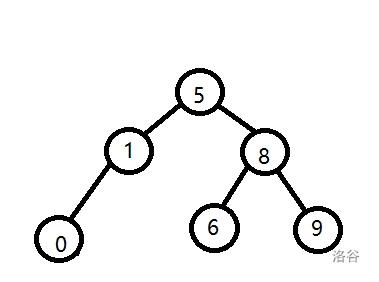
然后现在我们希望删除 $4$,那么这个时候发现以 $1$ 为根的子树就被孤立开了,所以我们需要一个数字填回去,比如我们可以将 $1$ 填到原本 $4$ 的位置上去。也就是把左子树最大值填到这个 $4$ 的位置上去。
通过观察我们发现左子树最大值肯定是沿着左子树的根一直往右,所以这肯定是一个叶子,删掉不影响。比如上面左子树最大值就是 $1$,于是把 $1$ 换到 $4$ 的位置上然后删掉。假如不存在左子树最大值,就可以换成右子树最小值。于是这棵二叉搜索树变成了这样:
接着我们来看看前驱,后继,排名,$k$ 大这些都怎么做。
前驱后继是比较简单的,而排名和 $k$ 大比较难,所以先讲前驱后继吧。这两个本质相同。
找前驱的时候,我们首先考虑找到这个数在平衡树中的位置。这个递归过程中,我们发现它的前驱只可能存在于递归路径中,所以对于递归路径上经过的所有小于它的点,取最后一个就可以了。
比如查询 $7$ 的前驱:
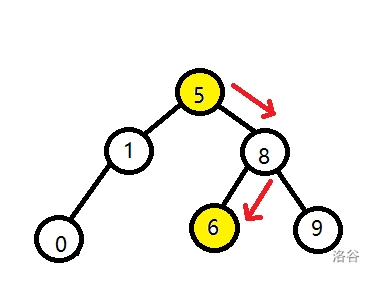
其中黄色的节点是递归过程中 $<x$ 的节点,红色箭头表示递归过程,容易发现最后取到的是 $6$。
为什么取最后一个就可以了呢?简单证明一下,之前你遇到一个 $<x$ 的,你就应该往右子树走,右子树的数都是更大的,也就是更优的。
查询后继是类似的,找递归过程中最后一个 $>x$ 的数就可以了,不多赘述。
然后查询前驱和后继都是需要统计数的数量的问题,所以直接找肯定会超时,需要维护子树和。接着我们来找 $k$ 大,这样就需要类似线段树二分的做法了。
判断左儿子大小与目前 $k$ 的关系,假如左儿子大小大于等于 $k$ 就递归左儿子,假如 $k$ 等于左儿子大小加一就表明答案就是当前节点,否则对于 $k$ 扣除左儿子大小加一之后递归右儿子。相当于线段树二分,但是当前节点也算 $1$ 的贡献。
接着是排名。假如我们向右孩子递归的时候,那么这个数就大于左孩子以及目前到的节点了,直接累加上这个和。否则,向左孩子递归。假如相等的时候不应该统计,因为前驱是严格的。大家可以结合之前的图自己画一下理解 $k$ 大和排名,我就不画了~~其实是懒~~。
代码就不放了,因为其实大部分代码是可以从 Treap / Splay 章节的代码找到的。
我们来分析一下这个东西的时间复杂度。每一个操作都会递归到某一个节点,显然是 $O(h)$ 的,$h$ 表示树高。假如插入的数字是随机的,那么树高的期望就是 $O(\log n)$ 的,非常优秀。但是实际上,它给你一个升序序列,你构造出来的二叉树就是一个链了,于是就变成 $O(n)$ 的了。
所以这种算法复杂度优秀的关键在于对于树高的控制。对于这个树高的控制,可谓是群英荟萃,有 AVL,红黑树,Treap,FHQ-Treap,Splay 等众多做法。我这篇文章会讲解竞赛中比较常用的平衡树,也就是后三种,AVL 和红黑树在工程中比较常见,不过竞赛也不是不能用,对于 AVL 可以看[这篇文章](https://www.luogu.com.cn/article/x0a22idn),红黑树可以看[这篇文章](https://www.luogu.com.cn/article/2r8qracv)。(可以发现后者代码太长了)
于是就从 Treap 开始,踏入工程最常用数据结构——平衡树的大门吧!
## 13.2 Treap
之前我们已经知道了二叉以随机顺序插入的时候的树高是期望 $O(\log n)$ 的,但是精心构造的数据可以卡掉二叉搜索树。
但是我们假如强制这些数以随机顺序插入,不就可以做到树高 $O(\log n)$ 了吗?为了强制这个以随机顺序插入,我们首先考察按照顺序插入在最下面之后树的形态。
我们发现,假如给每个节点一个时间戳 $t$,那么每一个节点的两个孩子的时间戳都是大于这个点的时间戳的,恰好形成了一个小根堆。为什么呢?因为每一个节点的左右儿子当时都是插入在叶子的,那么必然就存在这个节点了。
所以说,我们希望做到一个插入顺序随机的情况,我们可以从时间戳下手,把每一个节点的时间戳改成随机的(现在就称为**键值**了),然后让这棵树同时是键值的堆(小根还是大根不影响,因为是随机的),维护的数字的二叉搜索树,就是 Treap 了。比如下面是一棵可能的 Treap(维护的是大根堆),红色数字是键值,黑色数字是插入的数字。
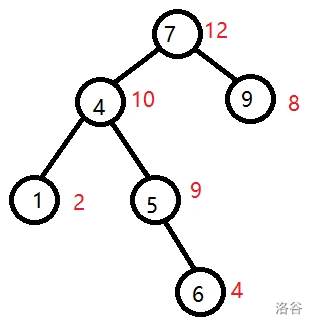
然后这个时候我们想要插入 $3$,其键值为 $15$。那么首先按照普通二叉搜索树的插入方法,把 $3$ 放在 $1$ 的右孩子,那么就长这样,虽然二叉搜索树的性质被保持了,但是大根堆的性质被破坏了!
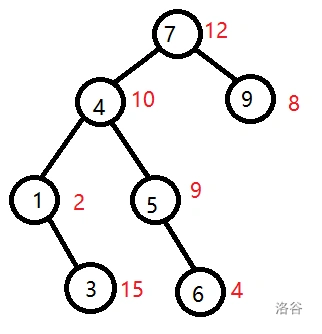
之前我们学过手写二叉堆,插入的时候,我们将插入的节点一直与父亲交换,直到满足堆的性质为止。对于 Treap 的调整我们也可以使用这种方法,但是我们不能够简单粗暴的交换,因为这样平衡树的性质可能被破坏。比如我们假如现在交换 $1,3$,$1$ 就在 $3$ 的右儿子了,显然不满足性质。
所以现在就到了平衡树的一个关键操作了:**旋转**。旋转操作,可以做到把平衡树中一个节点与其父亲交换。具体是如何实现的呢?请看图:
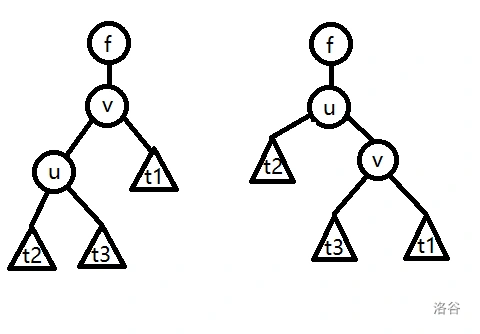
其中左右是可以互相转换的。可以发现左右均满足二叉搜索树的性质,$u, v$ 是 $f$ 的左孩子还是右孩子是不重要的。
首先想想这个怎么实现。首先假设 $u$ 是 $v$ 的左孩子,那么就是左边的情况,我们考虑推出右边相对于左边有哪些变化。
我们发现有这些变化:
- $u$ 的父亲变成了 $f$。
- $v$ 的父亲变成了 $u$。
- $t3$ 的父亲变成了 $v$。
- $v$ 的左孩子变成了 $t3$。
- $u$ 和右孩子变成了 $v$。
- $f$ 本来属于 $v$ 的位置变成了 $u$。
于是直接使用代码模拟这六个变化就可以了。对于 $u$ 是 $v$ 的右孩子的情况是类似的,读者可以自行分析。
为了简化代码,我们不需要完整的实现左旋和右旋,写一个就够了,因为父亲的调整不变,左孩子和右孩子都只和 $u$ 是 $v$ 的左孩子还是右孩子有关。
具体的,$u$ 是什么孩子,$v$ 的什么孩子就是 $t3$,$u$ 相反的孩子就是 $v$。所以可以使用一个长度为 $2$ 的数组来存储孩子而不是分别存左孩子和右孩子,这样可以简化代码。当然也可以分别写两种旋转。
那么我们看看上面的平衡树具体是怎么调整的吧。首先向上转一步,变成这样:
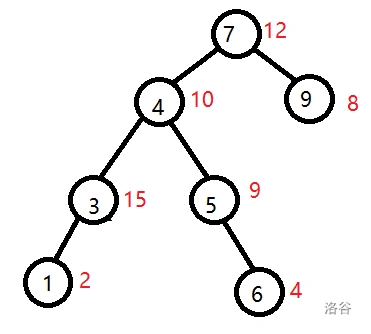
然后再转一次变成这样:
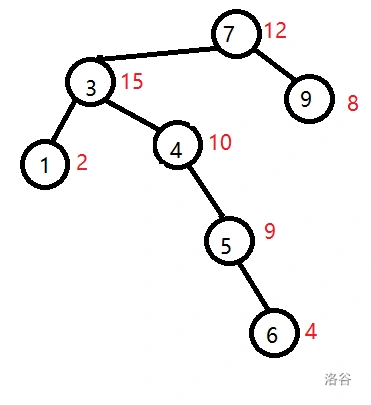
最后变成这样:
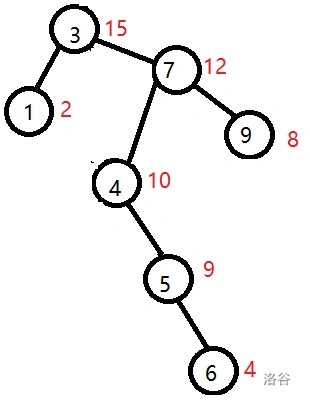
可以发现现在这个既满足大根堆的性质,又满足二叉搜索树的性质了!
然后我们说一下删除操作怎么做。我们可以仿照堆的下沉操作,直接把待删除节点和其键值最大的儿子一直交换,交换到没有儿子为止,那么它就成为一个叶子了,直接删掉即可。比如我们想要删除 $4$,删掉之后就是这样的:
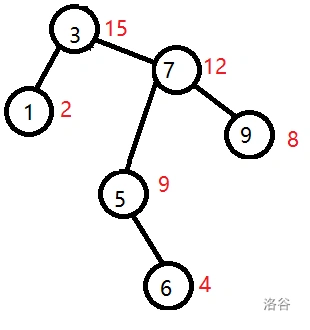
这个时候我们插入和删除都会了,其余的操作直接仿照之前的二叉搜索树的几种操作直接做就行了,没有区别。于是给出【模板】普通平衡树代码,复杂度期望 $O(n\log n)$。
::::success[code]
是远古代码,可能写法有点奇怪,使用了交换节点的方式来追求更好的常数,认真读就可以发现我前面说的都是实现的。
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 1e6 + 10;
struct node {
int lc, rc, val, fix, cnt, siz;
} tr[N];
int root = 0, k, t;
void pushup(int x) {
tr[x].siz = tr[tr[x].lc].siz + tr[tr[x].rc].siz + tr[x].cnt;
}
void zig(int &rt) {
int b = tr[rt].lc;
tr[rt].lc = tr[b].rc;
tr[b].rc = rt;
pushup(rt);
pushup(b);
rt = b;
}
void zag(int &rt) {
int b = tr[rt].rc;
tr[rt].rc = tr[b].lc;
tr[b].lc = rt;
pushup(rt);
pushup(b);
rt = b;
}
void insert(int &rt, int x) {
if(rt == 0) {
rt = ++k;
tr[rt].val = x;
tr[rt].cnt = tr[rt].siz = 1;
tr[rt].fix = rand();
return;
}
tr[rt].siz++;
if(x == tr[rt].val) {
tr[rt].cnt++;
return;
}
if(x < tr[rt].val) {
insert(tr[rt].lc, x);
if(tr[tr[rt].lc].fix < tr[rt].fix) zig(rt);
} else {
insert(tr[rt].rc, x);
if(tr[tr[rt].rc].fix < tr[rt].fix) zag(rt);
}
}
void del(int &rt, int x) {
if(rt == 0) return;
if(tr[rt].val == x) {
if(tr[rt].cnt > 1) {
tr[rt].cnt--;
tr[rt].siz--;
return;
}
if(tr[rt].lc == 0 || tr[rt].rc == 0) rt = tr[rt].lc + tr[rt].rc;
else {
if(tr[tr[rt].lc].fix < tr[tr[rt].rc].fix) {zig(rt); del(rt, x);}
else {zag(rt); del(rt, x);}
}
}
else if(x < tr[rt].val) {tr[rt].siz--; del(tr[rt].lc, x);}
else {tr[rt].siz--; del(tr[rt].rc, x);}
pushup(rt);
}
int rnk(int rt, int x) {
if(rt == 0) return 1;
if(x == tr[rt].val) return tr[tr[rt].lc].siz + 1;
if(tr[rt].val < x) return tr[tr[rt].lc].siz + tr[rt].cnt + rnk(tr[rt].rc, x);
else return rnk(tr[rt].lc, x);
}
int val(int rt, int x) {
if(rt == 0) return 0;
if(tr[tr[rt].lc].siz >= x) return val(tr[rt].lc, x);
else if(tr[tr[rt].lc].siz + tr[rt].cnt < x) return val(tr[rt].rc, x - tr[rt].cnt - tr[tr[rt].lc].siz);
else return tr[rt].val;
}
int pre(int rt, int x) {
if(rt == 0) return INT_MIN;
if(tr[rt].val < x) return max(tr[rt].val, pre(tr[rt].rc, x));
else return pre(tr[rt].lc, x);
}
int next(int rt, int x) {
if(rt == 0) return INT_MAX;
if(x < tr[rt].val) return min(tr[rt].val, next(tr[rt].lc, x));
else return next(tr[rt].rc, x);
}
int main() {
ios :: sync_with_stdio(0);
cin.tie(0); cout.tie(0);
srand(unsigned(time(0)));
int n;
cin >> n;
for(int i = 1; i <= n; i++) {
int op, x;
cin >> op >> x;
if(op == 1) insert(root, x);
else if(op == 2) del(root, x);
else if(op == 3) cout << rnk(root, x) << endl;
else if(op == 4) cout << val(root, x) << endl;
else if(op == 5) cout << pre(root, x) << endl;
else cout << next(root, x) << endl;
}
return 0;
}
```
::::
## 13.3 FHQ-Treap
由于 FHQ-Treap 含有 Treap 子串,所以 FHQ-Treap 也是 Treap。但是实现方式不同。FHQ-Treap 基于分裂与合并。
分裂是按照数值分裂,把一棵 Treap 拆成两棵树,其中一棵中的所有数值都 $\geq x$,另外一棵都 $<x$。合并是合并两棵数值不交的 Treap,合并为一棵大 Treap。
那么我们可以首先想出这么做:插入元素 $x$ 的时候,分裂出 $<x$ 和 $\geq x$ 的两棵树,记为 $T_l$ 和 $T_r$,那么我们先合并 $T_l$ 和新插入的元素,然后合并 $T_r$ 和 $T_l$ 就习惯了。
删除的时候首先切出来三个子树,$T_l$ 表示 $<x$ 的树,$T_r$ 表示 $>x$ 的树,$T_x$ 表示 $=x$ 的树,然后我们合并 $T_x$ 根节点的左右孩子,这样根节点就没了,也就是删掉了一个 $x$。然后我们将新的 $T_l, T_r, T_x$ 合并起来就可以了。
其余操作可以仿照二叉搜索树做,或者也可以使用分裂合并。前驱就是分裂出 $<x$ 和 $\geq x$ 的两棵树,然后在 $<x$ 的树里面找最大就行了,后继类似。排名的时候可以分裂出 $<x$ 的树,那么答案就是 $<x$ 的树的大小。$k$ 大这个是需要自己写的,树里面找最大值 / 最小值也可以利用 $k$ 大。
那么假如我们可以支持分裂和合并,六个操作都是简单的。首先从分裂开始吧,用插入操作讲解。使用之前的 Treap:

现在我们需要再插入一个 $6$,那么我们对于这棵树分裂出 $<6$ 和 $\geq 6$ 的部分:
其中橙色的是切割线,红色的是被删掉的边,虚线是新添加的边。容易发现每一层只会删一条边,删掉了 $k$ 条边,那么会补上 $k-1$ 条边,所以总共的边数变化是 $O(\log n)$ 条边。
那么我们的重点在于怎么维护每一个点应该被接到的父亲。这个其实很简单,直接在递归过程中传下去就可以了!
我们定义 $d(u,k,l,r)$ 表示当前递归进行到 $u$,分裂的数字是 $k$,假如分裂到左边应该接上的节点是 $l$,假如分裂到右边应该接上的节点是 $r$,那么会有如下的递归关系($w_u$ 表示 $u$ 节点的数字):
$$\begin{cases}d(lc_u,k,l,u) &w_u\geq k\\d(rc_u,k,u,r)&w_u<k\end{cases}$$
为什么呢?我们发现我们每一次接上的都是被划在切割线这一边最近的一个节点。所以说,假如这个分到了切割线右边,右边的节点以后就应该接到它上面了;否则左边的节点以后就应该接到它上面去了。
然后由于是按着数值分裂的,所以我们还是直接在平衡树上二分这样的递归。代码张这样,非常优美啊,主要是使用了引用。初始的时候给 $l,r$ 传进去一些东西,还可以得到左右子树的根,这样就非常方便。
```cpp
void split(int u, int x, int &L, int &R) {
if(!u) return L = R = 0, void();
if(m[u].val <= x) {
L = u;
split(m[u].rc, x, m[u].rc, R);
} else {
R = u;
split(m[u].lc, x, L, m[u].lc);
}
pushup(u);
}
```
其实认真想想分裂做了什么,其实是把一条链给拆成两条链罢了。
现在已经会分裂操作了,来想想同样重要的合并操作。现在我们已经得到了两棵新的树了。现在我们要插入一个键值为 $7$ 的元素 $6$,那么就可以这么合并左边的子树和 $6$:
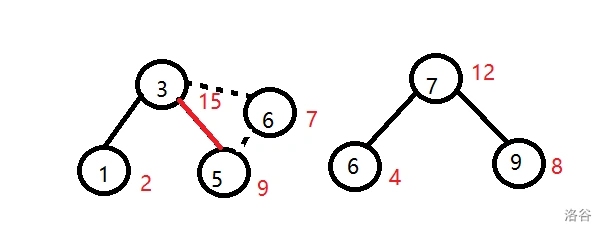
可以发现其实是把最右边的一条链给拆开了,并且对于一些拆开的给添加几条边加在链上,成为一条长链。或者也可以理解为把左边这棵树的最右链和右边这棵树的最左链合二为一。
于是每一次合并的时候,我们可以维护左边和右边待合并的位置,然后返回合并之后的根,来接到目前递归到的节点。设 $d(l,r)$ 表示目前左边待合并的节点为 $l$,右边待合并的节点是 $r$。所以我们要维护一个大根堆,也就是把键值更大的先合并。
我们设 $k_x$ 表示 $x$ 的键值,那么分类讨论:
- $k_l\geq k_r$ 的时候:我们先合并 $l$ 这个节点,然后我们应该沿着 $l$ 的最右链做合并。也就是 $rc_l\leftarrow d(rc_l, r)$,然后返回 $l$ 为根。
- 否则,我们让 $r$ 为根,然后沿着 $r$ 的最左链继续合并,相当于 $lc_r\leftarrow d(l,lc_r)$。
现在思路已经清晰了,那么就应该给代码了。实际上,合并操作本质相当于双指针左边这棵树的最右链和右边这棵树的最左链。
```cpp
int merge(int L, int R) {
if(!L || !R) return L + R;
if(m[L].fix < m[R].fix) {
m[L].rc = merge(m[L].rc, R);
pushup(L);
return L;
} else {
m[R].lc = merge(L, m[R].lc);
pushup(R);
return R;
}
}
```
所以完整代码就容易实现,呼之欲出了。下面是完整实现(也是稍微有点远古的代码):
::::success[code]
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 1e5 + 10;
struct node {
int lc, rc, val, siz, fix;
} m[N];
int root, t;
void newn(int v) {
t++;
m[t].fix = rand();
m[t].lc = m[t].rc = 0;
m[t].siz = 1;
m[t].val = v;
}
void pushup(int u) {
m[u].siz = m[m[u].lc].siz + m[m[u].rc].siz + 1;
}
void split(int u, int x, int &L, int &R) {
if(!u) return L = R = 0, void();
if(m[u].val <= x) {
L = u;
split(m[u].rc, x, m[u].rc, R);
} else {
R = u;
split(m[u].lc, x, L, m[u].lc);
}
pushup(u);
}
int merge(int L, int R) {
if(!L || !R) return L + R;
if(m[L].fix < m[R].fix) {
m[L].rc = merge(m[L].rc, R);
pushup(L);
return L;
} else {
m[R].lc = merge(L, m[R].lc);
pushup(R);
return R;
}
}
void insert(int x) {
int L = 0, R = 0;
newn(x);
split(root, x, L, R);
root = merge(merge(L, t), R);
}
void del(int x) {
int L = 0, R = 0, mid = 0;
split(root, x - 1, L, R);
split(R, x, mid, R);
mid = merge(m[mid].lc, m[mid].rc);
root = merge(merge(L, mid), R);
}
int kth(int u, int k) {
if(k == m[m[u].lc].siz + 1) return u;
if(k > m[m[u].lc].siz + 1) return kth(m[u].rc, k - m[m[u].lc].siz - 1);
return kth(m[u].lc, k);
}
int rnk(int x) {
int L = 0, R = 0;
split(root, x - 1, L, R);
int res = 1 + m[L].siz;
root = merge(L, R);
return res;
}
int pre(int x) {
int L = 0, R = 0;
split(root, x - 1, L, R);
int res = m[kth(L, m[L].siz)].val;
root = merge(L, R);
return res;
}
int nxt(int x) {
int L = 0, R = 0;
split(root, x, L, R);
int res = m[kth(R, 1)].val;
root = merge(L, R);
return res;
}
int main() {
srand(19491001);
ios :: sync_with_stdio(0);
cin.tie(0); cout.tie(0);
int n;
cin >> n;
for(int i = 1; i <= n; i++) {
int op, x;
cin >> op >> x;
switch(op) {
case 1: insert(x); break;
case 2: del(x); break;
case 3: cout << rnk(x) << endl; break;
case 4: cout << m[kth(root, x)].val << endl; break;
case 5: cout << pre(x) << endl; break;
case 6: cout << nxt(x) << endl; break;
}
}
return 0;
}
```
::::
## 13.4 splay
其实这个好像用处不大来着,因为 S 不需要 LCT。但是看在它是竞赛曾经最常用平衡树,还是给一些面子吧。
Treap 的平衡方式是随机钦定插入顺序,它依赖随机,所以可能会被破解出随机种子然后 Hack 掉(虽然基本卡不了)。但是有没有一种不依赖随机的平衡树呢?有的,就是 Splay。
Splay 的调整方法如下:在暴力递归的路径上观察不平衡的地方,看到不平衡就直接调整。具体是怎么平衡的呢?它使用了一个技巧,叫做**双旋**。它在每一次操作之后,把一个操作的节点给双旋到根,这样就可以调整不平衡的状态了。
但是什么是双旋,它为什么可以调整平衡性呢?我们以下称将 $u$ 与 $u$ 的父亲交换的旋转操作为“旋转 $u$”。
我们要旋转一个点 $u$ 的时候,记 $u$ 的父亲为 $f$,$f$ 的父亲为 $g$。首先假如 $g$ 不存在,那么直接旋转 $u$ 就可以了。否则:
- 假如 $u, f, g$ 三点共线,那么先旋转 $f$,再旋转 $u$。
- 否则,先旋转 $u$,再旋转 $f$。
这种旋转究竟是怎么调整平衡的呢?首先第一种旋转,看看它造成的效果:
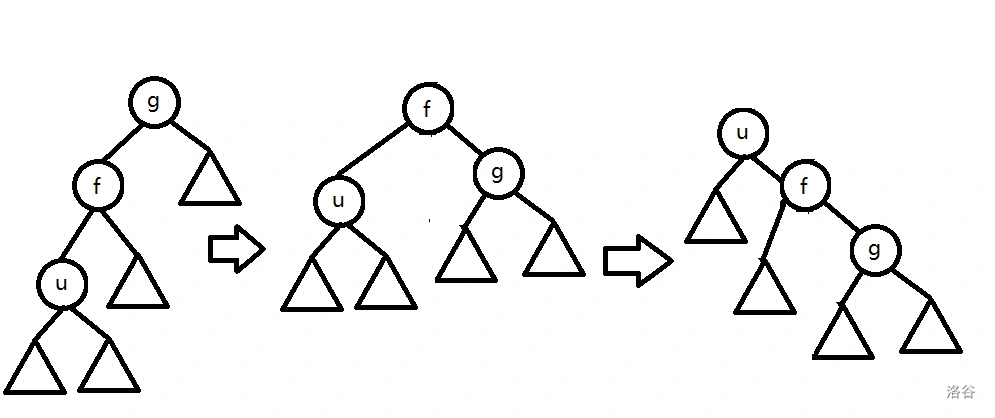
~~画的好丑~~
乍一看,$u,f,g$ 好像还是三点共线的,一点都不优秀啊!但是实际上也只能让 $u,f,g$ 三个点占的高度为 $3$,因为我们让最小值为根了。接着,让大家看看双旋到底是怎么调整平衡性的,假如我们有一条长度为 $5$ 的链,现在想要把底端的数给转到根去。
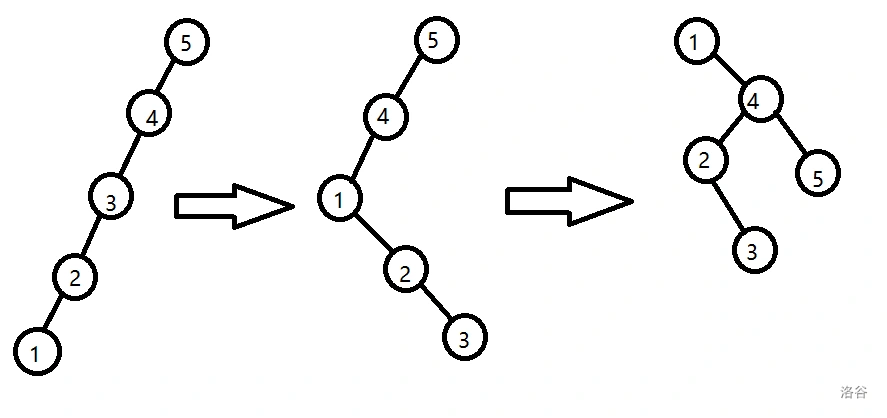
容易发现现在树高变小了,原本的高度为 $5$,现在的高度为 $4$。假如我们一层一层的转的话,树高还是 $5$,大家可以自行模拟一下。
然后对于一条长链,这样旋转是可以让长链的高度变为一半的,因为具体形如最右边的状态,也就是 $1$ 的右子树是一个链挂点,这里长度为 $2$,也就是 $4\to 2$ 这条链上挂了 $3, 5$ 这两个点。
容易证明,假如这条链的长度为 $2k + 1$,那么 $1$ 的右子树必定是 $2k\to 2k-2\to \ldots\to 2$ 这一条链挂上 $2k+1,2k-1,\ldots,3$ 这些点。这个证明自己手摸一下是怎么旋转的就行了,略去。
于是可以感性理解为:一次 splay 的旋转会使得向上旋转的这条链的长度减半。所以我们每一个节点只会在旋转中被减半高度 $O(\log n)$ 次,所以复杂度是均摊 $O(\log n)$ 的。但是其实有些旋转的时候节点高度是不会减半的而是减得更少,所以这个证明并不是严谨的,严谨证明需要用到势能分析,篇幅比较长,本文不放,如果有兴趣请自行前往 [OI Wiki](https://oi-wiki.org/ds/splay/#%E4%BC%B8%E5%B1%95%E6%93%8D%E4%BD%9C) 学习。
splay 由于旋转较为复杂,所以写类似 Treap 的交换节点旋转的话会使得实现比较困难(虽然当然可以写),但是一般就老老实实的模拟旋转。比如这里,旋转是这样的:
```cpp
void pushup(int x) {
t[x].siz = t[t[x].ch[0]].siz + t[t[x].ch[1]].siz + t[x].cnt;
}
bool type(int x) {
return t[t[x].fa].ch[1] == x;
}
void rotate(int x) {
int f = t[x].fa, g = t[f].fa;
bool ws = type(x);
int b = t[x].ch[ws ^ 1];
t[g].ch[type(f)] = x;
t[f].ch[ws] = b;
t[x].ch[ws ^ 1] = f;
t[x].fa = g;
t[f].fa = x;
t[b].fa = f;
pushup(f);
pushup(x);
}
```
`type` 函数求的是 $x$ 是左儿子还是右儿子,`pushup` 就是维护信息。
旋转操作模拟的东西在 Treap 章节已经详细分析,在这里不多赘述。接着是最关键的操作,把一个节点转到根:
```cpp
void splay(int x) {
while(t[x].fa) {
if(t[t[x].fa].fa) {
if(type(t[x].fa) == type(x)) rotate(t[x].fa);
else rotate(x);
}
rotate(x);
}
root = x;
}
```
这个函数的作用就是在过程中用双旋维护平衡。直接模拟了之前讲述的操作,在最后更新了树根。于是有了最关键的 splay 函数了,其余的操作都很好做了,记得每次操作之后一定要 splay 一个点。
特别说一下删除操作。删除操作可以首先将 $x$ 的前驱给转到根,那么现在待删除节点必定在根的右孩子的最左链的端点。假如个数大于 $1$,那么直接减掉就可以了。假如个数小于 $1$,那么这个点必定不存在左孩子,所以使用右孩子换掉这个点,可以发现整棵树还是满足平衡树性质。为了方便处理一些 corner case,我们先往树里插入两个哨兵,分别是 $+\infin$ 和 $-\infin$,这样可以规避掉很多的 corner case。
下面给出完整代码:
::::success[code]
```cpp
#include <bits/stdc++.h>
#define int long long
#define endl '\n'
using namespace std;
const int N = 1e5 + 10;
struct node {
int fa, ch[2], val, siz, cnt;
void init(int _v, int _f) {
val = _v, fa = _f;
cnt = 1;
siz = 1;
}
} t[N];
int tot, root;
void pushup(int x) {
t[x].siz = t[t[x].ch[0]].siz + t[t[x].ch[1]].siz + t[x].cnt;
}
bool type(int x) {
return t[t[x].fa].ch[1] == x;
}
void rotate(int x) {
int f = t[x].fa, g = t[f].fa;
bool ws = type(x);
int b = t[x].ch[ws ^ 1];
t[g].ch[type(f)] = x;
t[f].ch[ws] = b;
t[x].ch[ws ^ 1] = f;
t[x].fa = g;
t[f].fa = x;
t[b].fa = f;
pushup(f);
pushup(x);
}
void splay(int x) {
while(t[x].fa) {
if(t[t[x].fa].fa) {
if(type(t[x].fa) == type(x)) rotate(t[x].fa);
else rotate(x);
}
rotate(x);
}
root = x;
}
void insert(int x) {
int u = root, f = 0;
while(u) {
f = u;
if(t[u].val == x) break;
u = t[u].ch[x > t[u].val];
}
if(t[f].val == x) {
t[f].cnt ++;
t[f].siz ++;
splay(f);
}
else {
u = ++ tot;
t[f].ch[t[f].val < x] = u;
t[u].init(x, f);
splay(u);
}
}
int pre(int x) {
int u = root, f = root, res = INT_MIN;
while(u) {
if(t[u].val < x) f = u, res = t[u].val, u = t[u].ch[1];
else u = t[u].ch[0];
}
splay(f);
return res;
}
int nex(int x) {
int u = root, f = root, res = INT_MAX;
while(u) {
if(t[u].val > x) f = u, res = t[u].val, u = t[u].ch[0];
else u = t[u].ch[1];
}
splay(f);
return res;
}
int kth(int x) {
int u = root;
while(1) {
if(t[t[u].ch[0]].siz >= x) {
u = t[u].ch[0];
} else if(t[t[u].ch[0]].siz + t[u].cnt < x) {
x -= (t[t[u].ch[0]].siz + t[u].cnt);
u = t[u].ch[1];
} else break;
}
splay(u);
return t[u].val;
}
int rnk(int x) {
int u = root, res = 0, f;
while(u) {
f = u;
if(t[u].val >= x) {
u = t[u].ch[0];
} else {
res += t[t[u].ch[0]].siz + t[u].cnt;
u = t[u].ch[1];
}
}
splay(f);
return res;
}
void del(int x) {
pre(x);
int u = t[root].ch[1], f;
while(u) f = u, u = t[u].ch[0];
if(t[f].cnt > 1) {
t[f].siz --;
t[f].cnt --;
splay(f);
} else {
int F = t[f].fa;
t[F].ch[type(f)] = t[f].ch[1];
t[t[f].ch[1]].fa = F;
splay(F);
}
}
signed main() {
int n;
cin >> n;
insert(1e8); insert(-1e8);
while(n--) {
int op, x;
cin >> op >> x;
switch(op) {
case 1 : insert(x); break;
case 2 : del(x); break;
case 3 : cout << rnk(x) << endl; break;
case 4 : cout << kth(x + 1) << endl; break;
case 5 : cout << pre(x) << endl; break;
case 6 : cout << nex(x) << endl; break;
}
}
}
```
::::
## 13.5 文艺平衡树
这是一个很牛的东西。它支持线段树的所有操作,同时还可以做这些额外的操作:
- $O(\log n)$ 单点插入。
- $O(l+\log n)$ 区间插入。($l$ 表示区间长度)
- $O(\log n)$ 区间翻转。
- $O(\log n)$ 区间删除。
具体是怎么做的呢?听到文艺平衡树,那么肯定就是平衡树了。只不过,这个平衡树维护的不是数的集合,而是序列。实际上,这个维护是很简单的,把插入的数值换成序列上的位置就可以了。
由于有区间操作,所以我们的平衡树必须要支持拉出来一段值域上的区间,这个操作 FHQ-Treap 和 Splay 都是可以的,但是 Treap 不太行。FHQ-Treap 是简单的,拉出区间 $[l, r]$ 的时候首先按照 $<l$ 和 $\geq l$ 分裂,然后对于 $\geq l$ 的这棵树按照 $\leq r$ 和 $>r$ 分裂就可以拉出区间了。Splay 的方法是找到 $l$ 的前驱和 $r$ 的后继,首先把 $l$ 的前驱转到根,然后把 $r$ 的后继转为 $l$ 的前驱的右孩子,这个时候 $r$ 后继的左孩子的值域就正好是 $[l, r]$ 了。
接着,我们发现单点插入,区间删除都是显而易见的了。单点插入位置 $x$,就是往平衡树里插入一个排名为 $x$ 的节点。对于 Splay,就是首先把排名为 $x-1$ 的这个数转到根,那么 $x$ 应该是它右孩子中最小的点,按照右孩子的最左链给一直找下去,在链尾加入这个节点就可以了。
区间删除就是首先拉出 $[l, r]$ 的区间,然后去除其与主树的联系就可以了,FHQ-Treap 就是首先分裂出 $[l, r]$ 然后直接合并 $<l$ 和 $>r$ 的部分,Splay 就是把这棵子树转出来之后直接切断其与父亲的关系。
区间插入也是容易的,首先可以 $O(n)$ 构造一棵平衡树(对于 Splay 这是容易的,对于 FHQ-Treap 也是可以做到的,具体做法在笛卡尔树)然后使用和单点插入同样的方法就可以了。
做任何类似于线段树的区间修改,都可以把这一段区间给拉出来,然后打一个懒标记就行了。
最后是区间翻转操作,这也是[模板题](https://www.luogu.com.cn/problem/P3391)的操作,所以可以认为是文艺平衡树最有代表性的操作。首先还是区间操作,所以我们先把 $[l, r]$ 给拉出来,然后打一个翻转标记。
根据经典结论,一个区间的翻转,相当于分成两部分,分别翻转,然后再把右边拼到左边的前面去。所以说,我们对于文艺平衡树的这个区间可以直接打一个翻转标记,然后每一次下传标记的时候交换它的左右儿子,并且对于左右儿子都打上标记,这样就可以正确的做区间翻转了。那么线段树不能做的原因也显而易见了,它不能拆出来一个子树代表一个区间。
所以模板题就很好做了,给出 FHQ-Treap 和 Splay 两种实现:
::::success[FHQ-Treap]
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
int seed = 19491001;
int rd() {
seed ^= seed << 13;
seed ^= seed >> 9;
seed ^= seed << 17;
return seed;
}
const int N = 1e5 + 10;
int n, m;
struct node {
int val, lc, rc, siz, fix, lazy;
} t[N];
int root, tp;
void newn(int x) {
tp++;
t[tp].lc = t[tp].rc = 0;
t[tp].siz = 1;
t[tp].val = x;
t[tp].fix = rd();
}
void pushup(int x) {
t[x].siz = t[t[x].lc].siz + t[t[x].rc].siz + 1;
}
void push_down(int x) {
if(t[x].lazy != 0) {
swap(t[x].lc, t[x].rc);
if(t[x].lc) t[t[x].lc].lazy ^= 1;
if(t[x].rc) t[t[x].rc].lazy ^= 1;
t[x].lazy = 0;
}
}
void split(int u, int x, int &L, int &R) {
if(!u) return L = R = 0, void();
push_down(u);
if(t[t[u].lc].siz <= x) {
L = u;
split(t[u].rc, x - t[t[u].lc].siz - 1, t[L].rc, R);
pushup(u);
} else {
R = u;
split(t[u].lc, x, L, t[R].lc);
pushup(u);
}
}
int merge(int L, int R) {
if(!L || !R) return L + R;
if(t[L].fix > t[R].fix) {
push_down(L);
t[L].rc = merge(t[L].rc, R);
pushup(L);
return L;
} else {
push_down(R);
t[R].lc = merge(L, t[R].lc);
pushup(R);
return R;
}
}
void insert(int x) {
int L = 0, R = 0;
newn(x);
split(root, x - 1, L, R);
root = merge(merge(L, tp), R);
}
void rev(int l, int r) {
int L = 0, R = 0, mid = 0;
split(root, l - 2, L, R);
split(R, r - l, mid, R);
t[mid].lazy ^= 1;
root = merge(merge(L, mid), R);
}
void print(int u) {
if(!u) return;
push_down(u);
print(t[u].lc);
cout << t[u].val << " ";
print(t[u].rc);
}
int main() {
ios :: sync_with_stdio(0);
cin.tie(0); cout.tie(0);
cin >> n >> m;
for(int i = 1; i <= n; i++) insert(i);
for(int i = 1; i <= m; i++) {
int l, r;
cin >> l >> r;
rev(l, r);
}
print(root);
return 0;
}
```
::::
::::success[Splay]
这个的建树方法和 FHQ-Treap 不同,Treap 是一个节点一个节点插入的,Splay 利用了初始形态可以任意的性质直接 $O(n)$ 建了一棵完全平衡的 Splay。
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 1e5 + 5;
int n, m, cnt = 1, root = 1;
struct Node { int fa, ch[2], pos, lazy, siz; } t[N];
bool type(int x) {
return t[t[x].fa].ch[1] == x;
}
void pushup(int x) {
t[x].siz = 1;
if(t[x].ch[0]) t[x].siz += t[t[x].ch[0]].siz;
if(t[x].ch[1]) t[x].siz += t[t[x].ch[1]].siz;
}
void build(int l, int r, int u) {
t[u].pos = (l + r >> 1);
t[u].siz = 1;
if(l == r) return;
if(l <= (l + r >> 1) - 1) {
t[u].ch[0] = ++ cnt;
t[t[u].ch[0]].fa = u;
build(l, (l + r >> 1) - 1, t[u].ch[0]);
}
if((l + r >> 1) + 1 <= r) {
t[u].ch[1] = ++ cnt;
t[t[u].ch[1]].fa = u;
build((l + r >> 1) + 1, r, t[u].ch[1]);
}
pushup(u);
}
void push_down(int x) {
if(t[x].lazy) {
swap(t[x].ch[0], t[x].ch[1]);
if(t[x].ch[0]) t[t[x].ch[0]].lazy ^= 1;
if(t[x].ch[1]) t[t[x].ch[1]].lazy ^= 1;
t[x].lazy = 0;
}
}
void rotate(int x) {
int f = t[x].fa, g = t[f].fa;
push_down(f), push_down(x);
int ws = type(x), b = t[x].ch[ws ^ 1];
t[g].ch[type(f)] = x, t[f].ch[ws] = b, t[x].ch[ws ^ 1] = f;
t[x].fa = g, t[f].fa = x, t[b].fa = f;
pushup(f), pushup(x);
}
void splay(int x, int ff = 0) {
while(t[x].fa != ff) {
int f = t[x].fa;
if(t[f].fa != ff) rotate(type(f) == type(x) ? f : x);
rotate(x);
}
if(ff == 0) root = x;
}
int findkth(int k) {
int u = root;
while(1) {
push_down(u);
int ls = t[t[u].ch[0]].siz;
if(k == ls + 1) { splay(u); return u; }
else if(k > ls + 1) k -= ls + 1, u = t[u].ch[1];
else u = t[u].ch[0];
}
}
void output(int u) {
push_down(u);
if(t[u].ch[0]) output(t[u].ch[0]);
if(t[u].pos != 0 && t[u].pos != n + 1) cout << t[u].pos << " ";
if(t[u].ch[1]) output(t[u].ch[1]);
}
int main() {
ios :: sync_with_stdio(0);
cin.tie(0), cout.tie(0);
cin >> n >> m;
build(0, n + 1, 1);
for(int i = 1; i <= m; i ++ ) {
int l, r; cin >> l >> r;
int L = findkth(l), R = findkth(r + 2);
splay(L), splay(R, L);
t[t[t[root].ch[1]].ch[0]].lazy ^= 1;
}
output(root);
return 0;
}
```
::::
然后给出一些练习题(平衡树的题都放这里了,大部分是文艺平衡树):
- [【模板】普通平衡树(数据加强版)](https://www.luogu.com.cn/problem/P6136)
- [序列终结者](https://www.luogu.com.cn/problem/P4146)
- [文本编辑器](https://www.luogu.com.cn/problem/P4008)
- [文本编辑器](https://www.luogu.com.cn/problem/P4567)
- [维护数列](https://www.luogu.com.cn/problem/P2042)
- [CCD 的序列](https://www.luogu.com.cn/problem/P14761)
- [数列](https://www.luogu.com.cn/problem/P2710)
从这些题目要求的众多操作,就可以看出来文艺平衡树是一个功能强大的数据结构啊。~~就是常数有点大。~~
::::success[题解]
### 【模板】普通平衡树(数据加强版)
和之前的模板题大同小异,只是增加了强制在线并且加大了数据,显然是想要强迫你写平衡树。那么直接在【模板】普通平衡树上加以修改就可以了。
~~虽然空间比较大所以动态开点权值线段树和 0-1 Trie 都可以过。~~
### 序列终结者
一个操作比较少的文艺平衡树题。~~题目口气倒是挺大。~~
于是对于区间加操作,直接维护加标记,对于最大值标记的更新已经在线段树章节讲的很清楚了。记得更新信息的时候千万不要因为线段树写多了,漏掉自己对于区间和的贡献。
### 文本编辑器
两个文本编译器大同小异。啊这个题怎么是块状链表模板。不管了,文艺平衡树 NB。
我们首先维护光标的位置,不是移动光标的操作就可以转化为区间删除,区间插入和区间查询值。
前两个操作都写的比较清楚了,那么问题就来到了区间查询了。同样拉出一棵子树作为待查询区间,然后直接中序遍历这棵子树就可以了,复杂度同样 $O(l+\log n)$。
但是要注意常数,删除的时候不能一个点一个点删除,插入的时候也不能一个点一个点的插入,不然会被卡常。
### 维护数列,数列
这两个题除了数列多了一个单点查询以外没有区别,显然不是重点。
重点应该在于最大子段和。依旧沿用左中右线段树的思路,维护区间和,最大前缀和,最大后缀和,区间最大子段和,那么区间修改为 $c$ 的时候,操作是这样的(设区间长度为 $l$):
- 最大前缀和,最大后缀和,区间最大子段和均为 $\max(cl,c)$。
- 区间和变为 $cl$。
然后更新信息的时候,需要将自己这个点也纳入最大子段和的考虑范围之中,其实修改并不多,只需要将跨左右区间的贡献都给加上它自身的值就可以了。
这个题稍微有点卡空间,有两种写法:第一种是能开 short 的地方就开 short,第二种是回收节点,就是我们假如删除了一个子树,那么这个子树中的节点现在就没用了,以后可以回收利用,可以放到一个栈里,每次新开节点的时候优先选择回收栈里的节点,如果没有才新开一个。
### CCD 的序列
我写过[题解。](https://www.luogu.com.cn/article/iyawxkh8)
::::
# *14. 笛卡尔树
## 14.1 基本概念
其实笛卡尔树也就是 Treap,不过数字和键值都是给定了的。比如[模板题](https://www.luogu.com.cn/problem/P5854)就是这样的,直接给你按照数字排序好的键值,让你构建一棵 Treap。
首先按照普通 Treap 的做法肯定是没救的。因为键值都给定了,树高就可以很容易的构造到 $O(n)$,逐一插入就变成 $O(n^2)$ 的了。
但是 FHQ-Treap 的合并方法看起来是比较有希望的,因为它只考虑待合并的树的最右链。最右链的权值从上到下肯定是从大到小的,所以说我们可以直接维护这棵树的最右链。
每一次加入一个节点(键值为 $w$)的时候,我们考虑 FHQ-Treap 的合并过程,其实就是把最右链中 $>w$ 键值的数的这条链拆出来,然后把 $w$ 接在最靠下的键值小于 $w$ 的节点的左端点,把拆下来的链接在这个点的右边。比如说,往这棵树中插入一个权值最大,键值为 $2$ 的数,就会有如下的变化:
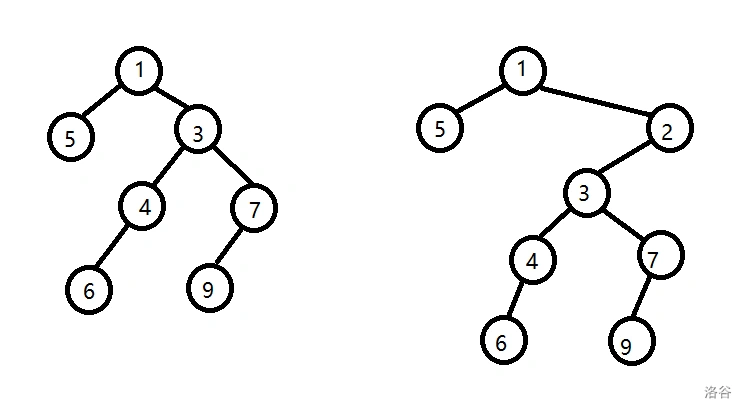
可以发现 $3$ 为根的子树整个被拆下来挂到了 $2$ 的左儿子。所以我们可以维护这棵树最靠右的一条链,每一次插入的时候把最靠右的一条链给按照键值拆开,键值大于它的就被塞到它的右子树,键值小于它最下面一个节点就当它的父亲。
然后具体怎么维护这个东西呢?其实非常简单,由于每一个节点只会被从最右链中踢出去一次,所以我们直接维护一个键值的单调栈当做最右链就可以了。
## 14.2 代码实现
其实这个东西的代码非常短的。记新插入的数为 $x$。
实际上就是维护一个单调栈,我们对于单调栈中键值 $<w$ 的数一直弹栈,然后维护从栈中弹出来的最后一个数(记为 $l$),访问栈顶的数(记为 $t$)。
那么可以直接这么更新树的形态:$lc_x\leftarrow l$,$rc_t\leftarrow x$。那么代码就很好写出来了:
```cpp
for(int i = 1; i <= n; i ++ ) {
int las = 0;
while(!st.empty() && p[st.top()] >= p[i]) {
las = st.top();
st.pop();
}
if(!st.empty()) rc[st.top()] = i;
lc[i] = las;
st.push(i);
}
```
[模板题](https://www.luogu.com.cn/problem/P5854)的代码实现如下(嗯,又回到了短短的代码):
::::success[code]
```cpp
#include <bits/stdc++.h>
#define endl '\n'
using namespace std;
const int N = 1e7 + 5;
int n, p[N], lc[N], rc[N];
stack<int> st;
int main() {
ios :: sync_with_stdio(0);
cin.tie(0), cout.tie(0);
cin >> n;
for(int i = 1; i <= n; i ++ ) cin >> p[i];
for(int i = 1; i <= n; i ++ ) {
int las = 0;
while(!st.empty() && p[st.top()] >= p[i]) {
las = st.top();
st.pop();
}
if(!st.empty()) rc[st.top()] = i;
lc[i] = las;
st.push(i);
}
long long ans1 = 0, ans2 = 0;
for(int i = 1; i <= n; i ++ ) {
ans1 ^= 1LL * i * (lc[i] + 1);
ans2 ^= 1LL * i * (rc[i] + 1);
}
cout << ans1 << " " << ans2 << endl;
return 0;
}
```
::::
最后给出一些练习题:
- [Hz 吐泡泡](https://www.luogu.com.cn/problem/P2171)
- [最大的矩形纸片](https://www.luogu.com.cn/problem/B4273)
- [良好的感觉](https://www.luogu.com.cn/problem/P2422)
::::success[题解]
### Hz 吐泡泡
笑点解析:之前这个题的数据很水,可以暴力插入二叉搜索树,然后是个黄。
我们思考二叉搜索树的本质,其实就是权值为数字,键值为插入顺序的一棵笛卡尔树(维护的是小根堆)。所以说,直接建笛卡尔树即可。
### 最大的矩形纸片
其实这个题可以单调栈出每个点左右第一个小于它的节点,然后直接枚举最大值做完了。
但是其实也可以使用笛卡尔树做。我们以位置为数字,高度为键值建笛卡尔树(小根堆),你就会发现一个节点的子树正好是它所在的一个极大的每个数都大于等于它的区间。
那么我们直接处理出笛卡尔树的子树大小了,然后枚举最小值是哪个节点就可以了。
### 良好的感觉
这个题和前面那个题其实大同小异,依然直接使用笛卡尔树处理出每一个节点对应的区间。
然后我们做子树和的时候从子树大小改为每一天的感觉良好成都之和就可以了。
::::
# 15. 树上倍增
## 15.1 基本概念
我们首先考虑树上一个非常基础的问题:求 LCA。一种自然的想法如下:
- 假设我们要求 $u, v$ 的 LCA,为了处理方便,首先将 $u, v$ 调整到同一高度。
- 接着每一次操作让 $u, v$ 向上跳一步,一直跳到 $u, v$ 相同为止。那么第一个相同的点就是 LCA。
但是这样做是 $O(n)$ 的,一条链就可以轻松卡掉,太弱了。但是我们需要意识到一件事情:我们需要的两个操作都是具有单调性的。比如操作 $1$,假如我们规定 $u$ 的最初深度一定大于 $v$ 的话,那么肯定是有一段 $u$ 的深度小于等于 $v$,然后后一段大于。第二个也一样,肯定是首先一段 $u, v$ 不同,然后一段 $u, v$ 相同。
看到了单调性,很自然的可以想到二分。所以说,我们可以首先二分 $u, v$ 向上跳的祖先层数,然后直接做就可以了。但是实际上这个需要求 $u, v$ 的任意级祖先,低复杂度的做这个是困难的。
但是这个做法可以改进。我们之前在树状数组倍增章节提到了另一种二分,就是从高往低考虑 $2$ 的幂,假如 $+2^i$ 是合法的就加上 $2^i$。我们可以这样做二分,那么这个时候我们就只需要知道每个节点的 $2^k$ 级祖先了,记 $f(u,k)$ 表示 $u$ 的 $2^k$ 级祖先,那么有如下递推关系:
$$f(u,k)=f(f(u,k-1),k-1)$$
为什么呢?上面的这个式子就相当于在树上先跳了 $2^{k-1}$ 步然后又跳了 $2^{k-1}$ 步,也就相当于跳了 $2^k$ 步。
于是求 LCA 的时候可以直接这么做,第一次使用倍增式二分来将 $u, v$ 调整到同一高度,第二次使用倍增式二分找到 $u, v$ 不同的最后一级祖先(相同的第一级并不好找,因为判断是不是第一级是困难的),然后输出它的父亲就可以了。
记得特判祖先的情况,就是调整到相同高度之后假如 $u, v$ 已经有祖先关系了就不要再取父亲了。
同时,树上倍增不仅可以维护树上的 LCA,还可以维护树上的支持结合律的信息。比如说链上的和,异或和,按位与,按位或,$\gcd$,$\max$,$\min$,等等。
之前我们已经定义了 $f(x, k)$ 了,现在我们定义 $g(x, k)$ 表示 $x$ 的 $2^k$ 级父亲到 $x$ 的链上的信息。那么可以写出如下的递推式:
$$g(x,k)=g(x,k-1)\oplus g(x,f(x,k-1))$$
其中 $\oplus$ 表示信息合并运算。这个可以理解为,把 $2^k$ 长度的这条链的前 $2^{k-1}$ 长度和后 $2^{k-1}$ 长度给拼起来。
每一次做链查询的时候,也类似 LCA 这么做就可以了,每一次向上跳祖先的时候(也就是倍增式二分中再往上 $2^i$ 级祖先合法的时候)合并信息即可。
## 15.2 代码实现
其实树上倍增的实现中预处理比较像 ST 表。大致就是按照上述递推式子直接推就行了,比如求 LCA 的时候就是这样的:
```cpp
void init() {
rep(i, 1, __lg(n))
rep(j, 1, n) go[j][i] = go[go[j][i - 1]][i - 1];
}
```
其实非常容易理解的,就是一个朴素的递推。关键在于求 LCA:
```cpp
int lca(int u, int v) {
if(dep[u] < dep[v]) swap(u, v);
per(i, __lg(n), 0) if(dep[go[u][i]] >= dep[v]) u = go[u][i];
if(u == v) return u;
per(i, __lg(n), 0) {
if(go[u][i] != go[v][i]) {
u = go[u][i];
v = go[v][i];
}
}
return go[u][0];
}
```
首先第一行是为了强制令 $u$ 是更深的那个节点,这样就可以直接把 $u$ 上跳,而不需要讨论深度了。
然后就是直接对于 $u$ 调整高度,判断是否具有祖先关系,然后倍增式二分就可以了。于是也容易写出[模板题](https://www.luogu.com.cn/problem/P3379)的代码了。
::::success[code]
```cpp
#include <bits/stdc++.h>
#define rep(i, l, r) for(int i = l; i <= r; i ++ )
#define per(i, r, l) for(int i = r; i >= l; i -- )
#define endl '\n'
using namespace std;
const int N = 5e5 + 5;
int n, m, s, go[N][22], dep[N];
vector<int> t[N];
void dfs(int u, int fa) {
go[u][0] = fa;
dep[u] = dep[fa] + 1;
for(auto v : t[u]) {
if(v == go[u][0]) continue;
dfs(v, u);
}
}
void init() {
rep(i, 1, __lg(n))
rep(j, 1, n) go[j][i] = go[go[j][i - 1]][i - 1];
}
int lca(int u, int v) {
if(dep[u] < dep[v]) swap(u, v);
per(i, __lg(n), 0) if(dep[go[u][i]] >= dep[v]) u = go[u][i];
if(u == v) return u;
per(i, __lg(n), 0) {
if(go[u][i] != go[v][i]) {
u = go[u][i];
v = go[v][i];
}
}
return go[u][0];
}
int main() {
ios :: sync_with_stdio(0);
cin.tie(0), cout.tie(0);
cin >> n >> m >> s;
rep(i, 1, n - 1) {
int x, y;
cin >> x >> y;
t[x].push_back(y);
t[y].push_back(x);
}
dfs(s, 0);
init();
rep(i, 1, m) {
int a, b;
cin >> a >> b;
cout << lca(a, b) << endl;
}
return 0;
}
```
::::
然后给出一些练习题:
- [仓鼠找 sugar](https://www.luogu.com.cn/problem/P3398)
- [Fountain](https://www.luogu.com.cn/problem/P7167)
::::success[题解]
### 仓鼠找 sugar
手玩一下可以发现假如两条路径有公共点,一条路径的 LCA 必定在另一条路径上,并且这个条件充分必要。
充分性是显然的,因为 LCA 都在路径上了不可能没有公共点。必要性可以反证:假如 LCA 不在另一条路径上,那么这两条路径必然在某一点交叉,这个交点就有两个父亲了,显然不是一棵树。
然后在路径上该如何判断呢?假如 $u\to v\to w$ 和 $u\to w$ 这两条路是等价的,那么 $v$ 就在路径 $u\to w$ 上。因此,判断 $\operatorname{dis}(u,v)+\operatorname{dis}(v,w)=\operatorname{dis}(u,w)$ 是否成立就可以了。
于是可做,时间复杂度 $O(n\log n)$。
### Fountain
首先每个盘子的水肯定会被下面第一个大于它的圆盘给接住,而这个是容易单调栈一下求出来的。我们记点 $i$ 下面第一个大于它的圆盘是 $d_i$。为了处理方便,我们在最下面添加一个容量和半径都为无限的圆盘,代表水池。
那么我们对于每一个 $i$ 连边 $i\leftrightarrow d_i$,这样显然形成了一棵树,并且根是最后添加的那个容量为无限的圆盘。
一次添加,能够流到的圆盘是具有单调性的,是从 $r_i$ 到根的路径上的一段前缀,由于具有单调性,考虑直接二分这一段长度,同样使用倍增式二分。
所以我们对于每一个节点维护 $f(x,k)$ 表示 $x$ 的 $2^k$ 级祖先,$g(x,k)$ 表示 $x$ 到它的 $2^k$ 级祖先的链上圆盘半径的和。那么我们倍增式二分的时候,直接维护当前选了的圆盘的容量之和就可以了。
时间复杂度 $O(n\log n)$。
::::
## *15.3 图上的树
这一张的核心思想如下:对于一个图,找出一棵树(或者一棵森林)来维护需要求的信息,然后使用树上倍增维护这棵树,所以关键难点在于图到树的转化。
比如,我们以这道例题引入:[货车运输](https://www.luogu.com.cn/problem/P1967)。需要求的东西有一个学名,叫做**最小瓶颈路**。
首先,直接在图上做这个问题,显然是没有任何前途的。于是我们考虑找到一种结构,可以刻画两点间的最小瓶颈路。答案就是:最大生成树中两点之间的边权最小值。
为什么呢?感性理解一下,我们求最大生成树的时候使用的是 kruskal,那么是把边权从大到小考虑的,那么在 $u, v$ 两点连通的时候,肯定都是使用的尽可能大的边权,不可能更好了。
于是可以求出最大生成树,然后我们需要求出两点之间边权最大值。但是这里是边权而不是点权,该怎么做呢?我们可以采用一个常见的 Trick:边权转点权。就是我们首先钦定一个节点为根,然后每一条边连接的点肯定就具有父子关系了。并且,由于每个节点的父亲是唯一的,每一条边中连接的那个儿子也是唯一的。
所以我们可以直接把边权给挂到儿子的点权上就可以了。只不过需要注意一点,就是在路径上统计最小值的时候,不要把两个节点的 LCA 给统计进去了,因为两个节点的 LCA 挂的这一条边是 LCA 到它的父亲这条边,并不在路径上。
剩下的就是树上倍增模板了,没什么好说的。那么就直接给出代码吧(依旧远古代码):
::::success[code]
```cpp
#include <bits/stdc++.h>
#define PII pair<int, int>
#define se second
#define fi first
#define endl '\n'
using namespace std;
const int N = 5e4 + 10;
const int M = 1e4 + 10;
int n, m;
struct edge {
int u, v, w;
bool operator > (const edge &t) const {
return w > t.w;
}
} e[N];
vector<PII> vt[M];
int go[M][22], mx[M][22], dep[M], lg2[M];
struct dsu {
int f[M];
void init(int k) {for(int i = 1; i <= k; i++) f[i] = i;}
int find(int x) {return f[x] == x ? x : f[x] = find(f[x]);}
void merge(int x, int y) {f[find(x)] = find(y);}
} u;
void kruskal() {
u.init(n);
int cnt = 0;
for(int i = 1; i <= m && cnt < n - 1; i++) {
if(u.find(e[i].u) != u.find(e[i].v)) {
u.merge(e[i].u, e[i].v);
cnt++;
vt[e[i].u].push_back({e[i].v, e[i].w});
vt[e[i].v].push_back({e[i].u, e[i].w});
}
}
}
bool vis[M];
void dfs(int x, int d) {
vis[x] = true;
dep[x] = d;
for(int i = 0; i < vt[x].size(); i++) {
int v = vt[x][i].fi;
if(vis[v]) continue;
mx[v][0] = vt[x][i].se;
go[v][0] = x;
dfs(v, d + 1);
}
}
void init() {
lg2[0] = -1;
for(int i = 1; i <= n; i++) lg2[i] = lg2[i / 2] + 1;
for(int i = 1; i <= lg2[n]; i++)
for(int j = 1; j <= n; j++) {
go[j][i] = go[go[j][i - 1]][i - 1];
mx[j][i] = min(mx[j][i - 1], mx[go[j][i - 1]][i - 1]);
}
}
int q;
int get_mx(int u, int v) {
int res = 0x3f3f3f3f;
if(dep[u] < dep[v]) swap(u, v);
for(int i = lg2[n]; i >= 0; i--)
if(dep[go[u][i]] >= dep[v]) {
res = min(res, mx[u][i]), u = go[u][i];
}
if(u == v) return res;
for(int i = lg2[n]; i >= 0; i--) {
if(go[u][i] != go[v][i]) {
res = min(res, mx[u][i]), u = go[u][i];
res = min(res, mx[v][i]), v = go[v][i];
}
}
res = min(res, mx[u][0]);
res = min(res, mx[v][0]);
return res;
}
int main() {
ios :: sync_with_stdio(0);
cin.tie(0); cout.tie(0);
cin >> n >> m;
for(int i = 1; i <= m; i++) cin >> e[i].u >> e[i].v >> e[i].w;
sort(e + 1, e + m + 1, greater<edge>());
kruskal();
for(int i = 1; i <= n; i++) {
if(!vis[i]) dfs(i, 1);
}
init();
cin >> q;
for(int i = 1; i <= q; i++) {
int x, y;
cin >> x >> y;
if(u.find(x) != u.find(y)) cout << "-1\n";
else cout << get_mx(x, y) << endl;
}
return 0;
}
```
::::
最后给出练习题吧。
- [网络稳定性](https://www.luogu.com.cn/problem/P9235)
- [道路相遇](https://www.luogu.com.cn/problem/P4320)
- [严格次小生成树](https://www.luogu.com.cn/problem/P4180)
::::success[题解]
### 网络稳定性
啊,这个和货车运输是原题吧。
于是建出最大生成树,每一次倍增查询两两之间最小值就可以了。
### 道路相遇
这个题目,涉及到割点,一看就非常圆方树。
以防你不知道圆方树是什么,其实非常简单的。我们把这个图的所有点双连通分量给求出来,然后对于每一个点双连通分量开一个**方点**,对于原本的点叫做**圆点**,然后每个点双连通分量的圆点都朝方点连一条边,可以发现形成一棵树,这棵树被叫做圆方树。
所以我们把圆方树建出来,然后我们思考圆方树的性质。显然每一次必要的从点双连通分量之间的切换都必须要经过一个圆点(这个圆点也正好是进入新的点双连通分量的第一个节点),不必要的直接从方点走就可以了。
所以说,我们直接树上倍增,求出来两个点之间的圆点个数就可以了。这个问题可以对于圆点赋权 $1$,方点赋权 $0$,然后做路径求和。
### 严格次小生成树
考虑调整法,因为严格次小生成树和最小生成树必定最多差一条边。证明也是简单的,假如差两条边那么那棵生成树把另一条边给调到最小生成树上肯定是更优的。
所以我们可以枚举使用哪条边(不在树上)去替换树上的边。我们假设我们枚举到的边是 $u\leftrightarrow v$。
那么在最小生成树树上它可以替换的边就是在 $u$ 到 $v$ 的路径上的所有边。那么首先,替换掉最大值肯定是和最小生成树最接近的。
但是我们发现一个问题:替换最大值的话,假如最大值和我们枚举的边相同,那么是不满足严格次小的(是找了另一棵最小生成树),所以我们还需要尝试使用路径上的严格次小值来替换。
因此可以树上倍增维护路径上的最大值和**严格**次大值,然后依次考虑每一条非树边是否替换,时间复杂度 $O(m\log n)$。代码稍微难写,细节比较多。
::::
# 后记
完结撒花!
其实一开始是没想到这篇文章会写这么多的。但是由于 S 组的数据结构其实很丰富,写着写着就这么长了,最后还是及时写完了。
最后祝大家 CSP-J/S 2026 rp++,NOIP 2026 rp++!