Top Tree 详细教程:SATT 与动态仙人掌
Eaux
·
2026-11-11 16:40:28
·
算法·理论
0. 前言
保证人类贡献占绝对主导,由 DeepSeek-V4.1-Flash-1017 进行了一些简单勘误工作,第 5 章部分内容的编写经过了其辅助。
本文篇幅略长,对于细节的描述比较多,对于初学者可能比较友好(?,由于作者水平过低,内容可能并不深刻,各位轻喷。
1. 例题
I. Sone1
题目链接:P5649 Sone1。n 个节点的有根树,点带权,有 q 次操作,分为十二种:
0 x y 表示将 x 的子树中所有点权都改为 y ;
1 x 表示把树根换为 x 节点;
2 x y z 表示把 x 到 y 简单路径上所有点权改为 z ;
3 x 表示询问 x 的子树中最小权值;
4 x 表示询问 x 的子树中最大权值;
5 x y 表示将 x 的子树中所有点权都增加 y ;
6 x y z 表示将 x 到 y 简单路径上所有点权加上 z ;
7 x y 表示询问 x 到 y 简单路径上的最小权值;
8 x y 表示询问 x 到 y 简单路径上的最大权值;
9 x y 表示把 x 的父亲换为 y ,若 y 在 x 的子树里则忽略此操作;
10 x y 表示询问 x 到 y 简单路径上的点权和;
11 x 表示询问 x 的子树中点权和。
II. 动态仙人掌 IV
题目链接:UOJ106。n 个点的空图,每个点有正点权 w_i ,有 m 次操作,分为六种:
link v u w 在 v,u 间连一条权为 w 的边,连完仍是仙人掌则输出 ok,否则撤销并输出 failed;
cut v u w 删掉 v,u 之间一条权为 w 的边,存在则输出 ok,否则输出 failed;
query1 v u 询问 v\to u 最短路的两个整数 \min,\sigma (点权最小值、点权和),不可达输出 -1 -1,最短路不唯一输出 -2 -2;
query2 v u 以 v 为根,询问 u 的子仙人掌(删掉 v\to u 所有简单路径上的边后 u 所在连通块)的 \min,\sigma ,不连通输出 -1 -1;
add1 v u d 把 v\to u 最短路上每个点的点权加 d ,可达且最短路唯一则输出 ok,否则输出 failed;
add2 v u d 把子仙人掌 u 中每个点的点权加 d ,v,u 连通则输出 ok,否则输出 failed。
2. 基本信息
Self-Adjusting Top Tree,以下简称 SATT,是 2005 年 Tarjan 和 Werneck 在他们的论文 Self-Adjusting Top Trees 中提出的一种基于 Top Tree 理论的维护完全动态森林的数据结构。
SATT 可以实现森林中任一棵树的链修改/查询、子树修改/查询以及非局部搜索等操作,其复杂度由 Splay 操作保证。
根据势能分析可得出其均摊复杂度不超过 \mathcal O(\log n) 。
2006 年,Werneck 在 Design and Analysis of Data Structures for Dynamic Trees 中给出了第一个直接的最坏 \mathcal O(\log n) Top Tree 实现。此前 Alstrup 等人的 Top Tree 已可以建立在 Topology Tree 之上实现最坏 \mathcal O(\log n) ,但那并非独立的 Top Tree 实现。
注意原始 Top Tree/SATT 是基于边簇的,但在竞赛实现中,对于点权树问题,常直接采用“Compress Node 对应原树节点”的点式实现;本文后半部分主要讲这种实现。
3. 静态 Top Tree
考虑线段树如何维护序列的区间操作。\mathcal{O}(\log n) 个由递归分治得到的线段树区间,维护每一个线段树区间的信息,然后用其维护的具有结合率的运算进行合并,得到答案。
将这个思想照搬到树上,可以通过树链剖分将树转化成序列,也可以通过建立 Top Tree 的方法。
I. 簇合并
一个簇(Top Cluster)是一个连通的边集 (即不包含边集所连接的点),并且最多只有两个点有不在簇内的边,即最多只有两个点连向簇外。
我们称这些点为界点 ,两个界点之间的唯一简单路径称为簇路径 。
树根被钦定后,我们便可以称深度较浅的界点为上界点 ,较深的界点为下界点 。若簇中只有一个点连向簇外,则可以任意钦定一个簇内部的一个原树叶子作为下界点。
根据定义,显然有如下性质:
在有根树中,如果点 u 有儿子 v 、边 (u,v) 在某个簇内,且 v 不在该簇的簇路径上,则 v 子树内的所有边均在簇内。
说明这个性质是容易的,Top Tree 中的界点是簇连接外界的“唯一出口”:只要沿着簇内的一条边 (u,v) 走进了一个子树,且该子树里面没有界点,那么这个子树就是一条死路,里面的所有节点都无法通向其他簇,整个子树就必须完全被该簇打包吞并。
一个大簇是由若干个更小的簇合并而来的,由此便可以进行递归分解和合并,递归的终点是仅包含一条边的簇,不妨称这种最小簇为“叶簇 ”。
簇之间的合并有两种方法:
1. Compress
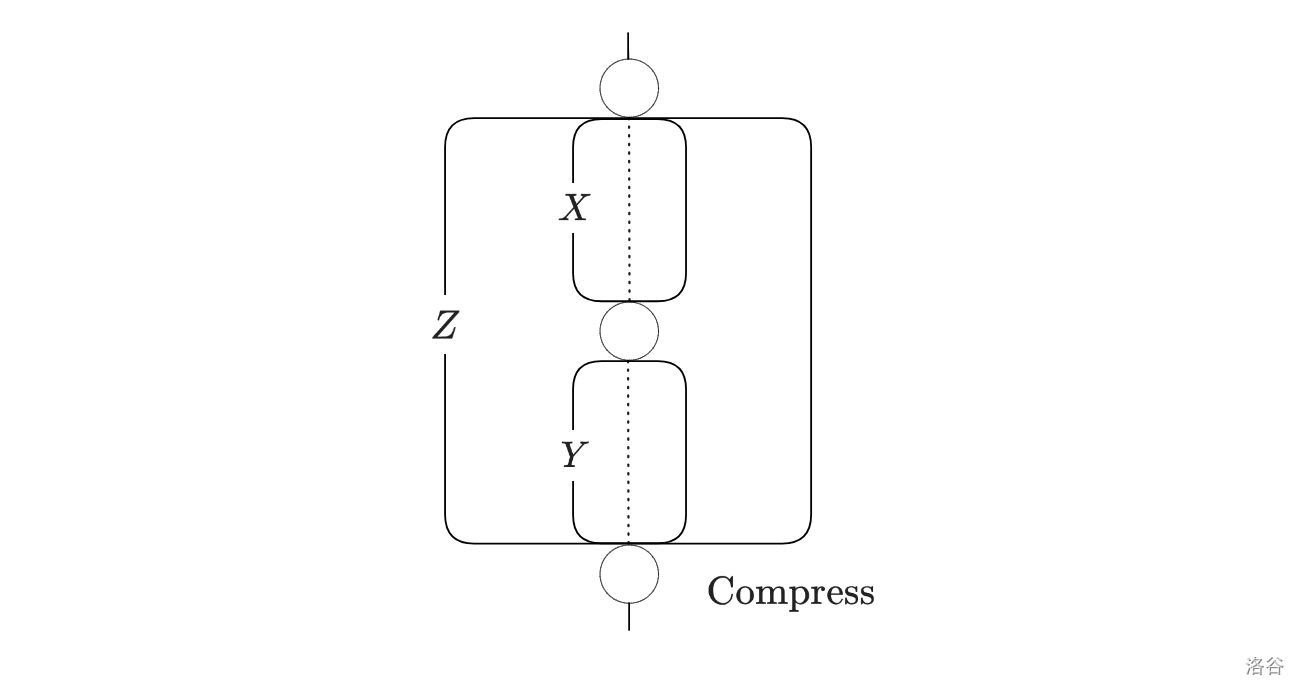
若簇 X 的下界点和簇 Y 的上界点相同,则使得合并后的更大簇 Z 包含 X,Y 中的所有边,其上界点为 X 的上界点,下界点为 Y 的下界点。可以直观的理解为:将两个上下相邻的簇直接通过一个公共界点拼接在一起。
如图所示:
2. Rake
若簇 X,Y 的上界点相同,且 Y 的下界点为叶子(即 Y 中包含了某一个子树内的所有边),则使合并后的更大簇 Z 包含 X,Y 中的所有边,其上下界点与 X 的上下界点完全一致。可以直观的理解为:将 Y 直接“扫”到 X 上。
如图所示。
有了这两种合并,一棵树初始每个边各自成簇,一定存在某种合并方式,将所有簇最终合并成包含所有边的“根簇”。
Compress 和 Rake 合并信息的方式往往是不同的,需要分开实现。
II. 树收缩
这是另一种刻画方式。树收缩 理论来将它收缩为一条边。
1. Compress
Compress 操作指定一个度数为 2 的点 x (这里的度数指当前正在进行收缩的树中的度数,而非原树度数),与点 x 相邻的那两个点记为 y,z ,我们连一条新边 (y,z) ;将点 x 、边 (x,z) 、边 (x,y) 的信息放到 (y,z) 中储存,并删去它们。
如图所示。
2. Rake
Rake 操作指定一个度为 1 的点 x ,而且与点 x 相邻的点 y 的度数需大于 1 ,设点 y 的另一个邻点为 z ,我们将点 x 、边 xy 的信息放入边 yz 中储存,并删去它们。如图所示。
不难发现,这两种刻画其实可以大致看作是互相反过来而已。
III. 建立树结构
建立一棵新的二叉树,将一个簇看作新树上的一个节点,仅包含一条边的簇为新树的叶子,通过 Compress 或 Rake 操作形成的大簇所代表的节点是合并前的两个小簇的父节点。最终形成的这棵树就是原树的 Top Tree 。
左边部分即原树,不带箭头的圆弧指 Compress 操作,带箭头的指 Rake 操作。
我们可以认为原树是一棵无根树,也可以认为 e 是树根,右边部分为原树的 Top Tree,其中形如 xy 的节点指该节点代表的原树中簇的上下界点分别为 x,y ,当然如果认为原树是无根树,则这个“界点”同样具有前后顺序,只不过是人为定的罢了。
方点表示该节点代表的簇是仅有一条边组成,或由两个小簇 Compress 形成的,非叶子方点称为 Compress Node;圆点表示该节点代表的簇是由一个小簇 Rake 到另一个小簇上形成的,称为 Rake Node。
由于一个簇中的两个界点之间存在先后顺序,所以 Top Tree 里的左右儿子顺序是不能调换的,对于 Compress Node,其左儿子为“更靠上”的小簇;对于 Rake Node,其左儿子在原树中的“箭头”指向右儿子。当然这个不涉及什么性质,所以让所有 Rake Node 把左右儿子关系做个对称也没有影响。
注意这仅仅是一个示意图,图中的部分节点只是为了展示每一轮收缩而人为画出的中间状态,并不是 Top Tree 实际需要存储的节点。例如图中的若干 h_i 以及最上方作为 Compress Node 的 g_i 都属于这种“展开后的中间节点”。实际实现只需保留真正参与层次结构的节点即可。
IV. 应用
该以怎样的收缩方法构建这棵 Top Tree?考虑重链剖分,得到这样一个结构。
黑色的代表重链,三角形代表一棵轻子树。
对于递归过程中的每一个子树,采取这样的过程:先把重链剖出来,然后把每个轻子树递归处理,处理完成后,将所有轻子树 Rake 到重链上的相应叶簇上,我们就得到了一个竹节状的结构。
图中每一个回旋镖状物就是一个 Rake 了该条重边的上方点的全部轻子树的簇,对于轻子树递归处理。
得到该结构后,如同线段树一样的进行递归 Compress,结束构建。
Rake 的过程是同样的,即若一个节点有多个轻子树,那么同样采用类似线段树的方法,先两个为一组互相 Rake,得到轻子树数一半的新簇,然后再两两 Rake,这样就算一个节点有 \mathcal O(n) 个轻儿子,也可以保证 Rake Node 构成的部分深度不超过 \mathcal O(\log n) 。
但实际上以上方法的复杂度是双 \log 的,并不优。
由于轻子树不是最大的子树,所以轻子树大小不会超过整棵树大小的一半,所以从根往下走经过的路径最多只能包含 \mathcal O(\log n) 个轻边,就会走到子树大小为 1 的叶子,而这也就意味着,最多只能走 \mathcal{O}(\log n) 条重链。每条重链贡献 \mathcal{O}(\log n) 的 Top Tree 上深度,那么它们在 Top Tree 上拼起来深度就达到了 \mathcal O(\log^2 n) 。
一个显然的 Hack:
令 n=2^k ,那么上图所显示的树的 Top Tree 单单 Compress Node 的深度贡献就达到了 \sum_{i=1}^{\log n}(\log n-i)=\frac{\log^2n-\log n}{2}=\mathcal{O}(\log^2 n) 。
因此,考虑全局平衡二叉树的思想。在 Compress 重链和 Rake 轻子树的时候做带权二分,而非严格二分,权值即为轻子树的大小。
此处仅仅举例 Rake 时的带权二分,Compress 时的带权二分是完全同理的,注意二者的带权二分缺一不可,如果其中任意一个使用普通二分,就可能导致复杂度退化。
考虑一个具有 x 个轻儿子的原树节点 u ,这些轻子树的 Top Tree 均已被建出,这 x 棵 Top Tree 的根编号(注意是 Top Tree 中的编号而非原树中的)分别为 t_1,t_2,\cdots,t_{x-1},t_x 。在前面的错误做法中,我们的二分方法是,对于一个在 Top Tree 上涵盖了 t_{[l,r]} 作为后代的 Rake Node \alpha ,其左儿子和右儿子分别涵盖 t_{[l,\lfloor\frac{l+r}{2}\rfloor]},t_{(\lfloor\frac{l+r}{2}\rfloor,r]} 。
而“带权二分”的方法是,不按点的数量折半,而是寻找一个 \xi\in[l,r] ,使得它是第一个使前缀和达到总权值一半的位置。实际上写法是简单的,一边加轻儿子一边更新前缀和,直到这个前缀和刚刚大于 u 全体轻子树和的一半,停止循环,并将已计算的前缀递归进左儿子,剩余部分递归进右儿子。
然后使 t_{[l,\xi]} 作为 \alpha 左儿子的后代,使 t_{(\xi,r]} 作为 \alpha 右儿子的后代,并以此递归分治下去即可。
对于 Compress 时,我们定义一个重链上的点的权值是其轻子树大小之和 +1 (此为它本身),以同样的方法构建每一个 Compress Node。
先感性理解,这个二分方法虽然在局部贡献的深度就会变大,但是这却造成了全局的平衡性。我们发现,以这种带权二分的方法,节点的深度会基本呈现出“权值越大的节点深度越小”的性质,于是可以认为,对于权值比较大的点,那么它的目前所在簇的 Top Tree 高度也会大一些,但是由于前面的性质,这棵较深的“子 Top Tree”会在带权二分的过程中“较浅”的接入局部,所以它更高的高度就在全局角度被“弥补”了。
然而注意这种方法大概率不会找到真正最优的划分,我们并没有重排轻子树顺序。例如对于 [1,2,3,4] ,以这种方法划分的结果是 [1,2\ |\ 3,4] ,然而实际上最优的划分是 [1,4\ |\ 2,3] 。显然如果想要得到最优的划分,需要做一个背包,但是这个时间复杂度无法接受。事实上,我们可以证明这种不严格的划分不会导致整棵 Top Tree 深度的退化。
严格证明并不困难。
首先我们需要证明:对于局部的 Rake 树,从任何一个轻叶子(即某个原树节点轻子树的 Top Tree 的根)向上走到局部 Rake 树根的深度受到其权重比例的严格控制。
:::info[引理]
设当前待合并的序列总权重为 W=\sum_{i=l}^r w_i 。按前缀和寻找第一个满足 \sum_{i=l}^{\xi}w_i\ge\frac{W}{2} 的带权中点 \xi 进行二分分治。那么对于其中任意一个权重为 w_i 的点,其在生成的这棵局部树中的深度 d_i 满足 d_i\le2\log\left(\dfrac{W}{w_i}\right)+\mathcal O(1) 。
:::
证明考虑,每次二分将区间划分为 [l, \xi] 与 (\xi,r] ,两部分的权重分别为 W_L 与 W_R 。由“带权中点”定义,右半部分显然满足 W_R\le\frac{W}{2} 。
对于左半部分:
若 i \neq \xi ,因为 \xi 是第一个使前缀和 \ge\frac{W}{2} 的位置,所以 i 所在的区间 [l, \xi - 1] 的总权重严格 <\frac{W}{2} ;
若 i = \xi ,在下一次分治中 \xi 就会作为单点直接成为叶子(不再继续细分)。
因此,在局部树中每向下走至多 2 步,包含节点 i 的子区间总权重至少减半(\le \frac{W}{2} ),或者节点 i 已经被分离为叶子。
引理得证,初始权重为 W ,当区间权重缩减到 w_i 时必然成为单点叶子,因此向下走的步数至多为 2\log(W)-2\log(w_i)+\mathcal O(1)=2\log\left(\frac{W}{w_i}\right)+\mathcal O(1) 。
然后考虑全局树高的证明。
考虑原树中任意一个叶子节点 u (初始大小 w=1 ),它在 Top Tree 中一路向上跳到全局根(总大小 W=n ):
路径上会依次经过多棵局部二叉树(可能是轻儿子合并的 Rake 树,也可能是重链压缩的 Compress 树)。
以下所说的节点均指 Top Tree 中的节点。
设刚开始跳到路径上第 j 棵局部树的“叶子”,即“入口”上时,目前跳到的节点的子树所代表的原树中簇大小为 S_j^{\text{in}} ,跳到这棵局部树的“出口”时目前点的子树在原树上的对应簇大小为 S_j^{\text{out}} 。由引理可知:在第 j 棵局部树内的深度 \le2\log\left(\frac{S_j^{\text{out}}}{S_j^{\text{in}}}\right)+\mathcal O(1) ,当从第 j 棵树跳到上一级第 j+1 棵树时,上一级的“入口”簇必然包含了当前簇,即 S_{j+1}^{\text{in}} \ge S_j^{\text{out}} 。
根据重链剖分性质,从叶到根最多跨越 \mathcal O(\log n) 条重链(即只有 \mathcal O(\log n) 棵局部树,常数项总和为 \mathcal O(\log n) )。
将沿途所有局部树内的深度累加:
\begin{aligned}
\text{Ans}&=\sum_{j}\left(2\log\left(\frac{S_j^{\text{out}}}{S_j^{\text{in}}}\right)+\mathcal O(1)\right)\\
&\le2\sum_{j}\left(\log S_j^{\text{out}}-\log S_j^{\text{in}}\right)+\mathcal O(\log n)\\
&\le2\left(\log S_{\text{root}}-\log S_{\text{leaf}}\right)+\mathcal O(\log n) \\
&=2\log\left(\frac{n}{1}\right)+\mathcal O(\log n)\\
&=\mathcal{O}(\log n)
\end{aligned}
从第二步到第三步的裂项相消是关键。
得证。
根据这个建树方法,就可以像线段树一样,极其方便地解决很多树上问题。
下面举一些经典应用,具体细节这里不做赘述,以下各题题解区均存在 Top Tree 做法及其代码实现:
1. 维护最大独立集
例题为【模板】动态 DP。
对于每个簇,分别维护簇内独立集不包含两个界点、只包含上界点、只包含下界点、两个节点均包含的最大权值。
合并是一个类似 DP 转移的过程,推导是容易的。
2. 维护直径
例题为 CEOI2019 Dynamic Diameter。
合并的推导也是容易的。
3. 维护邻域
例题为 【模板】点分树 | 震波
分别维护簇内到两个界点距离最远的点到该界点的距离 p,q ,同时维护距离上界点不超过 1,2,3,\cdots,p-1 及距离下界点不超过 1,2,3,\cdots,q-1 的所有点的信息和。这样合并两个簇的复杂度为 \mathcal O(\mathrm{size}) ,其中 \mathrm{size} 为簇的大小。
单点修改,此时就不要考虑正常的靠合并更新信息的方法,而是把包含该点的 \mathcal{O}(\log n) 个簇直接全部拎出来。此时发现如果暴力修改的话,由于簇内维护的是前缀和状物,所以每个簇内修改最高达到了 \mathcal{O}(\mathrm{size}) ,所以我们每一个簇内用一个树状数组来维护,簇内信息的修改就变成了 \mathcal{O}(\log\mathrm{size}) ,查询也是从叶子往上跳,每次跳的时候再算上兄弟节点的贡献,过程中访问的点只有一条毛毛虫结构,复杂度与查询一致。
故总复杂度 \mathcal{O}(n\log n+q\log^2n) 。
4. Self-Adjusting Top Tree
步入正题。
I. 树结构
我们任意假定一种树链剖分方法,并认为一个点有零或一 个重儿子,即不要求分解为极长路径。(注意此处“重儿子”是人为钦定的,与子树大小或高度无关,你也可以把它称作“实儿子”之类,后文中若无特殊说明,“重儿子”“重链”等称谓均为人为钦定)
得到树链剖分后,再以先前的方法在重链上 Compress,在轻子树 Rake,合并方法任意,不需要带权二分。
1. Compress Tree
与先前不同的是,现在 Compress Node 与 Rake Node 的含义有些许变化,且叶子簇需要单拎出来作为第三种节点。
在原先的二叉静态 Top Tree 中,我们给每个 Compress Node 的命名方法是用其上下节点来表示,而现在,我们需要用簇中的一个“合并点”来代指一个簇,即:两个小簇在 Compress 成一个大簇时,以两个小簇之间交叠的那个公共点作为大簇的“代表”。
我们拿一条已经把所有轻儿子都 Rake 过了的重链 \text{a-b-c-d-e} 来举例:
其中形如 \text{Nx} 的点即为原树节点 x 在 Top Tree 上的对应点,而下方的以矩形表示的叶子簇记录每一条单边。
这个仅由 Compress Node 和叶子簇节点构成的二叉树称为 Compress Tree 。
Compress Tree 依然需要满足“其中序遍历符合原树中的深度顺序”这一性质,因此左右儿子是不对称的。
2. Rake Tree
首先我们重新定义 Rake Node 的逻辑。
之前我们对 Rake Node 的定义是一个“中间量”,代表若干个轻子树合并后的结果;而现在,我们依然认为一个 Rake Node 是若干个轻子树的集合,但是与原先不同的是,它还存储着这个集合中的某一个特定轻子树的信息,不妨称这个特定的轻子树为该集合的“代表元”。
这就意味着现在每一个 Rake Node 都有一个轻子树与之对应,所以 Rake k 个轻子树原先需要 (2k-1) 个节点,现在只需要 k 个,这 k 个节点以任意方法拼成一棵二叉树(当然如果原树的不同儿子之间有顺序限制,你就不能这样,此时你可能甚至不能让 Compress Node 有中儿子,需要换写法),左右儿子不区分,每一个节点所代表的轻子树的集合即为其左右儿子代表的集合以及它自己的并,这个集合的代表元即为它自己。
原树中轻儿子编号 \text{a,b,c,d,e} 分别对应 Rake Tree 上的 \alpha,\beta,\chi,\delta,\varepsilon 。
例如,\delta 代表的就是 \text{a,b,c,d,e} 的子树构成的集合,而这个集合的“代表元”就是 \text d 的子树;\chi 代表的就是 \text{a,b,c} 的子树构成的集合,而这个集合的“代表元”就是 \text c 的子树。
这个二叉结构被称作 Rake Tree 。
3. 三度化
注意这是对 Top Tree 进行三度化 而非对于原树。
有趣的是,对原树三度化的方法,是 Frederickson 在 1985 年及后续论文中提出的原始 Topology Tree。但是其实现非常复杂且效率低下。Alstrup 等人在 1997 年提出的 Top Tree,其设计目标就是提供更简单、更容易处理信息的接口,但是这个方法也并不简洁,所以后面 SATT 才应运而生。
需明确的一点。原始 SATT 为了支持有序邻接表,在概念表示上允许 Compress Node 存在两个 foster child,因此一个节点最多可以有四个孩子。本文只处理普通的无序树(指儿子之间无序),两个方向的轻子树没有顺序要求,因此可以采用单中儿子的三度化表示。这正是后文所使用的结构。
何为三度化?前文所述的静态 Top Tree 是一棵二叉树,现在我们要将其改为三叉树。
每个节点除了有左右儿子之外,再引入中儿子 ,而 Compress Node 和 Rake Node 的中儿子意义不同:
Compress Node 的中儿子若存在,一定是一个 Rake Node,Rake Node 的中儿子若存在,一定是 Compress Node。
一个节点的左右儿子的类型跟它本身类型相同。
Compress Node x 的中儿子 \mu 维护原树中节点 x 的全部轻子树构成的集合。
Rake Node \alpha 的中儿子 m 维护 \alpha 所维护的集合的代表元的重链。
以上图例中,你会发现,在合并的最后(\text{cd,Nj} Compress 到 \text{Nc} ),\text{Nc} 已经是一个包含所有边的根簇,但是在其上又补充了一个 \text{Nk} ,还是一个根簇,看起来有些无用,但实际上这样做的原因其实是为了标定原树的根,否则我们将无法处理有根树的树根信息。
最终我们容易发现,SATT 就是若干棵 Compress Tree 和 Rake Tree 通过中儿子边连接起来的结果。
4. 维护点的 SATT
在代码中,我们也会根据题目的需要去选择 SATT 维护边还是点,例如文章开头给出的例题 Sone1 中我们就使用维护点的 SATT,其实这和刚才所说的维护边的 SATT 并无本质不同,只是此时我们就不再区分叶子簇与 Compress 节点,它们都可以用“\text{Nx} ”来表示。
此时的 Compress 的过程也略有分别,维护边的 SATT 中 Compress 是一个二元操作,且两簇之间有公共点;而维护点的 SATT 中 Compress 是一个三元操作 :一个 Compress Node x 的左右儿子所维护的簇并无交集,甚至不相邻,而这处于两个簇中间、将它们分离开的节点,正是原树上的 x 。
所以在向上合并信息的时候,我们需要合并三个信息,左儿子,右儿子,以及 x 本身(可以认为此处的“x 本身”其实包括 x 的轻儿子,毕竟所有轻儿子已经在先前被 Rake 了)。
至于两个单点之间的合并,就认为左右儿子中有一个是空即可。
把上一节的图例改成维护点的 SATT,毫无疑问这样的实现是更加简洁清晰的,我们甚至不需要将 SATT 的根节点单独置顶以对应原树根 ,原树根就是顶端 Compress Tree 的最左节点。
其实看到这个结构你可以发现,这几乎就是把 LCT 并列的虚边改成二叉的 Rake Node 来维护轻子树而已,然而就是这一个简单的操作,使得 SATT 做到了子树修改,因为这个改动使得下传标记能做到 \mathcal{O}(1) ,树高的复杂度还没有本质改变,SATT 的高明与强大之处正在于此。
不仅如此,它的思想的可扩展性,也让它能处理相当多 LCT 能力范围之外的问题。
II. 维护信息
1. 节点信息
以最开始的例题 Sone1 为例,我们需要维护子树信息和路径信息。
struct node {
    int son[3], fa, val;
    dat pth, str;
    tag tpth, tstr;
    int rev;
    node() {
        son[0] = son[1] = son[2] = fa = val = 0;
        pth = str = dat();
    }
};
注意在节点结构体内部一般不需要规定节点的类型,因为在操作节点时,我们通过给每个函数传参的方法可以得知要操作的节点类型。并且,为了方便,在实践中我们通常给 Compress Node 在 SATT 上编号为 $1\sim n$,恰好对应原树上的 $n$ 个点,这样编号 $>n$ 的节点就一定是 Rake Node。
$\text{dat,tag}$ 类型分别代表要维护的信息以及修改时作为懒标记的信息,$\text{rev}$ 是左右翻转懒标记,但是不被放在 $\text{tag}$ 类型里,因为它的功能不是维护真正的修改操作,而是换根中的翻转路径方向,和 LCT 的这一部分是一样的,这点我们会在后文提到。
$\text{pth,str}$ 分别存储的是重链信息和轻子树信息:
+ 对于 Compress Node $x$,其 $\text{pth}$ 存储的是**以 $x$ 为根的 Compress Tree** 的信息总和,由于仅仅包含 Compress Node 的总和信息,所以在原树上的表现就是维护了某条重链中的一段的信息总和,例如对于上一节的示意图,$Nc$ 的 $\text{pth}$ 维护的就是 $cd,Nc,ch,Nh,jh,Nj,jk$ 的信息总和。
+ 对于 Compress Node $x$,其 $\text{str}$ 存储的是 Top Tree 上 $x$ 的 Compress Tree 子树中的所有节点的中子树的信息总和。在原树上的表现是,$x$ 的 $\text{pth}$ **所维护的重链段上全部节点的全部轻子树中所有节点**的信息总和,例如对于上一节的示意图,$Nc$ 的 $\text{str}$ 维护的就是 $\alpha,\delta,\varepsilon$ 的子树中所有节点的信息总和。
+ 对于 Rake Node $\alpha$,其 $\text{pth}$ 没有意义。
+ 对于 Rake Node $\alpha$,其 $\text{str}$ 是 $\alpha$ 在 Top Tree 上的**整棵子树的信息总和**(包括中儿子),在原树上的表现为某一个点的某几棵轻子树(可能是所有,也可能是一个)的信息总和,例如对于上一节的示意图,$\alpha$ 的 $\text{str}$ 维护的就是 $\alpha,bc,Nb,ab,\beta,ce$ 的信息总和。
对于 $\text{tag}$ 来说,就是把修改标记打在这些位置上。
#### 2. 合并信息
即 `pushup()` 的实现。
```cpp
void pushup(int &x, int typ) {
if (typ)
str(x) = str(son(x, 0)) * str(son(x, 1)) * str(son(x, 2)) *
pth(son(x, 2));
else {
str(x) = str(son(x, 0)) * str(son(x, 1)) * str(son(x, 2));
pth(x) = pth(son(x, 0)) * pth(son(x, 1)) *
dat(1, val(x), val(x), val(x));
}
}
```
$\text{typ}$ 为 $x$ 的类型,值为 $0$ 表示 $x$ 是 Compress Node,为 $1$ 表示 $x$ 是 Rake Node。
乘号是重载运算符,用来表示两个 $\text{dat}$ 之间的运算。
对于 Rake Node,只有其子树信息需要维护,根据定义,它的整棵子树都需要被包括在内,所以需要左中右儿子的信息都需要合并。由于 Rake Node 的中儿子只能是 Compress Node,又 Compress Node 的 $\text{str}$ 是仅包括其 Compress Tree 子树中所有点中儿子,所以还需要加上 $x$ 中儿子的 $\text{pth}$ 以补上这个中儿子的 Compress Tree 子树中节点的信息。
对于 Compress Node $x$,$\text{str}$ 直接合并左中右儿子即可,左右儿子相当于“递归处理”,中儿子是 Rake Node,所以这个中儿子的 $\text{str}$ 即为 $x$ 的整棵中子树,符合定义。
而 Compress Node 对于 $\text{pth}$ 的维护恰好体现了维护点的 SATT 的 Compress 是三元合并的特点,除了要合并左右儿子的信息,还需要合并自己这个单点的信息,这样才能把左右儿子完全接上。
#### 3. 下传标记
先考虑,一个点被打上了一个 $\text{tpth}$ 或 $\text{tstr}$ 的标记 (Tag of PaTH, Tag of SubTRee) 之后,单单这个点本身(不考虑儿子)的各项值的变化。注意此处 $\text{tpth}$ 和 $\text{tstr}$ 的标记不等价于原问题中的路径修改和子树修改,只有后文我们讲到将树旋转以及重划轻重边之后,路径修改和子树修改才能归约到 $\text{tpth}$ 和 $\text{tstr}$ 的标记的改变。而现在,这两个标记所做的事情,就是给这个节点的 $\text{pth}$ 和 $\text{str}$ 所管辖的范围(前文已经讨论过这些范围是什么)中的全部节点打上标记而已。
```cpp
void ptht(int x, tag t) {
val(x) = val(x) * t;
tpth(x) = tpth(x) * t;
pth(x) = pth(x) * t;
}
void strt(int x, tag t) {
tstr(x) = tstr(x) * t;
str(x) = str(x) * t;
}
```
这两个函数即为给 Top Tree 上节点 $x$ 打上标记时他本身的变化,其实理解起来是平凡的,唯一要注意的就是根据 Compress 的三元合并性质,在打上路径标记的时候,其本身的 $\text{val}$ 值也会发生改变。
有了这两个“单点维护”函数后,`pushdown()` 的逻辑其实就是 `pushup()` 反过来。
```cpp
void pushdown(int &x, int typ) {
if (typ) {
if (!tstr(x).empty()) {
strt(son(x, 0), tstr(x));
strt(son(x, 1), tstr(x));
strt(son(x, 2), tstr(x));
ptht(son(x, 2), tstr(x));
tstr(x) = tag();
}
} else {
if (rev(x)) {
trev(son(x, 0));
trev(son(x, 1));
rev(x) = 0;
}
if (!tpth(x).empty()) {
ptht(son(x, 0), tpth(x));
ptht(son(x, 1), tpth(x));
tpth(x) = tag();
}
if (!tstr(x).empty()) {
strt(son(x, 0), tstr(x));
strt(son(x, 1), tstr(x));
strt(son(x, 2), tstr(x));
tstr(x) = tag();
}
}
}
```
中间多了那个对于 $\text{rev}$ 标记的维护,发现它干的事情其实就是翻转左右儿子,那不难想到给整棵 Compress 子树打的 $\text{rev}$ 标记就是翻转子树内每个节点的左右儿子关系,从而使该子树的中序遍历完全翻转。
如果你学过 LCT,你就可以知道这一步其实是为换根做准备,我们后面会提到。
#### 4. 递归下传
由于在我们实现的 SATT 中,Compress Node 和原树节点编号相同,所以每次都可以精准定位一个 Compress Node。然而,如果要从这个 Compress Node 向上跳,而它的祖先的标记还都没下传,这是不对的,因此我们需要一个从根开始精准地在一条根链做下传标记直到某个节点的操作。
实现是极其容易的。
```cpp
void pdrt(int x, int typ) {
if (!isrt(x))
pdrt(fa(x), typ);
pushdown(x, typ);
}
```
### III. Splay 相关操作
Splay 操作是 LCT 保证复杂度以及操作简便性的核心,在 SATT 中也不例外。
这里不过多赘述 Splay 的具体旋转方法,可参考[我的 LCT 笔记相关部分](https://www.luogu.com.cn/article/nmwplwa3)。
#### 1. 单旋
```cpp
bool dir(int x) { return x == son(fa(x), 1); }
void rotate(int x, int typ) {
int f = fa(x), g = fa(f), lr = dir(x), y = son(x, lr ^ 1);
if (g)
son(g, son(g, 2) == f ? 2 : dir(f)) = x;
son(x, lr ^ 1) = f;
son(f, lr) = y;
if (y)
fa(y) = f;
fa(f) = x;
fa(x) = g;
pushup(f, typ);
pushup(x, typ);
}
```
与正常旋转的差异在于对于中儿子的处理,毕竟这里旋转的时候仅仅操作的是 Compress Tree,与中儿子的边是不会有影响的。
#### 2. 双旋
```cpp
bool isrt(int x) { return (x != son(fa(x), 0)) && (x != son(fa(x), 1)); }
void splay(int x, int typ, int goal = 0) {
pdrt(x, typ);
for (int i; i = fa(x), !isrt(x) && i != goal; rotate(x, typ))
if (fa(i) != goal && !isrt(i))
rotate(dir(x) ^ dir(i) ? x : i, typ);
}
```
注意这里对于是否为 Compress Tree 根的判定,一个点如果是其父亲的中儿子,再往上跳相当于走了一条“虚边”,就不属于该 Compress Tree 内了。
Splay 前需要把当前节点所在的局部 Splay 树根到 $x$ 的路径上的标记全部下传。由于跨越中儿子时,父节点上的标记已经在此前下传过程中被转移到对应的中儿子根,因此这里不需要继续递归到整个 Top Tree 根。
为了方便以后的操作,需要设立一个哨兵节点 $\text{goal}$ 以处理有时只需旋转到特定节点的情况。
由于 Splay 操作不改变中序遍历的性质,它不会使得原树的树形产生任何变化。
### IV. Access 相关操作
`access(x)` 将 SATT 上的节点 $x$ 旋转到整个 SATT 的根节点,不改变原树连边结构,只改变原树的轻重边划分方式,使得原树上节点 $x$ 与原树根处于同一重链上。
我们考虑先把 $x$ 到 SATT 根的路径“打通”,使得 $x$ 和 SATT 根处于同一个 Compress Tree 中,然后再执行一次 Splay 把 $x$ 转到根部。
#### 1. Splice
Splay 操作只能在同一棵 Compress Tree 内实现,所以 Splice 的作用就是,将两个靠 Rake Tree 接在一起的 Compress Tree 打通。
打通后产生的新的 Compress Tree 显然不一定会包含原先两棵 Compress Tree 的全部节点,不过这没有影响,我们仅仅关心那个要旋转的点 $x$ 是否被新的 Compress Tree 囊括进去。
例如,如果我们想要打通 Rake Node $\alpha$ 所在 Rake Tree 下方的 Compress Tree 和上方的 Compress Tree:
1. 先将 $\alpha$ Splay 到其所在 Rake Tree 的根,此时 $\alpha$ 的父亲 $f$ 一定是一个 Compress Node,中儿子为 $\alpha$。
2. 将 $f$ Splay 到其所在 Compress Tree 的根。
3. 这一步是核心:
+ 如果 $f$ 有右儿子,那就让 $f$ 的右儿子跟 $\alpha$ 中儿子互换,这样 $\alpha$ 下面的这棵 Compress Tree 就被调到上面去了。
+ 如果 $f$ 没有右儿子,那直接把 $\alpha$ 的中儿子接到 $f$ 的右儿子处即可。然而此时 $\alpha$ 没有中儿子了,那这个 Rake Node 就没什么本质作用了,可以把它删掉,具体怎么删掉一个 Rake Node 需要 Delete 操作,下一节将会进行说明。
对于第 3 步,第一种情况其实就是更改原树上节点 $f$ 的重儿子,第二种情况其实就是原树上 $f$ 根本没有重儿子,于是直接设置一个重儿子。
```cpp
void splice(int x) {
splay(x, 1);
int g = fa(x);
splay(g, 0);
pushdown(x, 1);
if (son(g, 1)) {
swap(fa(son(x, 2)), fa(son(g, 1)));
swap(son(x, 2), son(g, 1));
} else {
setf(son(x, 2), fa(x), 1);
del(x);
}
pushup(x, 1);
pushup(g, 0);
}
```
其实 1、2 两步叫作 Local Splay,第 3 步才是真正的 Splice 操作,但是方便起见都算作一起了。
#### 2. Delete
删除的逻辑很简单:如果 $\alpha$ 有左子树,那就在其所在 Rake Tree 上找到它左子树的最右节点,也就是 $\alpha$ 的前驱,然后将该前驱 $\beta$ Splay 到 $\alpha$ 的左儿子位置,此时 $\beta$ 没有右儿子,那就直接把 $\alpha$ 的右子树接到 $\beta$ 右儿子处,这样 $\alpha$ 就没有右子树了,我们直接删掉这个节点,然后让 $\beta$ 向 $f$ 连边,顶替它的位置即可。如果 $\alpha$ 没有左子树,那更简单了,直接删掉 $\alpha$,用它的右儿子接替它的位置即可。
```cpp
void setf(int x, int f, int typ) {
if (x) fa(x) = f;
son(f, typ) = x;
}
void del(int x) {
if (son(x, 0)) {
int ls = son(x, 0);
pushdown(ls, 1);
while (son(ls, 1)) {
ls = son(ls, 1);
pushdown(ls, 1);
}
splay(ls, 1, x);
setf(son(x, 1), ls, 1);
setf(ls, fa(x), 2);
pushup(ls, 1);
pushup(fa(x), 0);
} else
setf(son(x, 1), fa(x), 2);
clear(x);
}
```
#### 3. Access
我们希望 $x$ 在 Access 完成后无重儿子,即**为重链底部节点**。而 $x$ 在最后又是 SATT 的根,因此它显然最终没有右儿子(注意前面我们说过用 SATT 维护树时原树上任一个点都可以没有重儿子,因此重链底部节点不一定是叶子)。
先将 $x$ Splay 到局部 Compress Tree 的根,然后看它有没有右儿子,如果没有,那这就是预期效果,如果有,我们应当直接把其右儿子断掉,并在 $x$ 正下方(也就是其中儿子所在的)的 Rake Tree 中新建立一个 Rake Node 来拼接它与它被断掉的右儿子。
右儿子断开之后,考虑 $x$ 的父亲,由于 $x$ 已是其 Compress Tree 的根,故 $x$ 的父亲 $\alpha$ 必定是一个 Rake Node,所以可以对 $\alpha$ 进行一次 Splice 操作。
此时 $x$ 所在的 Compress Tree 就跟 $\alpha$ 上面的那个 Compress Tree 打通了。由于 Splice 中有一个 `splay(g, 0)` 的操作,所以此时打通之后,$x$ 现在的父亲,即 $g$,就是目前 Compress Tree 的根。于是当前处理的位置往上跳到 $g$,让 $g$ 的父亲再 Splice,再向上跳,以此类推,直到完全打通到根节点。
注意,这个循环过程中,一直都是 Rake Node 在执行 Splice,且向上跳的是“当前处理的指针”,真正要操作的 $x$ 还在最底下没有动,所以我们要执行一次 Global Splay,由于此时 $x$ 已经和 SATT 的根在同一 Compress Tree 内,所以 Splay 会使得其直接转到根。
由于 $x$ 的右子树已被切断,且每次 Splice 的时候,下面那棵 Compress Tree 都是往上面 Compress Node 的右儿子处接的,所以打通之后 $x$ 就自然是整个 Compress Tree 中最右的一个,即原树中那条“根重链”最底端的节点。
```cpp
void access(int x) {
splay(x, 0);
int y = x;
if (son(x, 1)) {
int nd = newnode();
setf(son(x, 2), nd, 0);
setf(son(x, 1), nd, 2);
son(x, 1) = 0;
setf(nd, x, 2);
pushup(nd, 1);
pushup(x, 0);
}
while (fa(x)) {
splice(fa(x));
x = fa(x);
pushup(x, 0);
}
splay(y, 0);
}
```
我们其实也可以不在最后才进行 Global Splay,而是每次 Splice 之后就将 $x$ 向上 Splay 一下,这样循环结束后 $x$ 自然直接成为根。
在实践中这种方法常数更小,甚至比最终 Global Splay 的方法总时长快了近 $400\mathrm{ms}$,但是由于前面的方法在复杂度的严格证明上更加简洁,所以原论文中使用的是前面的做法。
```cpp
void access(int x) { // 优化版
splay(x, 0);
int y = x;
if (son(x, 1)) {
int nd = newnode();
setf(son(x, 2), nd, 0);
setf(son(x, 1), nd, 2);
son(x, 1) = 0;
setf(nd, x, 2);
pushup(nd, 1);
pushup(x, 0);
}
while (fa(x)) {
splice(fa(x));
// x = fa(x);
splay(x, 0); // +++
pushup(x, 0);
}
// splay(y, 0);
}
```
实际代码中只有三行的变化。
### V. 更改原树结构
#### 1. 换根
将原树看成一个有向树(内向外向随意)后,容易观察出将 $x$ 换为根的本质其实就是把从 $x$ 到旧根的路径上的所有边反向。
又由于 Compress Tree 的中序遍历反映了重链的深度顺序,所以将某个 Compress Tree 中所有点的左右儿子调换,其中序遍历就会完全翻转,从而这条重链的深度顺序完全翻转。
因此,先将 $x$ 执行一次 Access,此时 $x$ 所在的 Compress Tree 恰好就完全代表了 $x$ 到现在的根的路径。将这棵 Compress Tree 中所有点的左右儿子调换,就将 $x$ 到根的这条链的深度顺序完全翻转,从而 $x$ 就变成了原树的根。
整棵子树翻转左右儿子的操作,就交给前面所说的 $\text{rev}$ 标记来实现。
Makeroot 的代码极其好写。
```cpp
void trev(int x) {
swap(son(x, 0), son(x, 1));
rev(x) ^= 1;
}
void makeroot(int x) {
access(x);
trev(x);
}
```
#### 2. Expose
Expose 操作的目的更加简单,`expose(x,y)` 将 $x$ 到 $y$ 的路径单独剖成一棵 Compress Tree,即一条重链,不要求 $x,y$ 具有祖先与后代的关系。
这个操作其实就是为了辅助链上操作,它将链操作转化成了一棵 Compress Tree 的整体操作,实现也很简单,先换根为 $x$,再对 $y$ 执行 Access 即可。
理解和实现都是平凡的。
```cpp
void expose(int x, int y) {
makeroot(x);
access(y);
}
```
注意由于链操作不改变原树结构,所以 Expose 并修改/查询信息后,应当将根换回来。
#### 3. Link/Cut
Link 操作连接两个不连通的点,新增一条边;Cut 操作删除一条边。注意单纯的 Link/Cut 操作是针对**无根树**的。
对于 Link 操作,我们先对 $x$ 执行 Access,使得 $x$ 在 SATT 上没有右儿子。然后将 $y$ 换为其所在树根,直接在 SATT 上将 $y$ 接到 $x$ 右儿子处即可。
```cpp
void link(int x, int y) {
access(x);
makeroot(y);
setf(y, x, 1);
pushup(x, 0);
}
```
对于 Cut 操作,先 Expose 这两个点形成一棵仅有两点的 Compress Tree,然后在 SATT 上断开唯一一条边即可。
```cpp
void cut(int x, int y) {
expose(x, y);
clear(son(x, 1));
fa(x) = son(y, 0) = 0;
pushup(y, 0);
}
```
但是由于题目维护的是有根树,所以在题目中 Link 操作为把 $x$ 的父亲换为 $y$ 的操作,从而我们需要先得知 $x$ 的原树父亲是谁。
Access 了 $x$ 之后,其在原树上的父亲就是其所在 Compress Tree 的前驱的对应节点。
```cpp
int cutfa(int x) {
access(x);
int y = son(x, 0);
while (son(y, 1))
pushdown(y, 0), y = son(y, 1);
son(x, 0) = fa(son(x, 0)) = 0;
pushup(x, 0);
return y;
}
```
该函数同时实现了切断原树中 $x$ 与其父亲的关系和返回其父亲编号。
对于更改父亲操作,也就极其容易了。
```cpp
int findrt(int x) {
access(x);
while (son(x, 0)) {
pushdown(x, 0);
x = son(x, 0);
}
splay(x, 0);
return x;
}
void changefa(int x, int y) {
if (x == y || x == rt)
return;
int z = cutfa(x);
if (findrt(x) == findrt(y))
link(x, z);
else
link(x, y);
makeroot(rt);
}
```
注意上面的 Findrt 操作,其实就是找到 $x$ 所在原树的根,用来辅助判断两点是否连通,`cutfa(x)` 后,$x$ 与原树剩余部分暂时分成两个连通块。若 $y$ 位于原来 $x$ 的子树中,那么 $y$ 会与 $x$ 处于同一个连通块;此时不能直接 `link(x,y)`,否则会成环,因此必须恢复原边 `(x,z)`。反之 $y$ 位于 $x$ 的子树之外,则直接把 $x$ 连接到 $y$ 即可。
Findrt 实现逻辑就是 Access 后找到顶端 Compress Tree 的最左节点。
### VI. 查询与修改
其实有了前面的大量铺垫,这一块是呼之欲出的。
#### 1. 路径操作
Expose 之后为该路径对应的 Compress Tree 根打上路径标记或返回它的路径信息即可。
```cpp
dat qpth(int x, int y) {
expose(x, y);
dat ans = pth(y);
makeroot(rt);
return ans;
}
void upth(int x, int y, tag t) {
expose(x, y);
ptht(y, t);
makeroot(rt);
}
```
#### 2. 子树操作
将 $x$ Access 之后,其只有轻子树,故其子树信息即为其在 SATT 上中子树以及它自己的信息总和,这样就完全涵盖了以 $x$ 为根的整棵子树。
```cpp
dat qstr(int x) {
access(x);
dat ans = str(son(x, 2)) * dat(1, val(x), val(x), val(x));
makeroot(rt);
return ans;
}
void ustr(int x, tag t) {
access(x);
strt(son(x, 2), t);
val(x) = val(x) * t;
pushup(x, 0);
makeroot(rt);
}
```
### VII. 完整代码
在[云剪贴板](https://www.luogu.com.cn/paste/pg8oru9s)中查看。
## 5. 仙人掌
### I. 静态仙人掌
后文中“仙人掌”均指边仙人掌,即每条边至多属于一个简单环的无向连通图。每个连通块都是仙人掌且没有自环的无向图称为沙漠或荒漠。
#### 1. Twist
直接把 Compress 和 Rake 搬到仙人掌上,环会被缩成两点之间的一条重边。Compress 和 Rake 都拼不出这种形状,于是引入第三种收缩 Twist。Twist 把两条端点相同的路径并成一条,重边就是它最直接的样子。
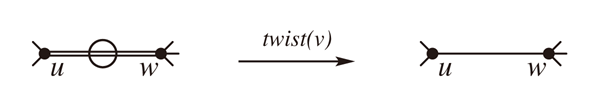
#### 2. 环的收缩
有了 Twist,静态仙人掌的收缩就和树一样了。环的两个界点把环分成两条路径,各自 Compress 成簇,界点相同,再用一次 Twist 并成环簇。带环的路径于是又变回一条普通路径,可以继续参与 Compress 和 Rake。
顺序上有一个约束。Twist 只有两个儿子,两条路径必须干净。环上的点若还挂着环外的子树,这些子树要在 Twist 之前 Rake 到环上,否则 Twist 没有位置放。这和 Compress 前要先把轻子树 Rake 掉是一个道理。
#### 3. 静态仙人掌簇的信息
最短路查询只需要簇的两个界点 $u,v$、最短路的长度 $d$ 和簇内点的聚合量。三种合并分别处理 $d$。Compress 把两段首尾相接的路径拼起来,$d\gets d_a+d_b$。Rake 不改变簇路径,$d$ 不变,只把旁支的聚合量并进来。Twist 在两条路径里取短的一条,$d\gets\min(d_a,d_b)$,两条等长时记下最短路不唯一。
这个标记要一路传到根簇。查询时根簇若带着它,说明 $u,v$ 之间的最短路不唯一。动态版本的 $\mathrm{flag}$ 沿用这个标记。
### II. 动态仙人掌
#### 1. 结点结构
##### 1.1 从树到仙人掌
SATT 维护的是树。树上的路径唯一,Compress 时不必选择方向。仙人掌的一个环上有两条路径连接同一对点,路径查询必须二选一。把每个环缩成一个点,仙人掌就缩成一棵树,也就是块割点树。一条简单路径在块割点树上走,每经过一个环就在环的两条路径里选一条。除了这一层选择,其余部分与树一样。
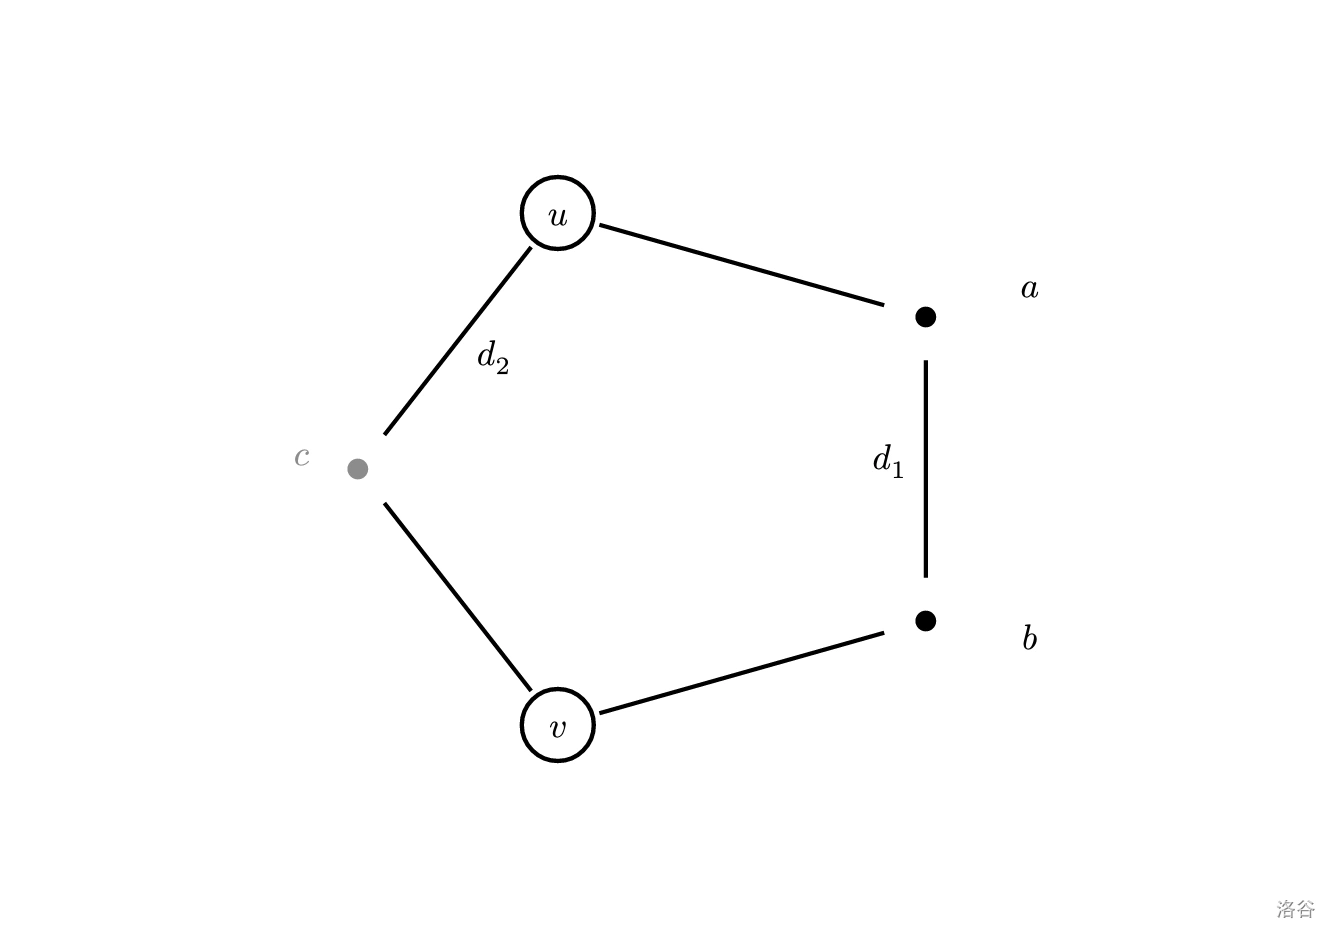
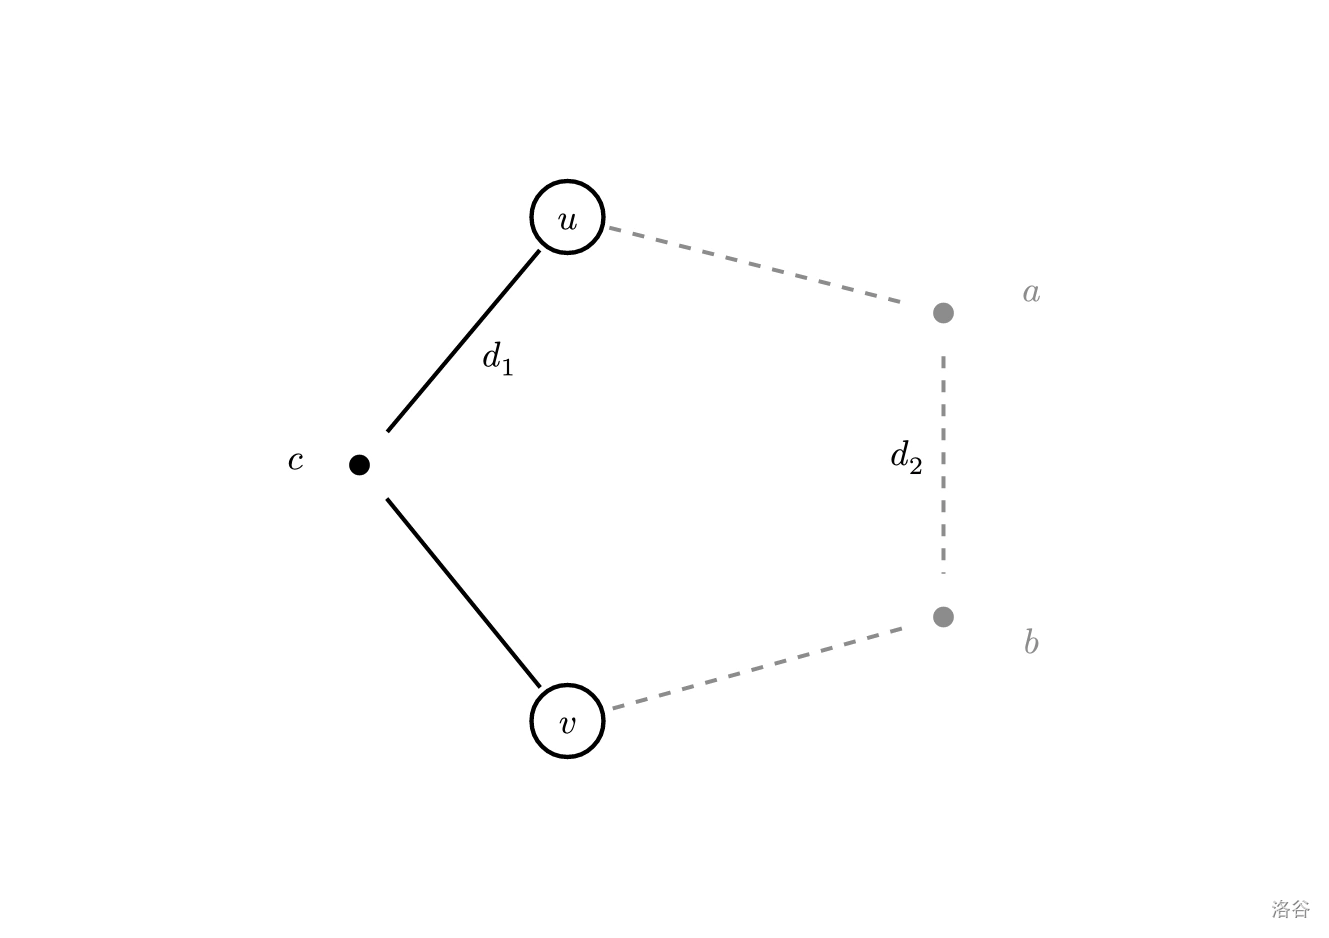
设环的两个界点为 $u,v$,它们把环分成两条边不相交的路径,长度分别为 $d_1,d_2$。较短的一条是 $u\to v$ 的最短路,$d_1=d_2$ 时最短路不唯一。
Twist 在前面已经定义过,它把两条端点相同的路径并成一条。两条路径各自 Compress 成一棵簇,界点都是 $u,v$,再 Twist 成一个环簇。环簇在主链上相当于一条长度为 $\min(d_1,d_2)$ 的边,可以继续参与 Compress 和 Rake。
以下图为例,环的两个界点 $u,v$ 把环分成 $u-a-b-v$ 与 $u-c-v$ 两条路径。
再用一个 Twist 结点把它们并成环簇。
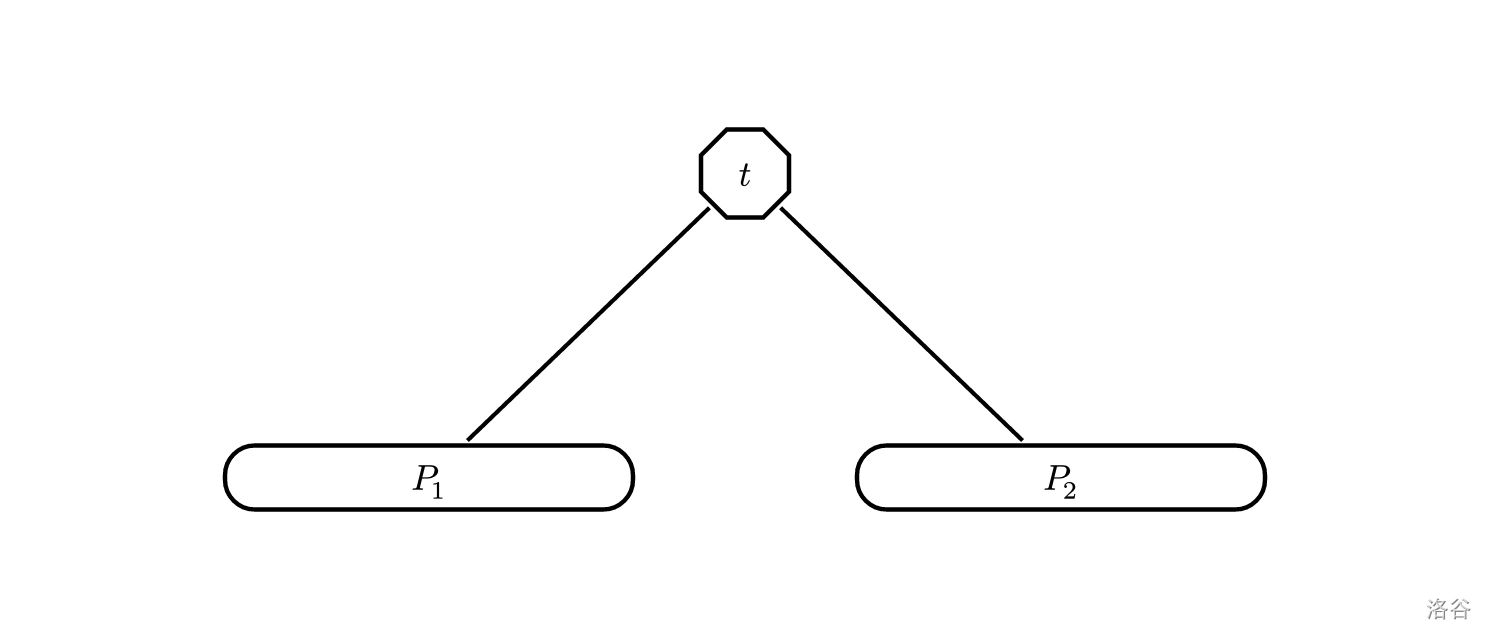
环簇的两个儿子必须是干净的路径。环上的点若挂着环外的子树,要先 Rake 掉。这就是前面那条约束,`retwist()` 会直接用到。
实现沿用 SATT 的点式三叉树。结点不维护边在点周围的顺序,所以 Twist 只需要两个儿子。四类结点共用一片数组,用 $\mathrm{type}$ 区分。
##### 1.2 四类结点
四类结点共用一个 $\mathrm{type}$ 字段。
| 符号 | 形状 | 名字 | 对应原图的东西 |
| --- | ---- | ------------- | --------------------- |
| $\texttt{c}$ | 圆角方形 | Compress Node | 原图的一个顶点(点权存在 $\mathrm{val}$ 里) |
| $\texttt{b}$ | 扁圆角条 | base 结点 / 叶簇 | 原图的一条边($\mathrm{dis}$ 就是边权) |
| $\texttt{r}$ | 圆 | Rake Node | 一组轻子树(旁支) |
| $\texttt{t}$ | 八边形 | Twist Node | 一个环(两个孩子是环的两条路径) |
下图是一棵仙人掌,路径 $1-2-3-5$,环 $2-3-4$,$6$ 挂在 $3$ 上,灰色数字是点权。
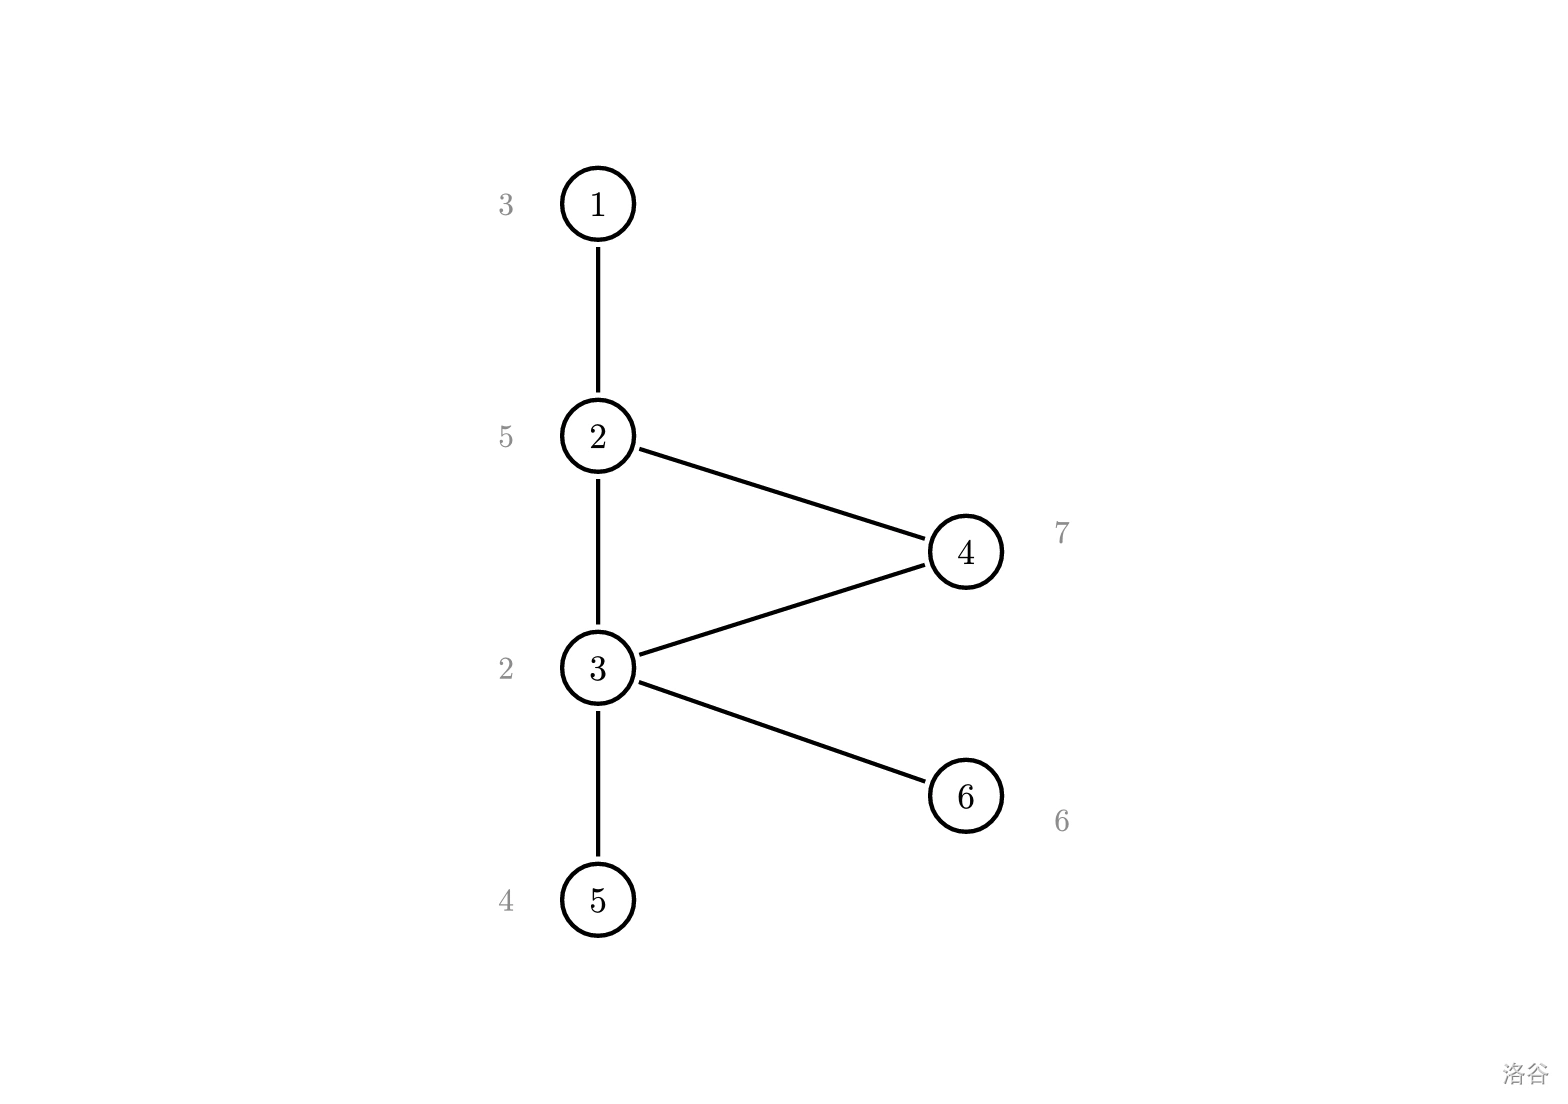
对应的 SATT 如下图。实线是 `ls/rs`,虚线是 $\mathrm{ms}$,结点形状见上表。根簇的 $P=\{1,2,3,5\}$、$T=\{4,6\}$,环 $2-3-4$ 被 Twist 成一条边,$6$ 通过 $\texttt{r}$ 结点挂在主链上。
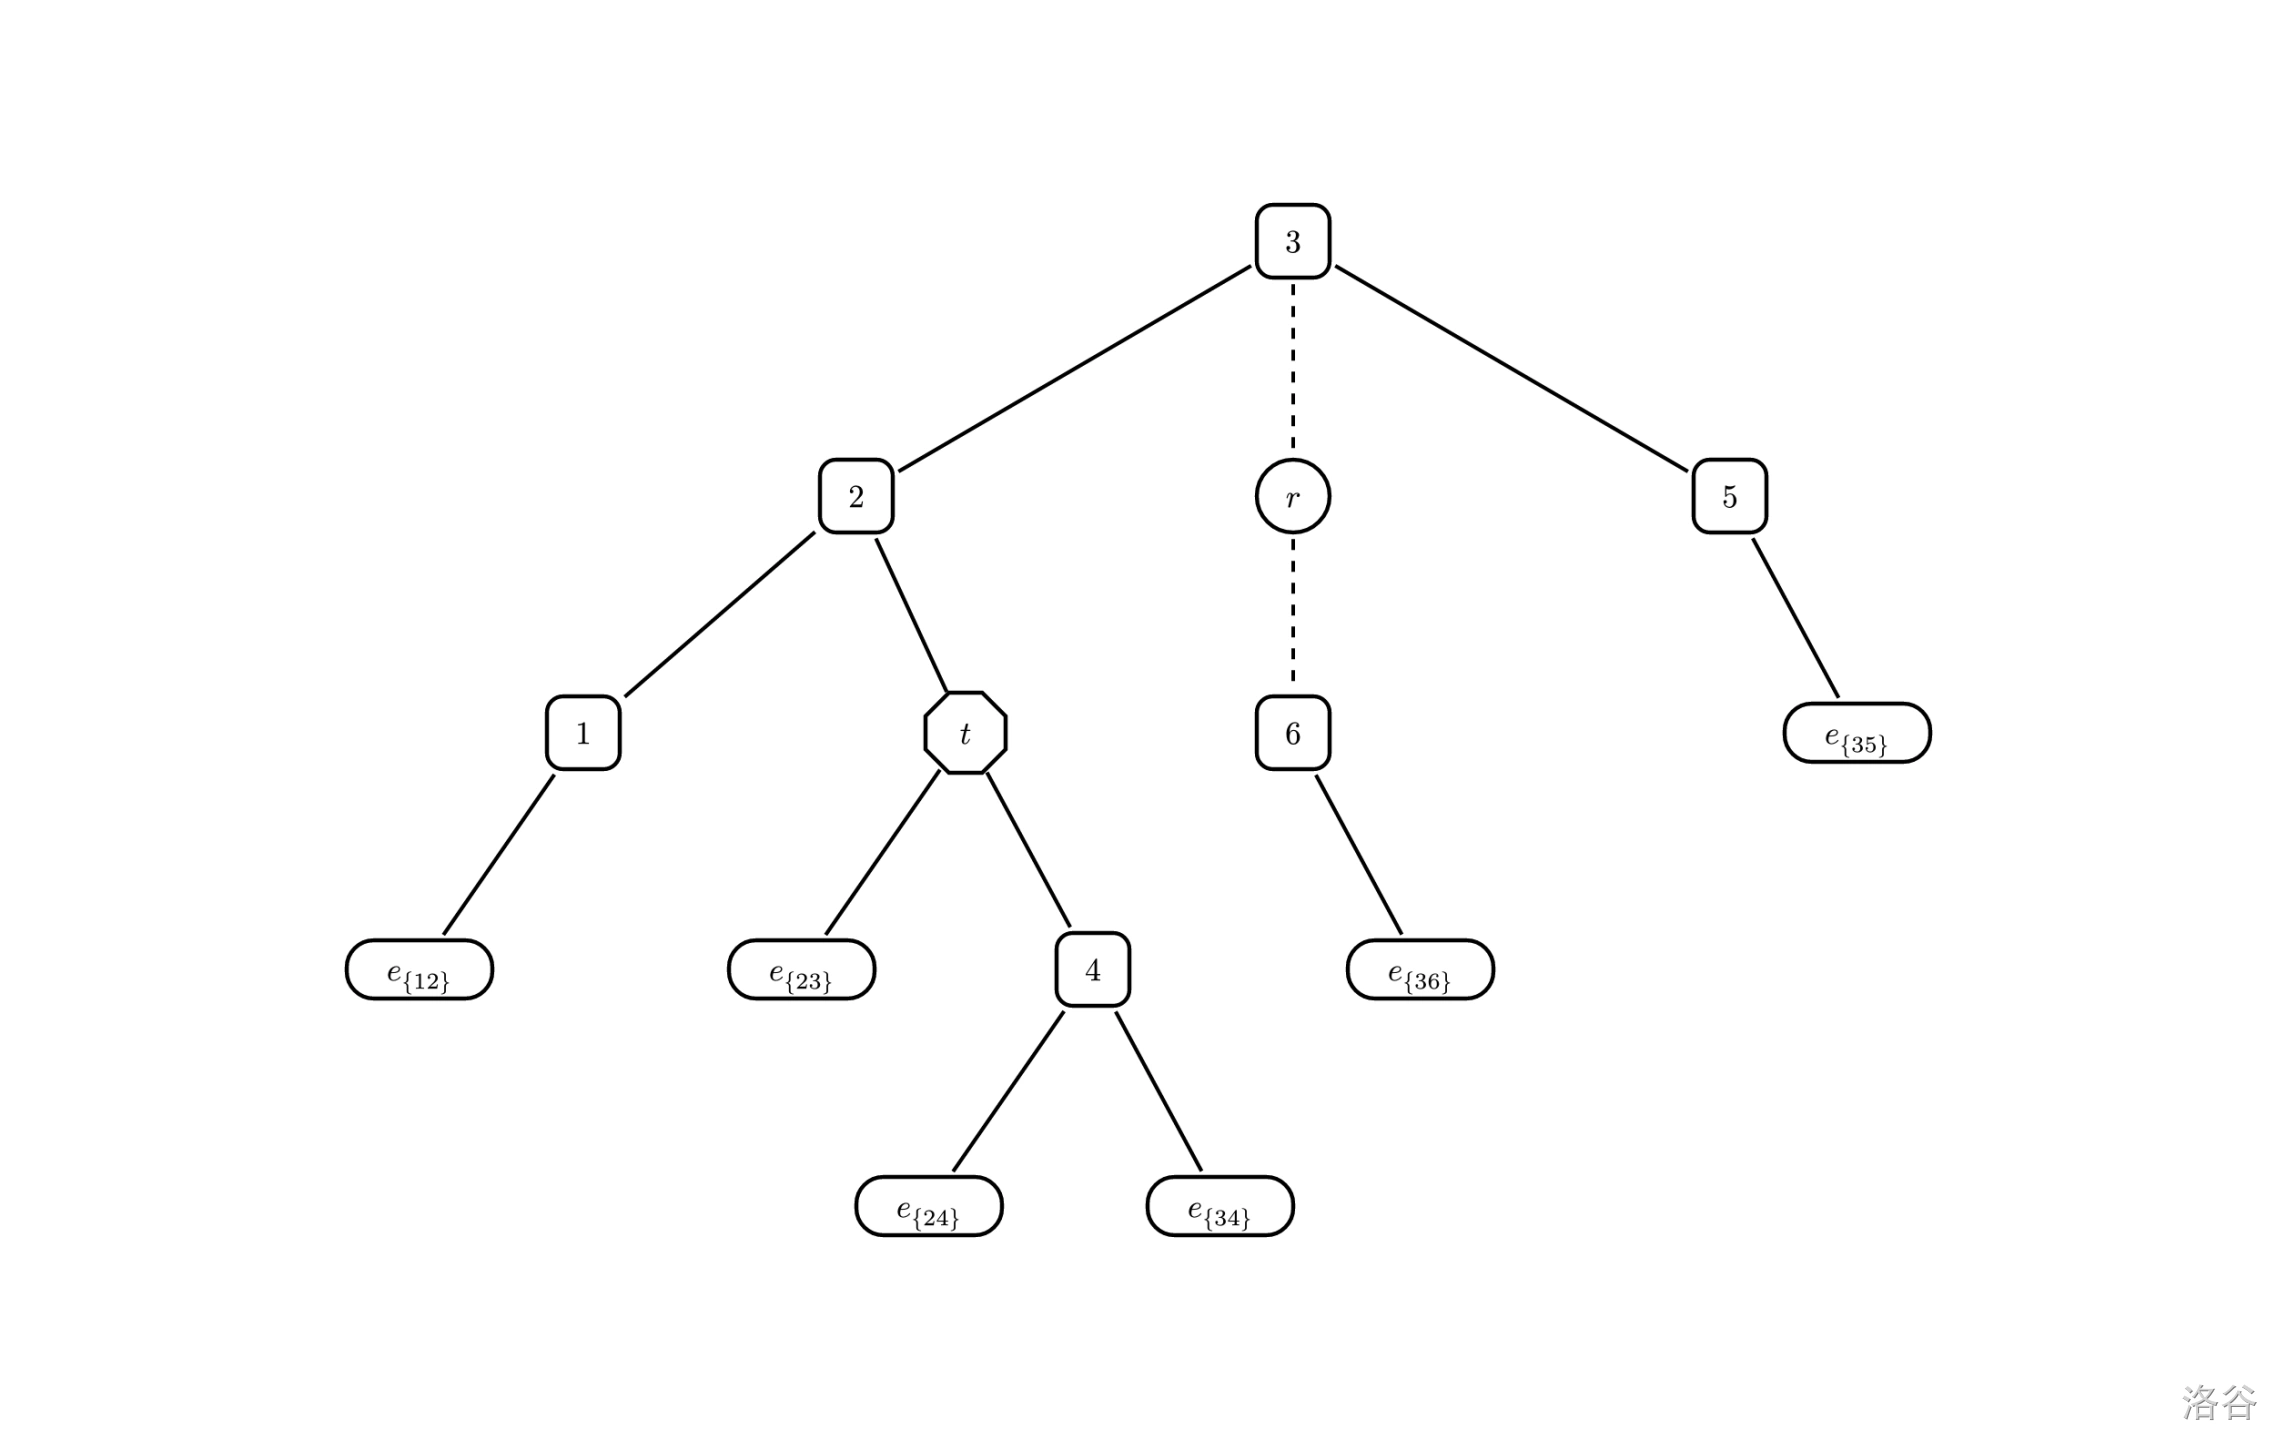
+ $\texttt{c}$ 与 SATT 的 Compress Node 相同,是主链上的结点,也是原图顶点,$\mathrm{val}$ 是点权。三个儿子里,`ls/rs` 是簇的两端,$\mathrm{ms}$ 是挂在这个顶点上的 Rake Tree。
+ $\texttt{b}$ 是 SATT 里单独拎出来的叶子簇,代表恰好一条边。$\mathrm{psiz}=\mathrm{tsiz}=0$,它只提供两个界点与边权。
+ $\texttt{r}$ 与 SATT 的 Rake Node 相同。中儿子是代表元,左右儿子是其余轻子树。`pushup()` 时先把中儿子的路径 `move()` 成旁支,再 rake 左右儿子。
+ $\texttt{t}$ 是新增的 Twist Node,代表一个环。两个儿子是环上的两条路径,界点相同,$\mathrm{cir}=1$。
界点不用另外找。每个 $\texttt{b}$ 自带两个端点。Compress 时左簇的 $u$ 与右簇的 $v$ 就是新簇的界点,合并时一起传上去。
`isrt()` 的判据与 SATT 相同,只是这里按类型判断,写成 `type(x) != type(fa(x))`。类型不同的是结构边,不参与旋转,因此 Splay 边只出现在 $\texttt{c}$-$\texttt{c}$ 与 $\texttt{r}$-$\texttt{r}$ 之间,$\texttt{b}$、$\texttt{t}$ 在 Splay 意义下永远是叶子。判据只看父子类型,四类结点才能共用一片数组。
#### 2. 簇的信息
##### 2.1 簇的信息与四种运算
一个簇记录这些信息:
$$F(C)=(u,v,d,P,T,\mathrm{flag})$$
$u,v$ 是簇的两个界点,$d$ 是界点之间最短路的长度。$P$ 是最短路经过的点集,$T$ 是簇内其余的点集,$P\cap T=\varnothing$,$P\cup T$ 是簇内全部点。$\mathrm{flag}$ 记录最短路是否不唯一。$P$ 与 $T$ 分别对应 SATT 的 $\mathrm{pth}$ 与 $\mathrm{str}$,$d$ 与 $\mathrm{flag}$ 是仙人掌多出来的。
$P,T$ 各用三个量刻画($w_x$ 是点 $x$ 的点权)。
$$\begin{aligned}
\mathrm{psiz} &:= |P|, &\quad \mathrm{pmin} &:= \min_{x\in P} w_x, &\quad \mathrm{psum} &:= \sum_{x\in P} w_x,\\
\mathrm{tsiz} &:= |T|, &\quad \mathrm{tmin} &:= \min_{x\in T} w_x, &\quad \mathrm{tsum} &:= \sum_{x\in T} w_x.
\end{aligned}$$
空集的最小值记为 $+\infty$,代码里是 `INT_MAX`;空集的和与大小都是 $0$。簇整体的三个量由这两组合成,$|C|=|P|+|T|$,$\min_C=\min(\min P,\min T)$,$\sum_C=\sum P+\sum T$。
`insert()` 只动 $P$。
$$\mathrm{psiz}\gets\mathrm{psiz}+1,\qquad \mathrm{pmin}\gets\min\{\mathrm{pmin},w\},\qquad \mathrm{psum}\gets\mathrm{psum}+w$$
`move()` 把 $P$ 并进 $T$,再清空 $P$。
$$\mathrm{tsiz}\gets\mathrm{tsiz}+\mathrm{psiz},\quad \mathrm{tsum}\gets\mathrm{tsum}+\mathrm{psum},\quad \mathrm{tmin}\gets\min\{\mathrm{tmin},\mathrm{pmin}\}$$
$$\mathrm{psiz}\gets0,\qquad \mathrm{psum}\gets0,\qquad \mathrm{pmin}\gets+\infty$$
标记也按这两个集合分。$\mathrm{tlaz}$ 加在 $T$ 上,$\mathrm{plaz}$ 加在 $P$ 上。
$$\mathrm{tmin}\gets\mathrm{tmin}+\mathrm{tlaz},\quad \mathrm{tsum}\gets\mathrm{tsum}+\mathrm{tsiz}\cdot\mathrm{tlaz},\quad \mathrm{pmin}\gets\mathrm{pmin}+\mathrm{plaz},\quad \mathrm{psum}\gets\mathrm{psum}+\mathrm{psiz}\cdot\mathrm{plaz}$$
两组量分开存,因为 $P$ 与 $T$ 上的加法互不影响。
$P$ 由路径上的 $\texttt{c}$ 结点组成。每个 $\texttt{c}$ 贡献一次自己的 $\mathrm{val}$,两个界点是最外层的 $\texttt{c}$,也在 $P$ 里。$T$ 是这些结点上挂的旁支;环簇不等长时,还要加上被舍弃的那条路径。于是 $P\cup T$ 是簇内全部点,`query1`/`add1` 只看 $P$,`query2`/`add2` 只看 $T$。
四种运算如下。
```cpp
dat compress(const dat &a, const dat &b, int w) {
return {a.u, b.v, a.dis + b.dis,
a.tsiz + b.tsiz, min(a.tmin, b.tmin), a.tsum + b.tsum,
a.psiz + b.psiz + 1, min({a.pmin, b.pmin, w}),
a.psum + b.psum + w, a.flag || b.flag};
}
dat rake(const dat &a, const dat &b) {
return {a.u, a.v, a.dis,
a.tsiz + b.tsiz, min(a.tmin, b.tmin), a.tsum + b.tsum,
a.psiz, a.pmin, a.psum, a.flag};
}
dat twist(dat a, dat b) {
if (a.dis > b.dis)
swap(a, b);
if (a.dis == b.dis)
return {a.u, a.v, a.dis,
a.tsiz + b.tsiz, min(a.tmin, b.tmin), a.tsum + b.tsum,
a.psiz + b.psiz, min(a.pmin, b.pmin), a.psum + b.psum, 1};
b = b.move();
return {a.u, a.v, a.dis,
a.tsiz + b.tsiz, min(a.tmin, b.tmin), a.tsum + b.tsum,
a.psiz, a.pmin, a.psum, a.flag};
}
dat move() const {
return {u, v, dis, tsiz + psiz, min(tmin, pmin), tsum + psum,
0, MAX, 0, flag};
}
```
Compress 把两段首尾相接的路径拼起来,$d\gets d_a+d_b$,$P\gets P_a\cup P_b\cup\{w\}$,$T\gets T_a\cup T_b$,$\mathrm{flag}\gets \mathrm{flag}_a\lor\mathrm{flag}_b$。$w$ 是中间那个点。
Rake 不动簇路径,$d\gets d_a$,$P\gets P_a$,只把 $T$ 并起来。
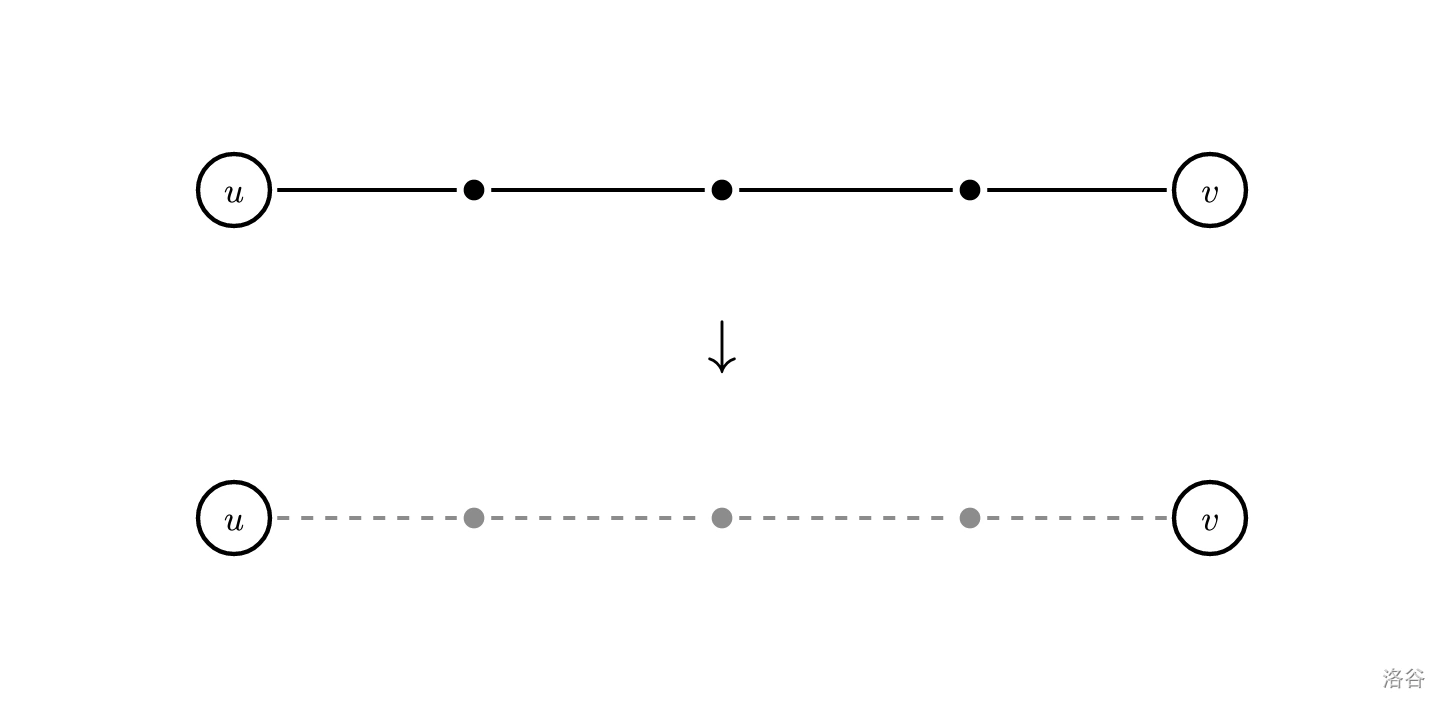
Twist 先保证 $d_a\le d_b$。不等长时 $d\gets d_a$,$P\gets P_a$,$T\gets T_a\cup T_b\cup P_b$,$\mathrm{flag}\gets \mathrm{flag}_a$。等长时两条都是最短路,$P\gets P_a\cup P_b$,$T\gets T_a\cup T_b$,$\mathrm{flag}\gets1$。
Move 把 $P$ 并进 $T$,再清空 $P$。
Compress 如图所示,$w$ 由界点变成内部点。
Rake 如图所示,簇路径不变。
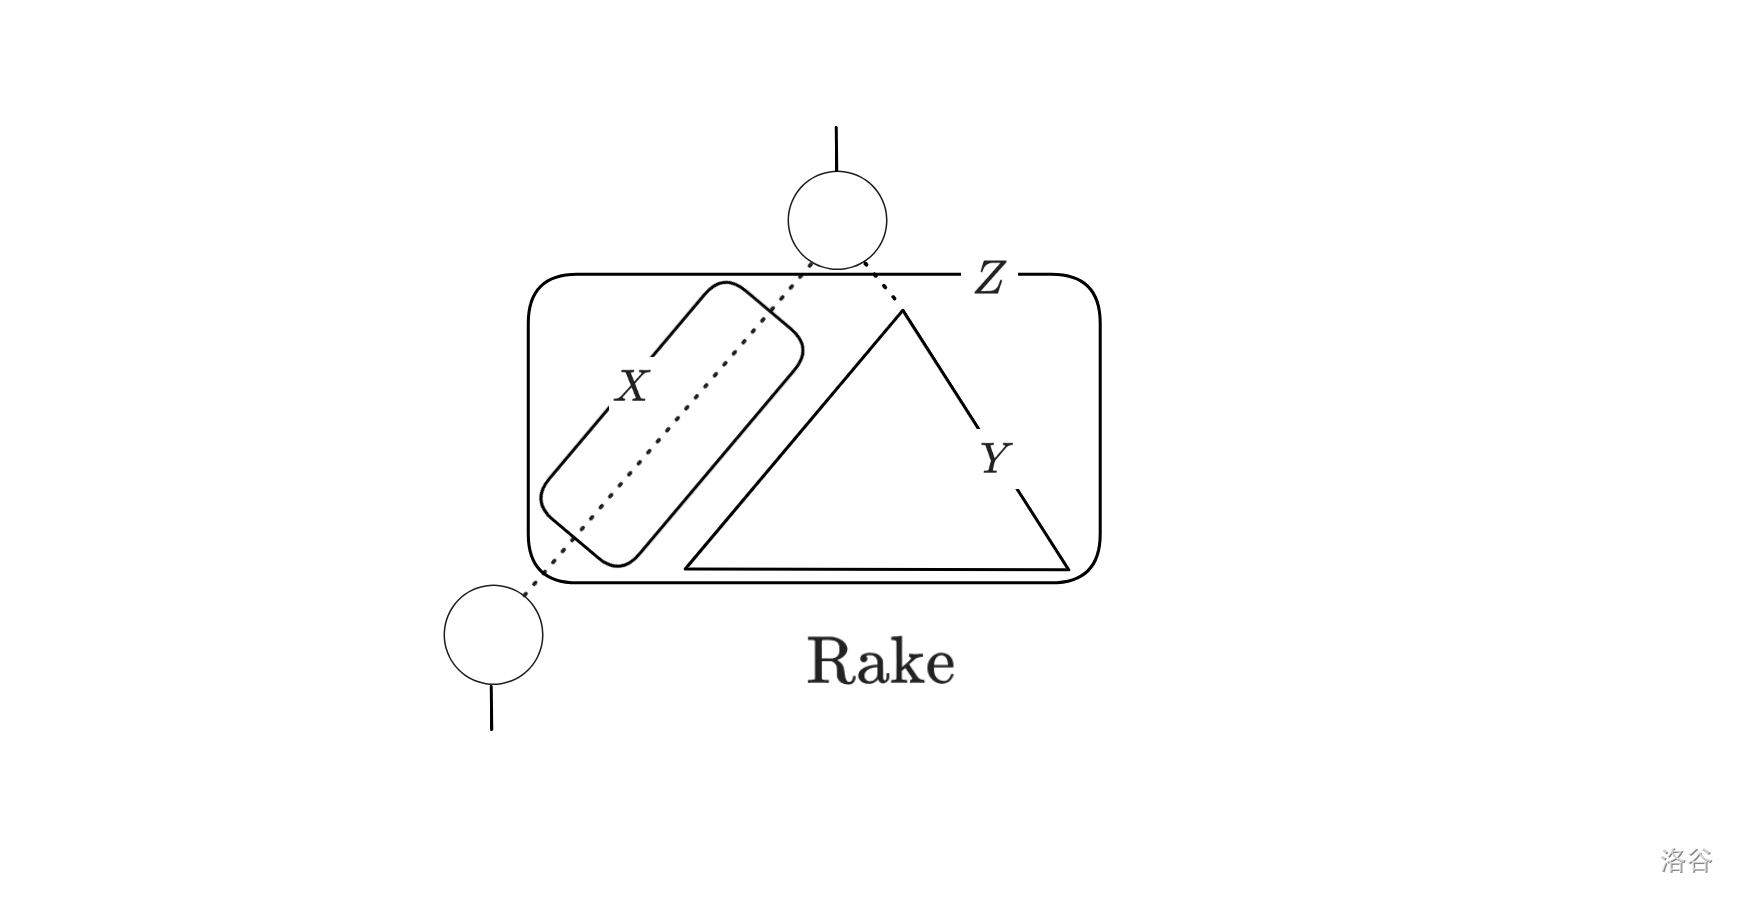
这两个操作与树上的 Top Tree 一致,图例我就复用了。
Twist 如图所示,短的一侧留作簇路径,长的一侧整条进 $T$。
Move 如图所示,整条路径降级为旁支。
:::warning[为什么 Rake 里不合并 $P$]
代码里 `rake(a,b)` 完全没有把 $b$ 的 $P$ 加进去,因为显然 `rake()` 的第二个参数只可能是 $\texttt{r}$ 结点(`pushup()` 中写作 `rake(f(rs(x)), f(ms(x)))`),而 $\texttt{r}$ 结点在 `pushup()` 的第一步就把中儿子的路径 Move 掉了,所以它的 $P$ 恒为空(`psiz=0, pmin=INF`)。
同理,`rake()` 的结果 $\mathrm{flag}$ 只取 `a.flag`:$b$ 内部的最短路是否唯一,与当前簇路径是否唯一无关。
:::
##### 2.2 pushup
三种结点的 `pushup()` 如下。
```cpp
void pushup(int x) {
if (type(x) == 'c') {
if (ls(x) && rs(x)) {
if (ms(x))
f(x) = compress(f(ls(x)), rake(f(rs(x)), f(ms(x))), val(x));
else
f(x) = compress(f(ls(x)), f(rs(x)), val(x));
} else {
if (ls(x) || rs(x))
f(x) = f(ls(x) | rs(x));
else
f(x) = {x, x, 0, 0, MAX, 0, 0, MAX, 0, 0};
f(x).insert(val(x));
if (ms(x))
f(x) = rake(f(x), f(ms(x)));
}
cir(x) = cir(ls(x)) | cir(rs(x));
} else if (type(x) == 'r') {
f(x) = f(ms(x)).move();
if (ls(x))
f(x) = rake(f(x), f(ls(x)));
if (rs(x))
f(x) = rake(f(x), f(rs(x)));
} else if (type(x) == 't') {
f(x) = twist(f(ls(x)), f(rs(x)));
cir(x) = 1;
}
}
```
+ $\texttt{c}$ 同 SATT 的 Compress Node,三元合并,左右儿子接上自己这个点,中儿子是挂在这个点上的旁支。左右儿子都在时先把中儿子 rake 到右儿子上,再与左儿子 Compress;只剩一个儿子时它就是路径端点。$\mathrm{cir}$ 沿左右儿子取或。
+ $\texttt{r}$ 同 SATT 的 Rake Node。SATT 里把中儿子的 $\mathrm{pth}$ 乘进 $\mathrm{str}$,这里写成 `move()` 之后再 rake 左右儿子。$\mathrm{val}$ 对它没有意义。
+ $\texttt{t}$ 是新增的环结点,两个儿子是环的两条路径,`twist()` 并起来,同时把 $\mathrm{cir}$ 置 $1$。
$\mathrm{cir}$ 记录簇内是否含环,只在 `link()` 判合法性时用到。
##### 2.3 懒标记与 pushdown
懒标记有两个分量,与 SATT 的两种标记对应。$\mathrm{plaz}$ 加在 $P$ 上,对应 $\mathrm{tpth}$;$\mathrm{tlaz}$ 加在 $T$ 上,对应 $\mathrm{tstr}$。`add1` 用前者,`add2` 用后者。`rev` 的处理与 SATT 相同,只是这里还要把 $u,v$ 对调。
```cpp
struct tag {
int tlaz, plaz;
tag tree() { return {tlaz, 0}; }
tag move() { return {tlaz, tlaz}; }
friend tag operator*(const tag &x, const tag &y) {
return {x.tlaz + y.tlaz, x.plaz + y.plaz};
}
};
```
`tree()` 丢掉 $\mathrm{plaz}$,用于整棵都落在 $T$ 里的 Rake Tree。`move()` 把 $\mathrm{plaz}$ 取成与 $\mathrm{tlaz}$ 相同,用于从路径降级成旁支的簇。
两个分量不能合并。环簇的 $P$ 与 $T$ 不是同一个点集,两条路径不等长时,短的留在 $P$,长的整条进 $T$。子树加要加整条环,最短路加只加 $P$,一个数表达不了两种加量。
标记作用到 `dat` 上由重载的 `dat * tag` 完成。
```cpp
friend dat operator*(const dat &x, const tag &y) {
return {x.u, x.v, x.dis,
x.tsiz, x.tmin == MAX ? MAX : x.tmin + y.tlaz,
x.tsum + 1ll * x.tsiz * y.tlaz,
x.psiz, x.pmin == MAX ? MAX : x.pmin + y.plaz,
x.psum + 1ll * x.psiz * y.plaz, x.flag};
}
```
`pushlaz()` 除了更新 `dat`,还要把 $\mathrm{plaz}$ 加进 $\texttt{c}$ 结点的 $\mathrm{val}$。$\mathrm{val}$ 是原图点权,`dat` 只是摘要,不同步改的话下一次 `pushup()` 会用旧值重算。
`pushdown()` 按类型分流。$\texttt{c}$ 与 $\texttt{r}$ 的规则和 SATT 相同,只有 $\texttt{t}$ 的分流是新的。
```cpp
if (type(x) == 'c') {
pushlaz(ls(x), laz(x));
pushlaz(rs(x), laz(x));
pushlaz(ms(x), laz(x).tree());
} else if (type(x) == 'r') {
int w = laz(x).tlaz;
for (int c = 0; c < 3; c++)
pushlaz(son(x, c), {w, 0});
pushlaz(ms(x), {0, w});
} else if (type(x) == 't') {
int w = f(ls(x)).dis - f(rs(x)).dis;
pushlaz(ls(x), w <= 0 ? laz(x) : laz(x).move());
pushlaz(rs(x), w >= 0 ? laz(x) : laz(x).move());
}
```
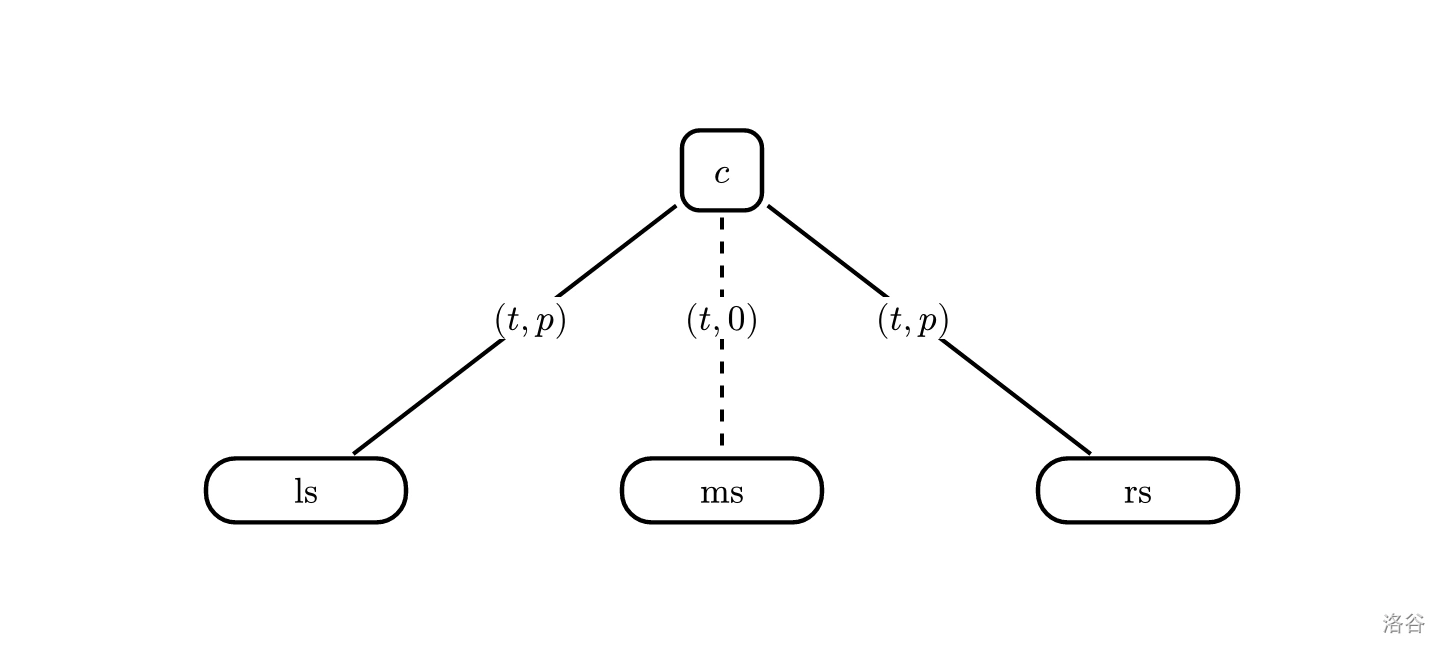
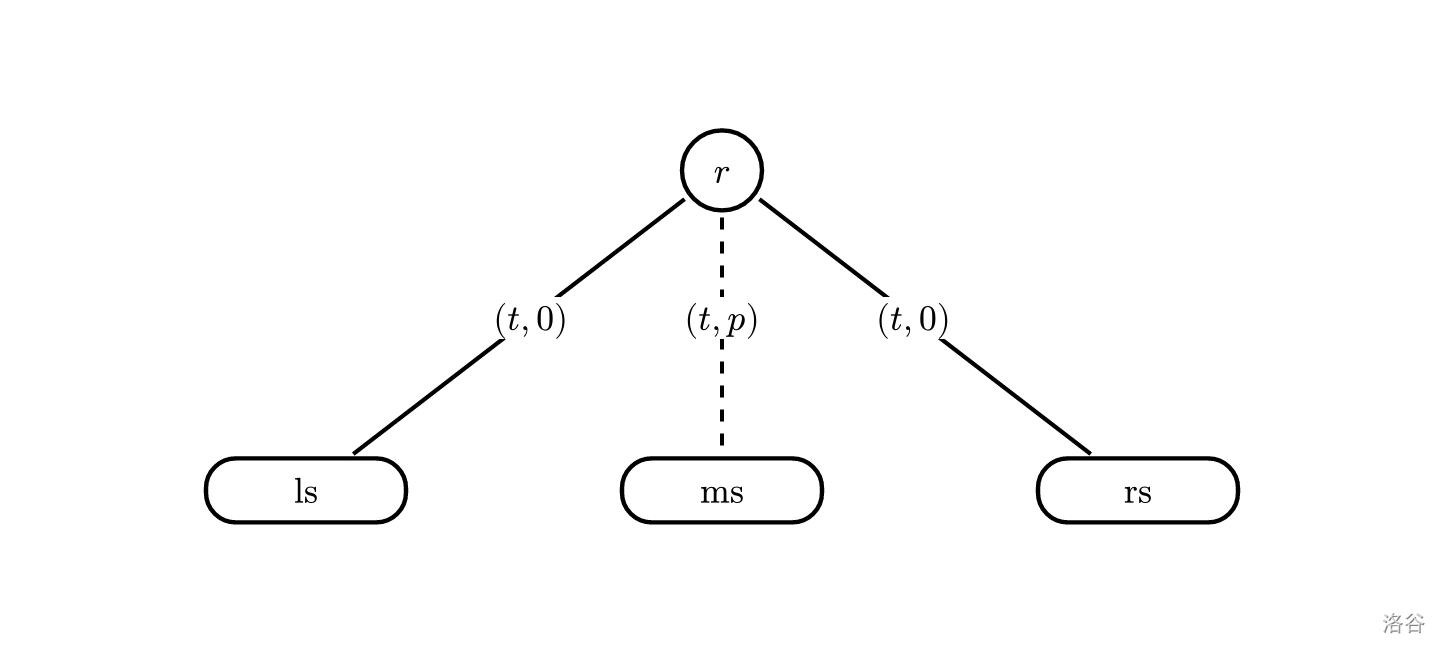
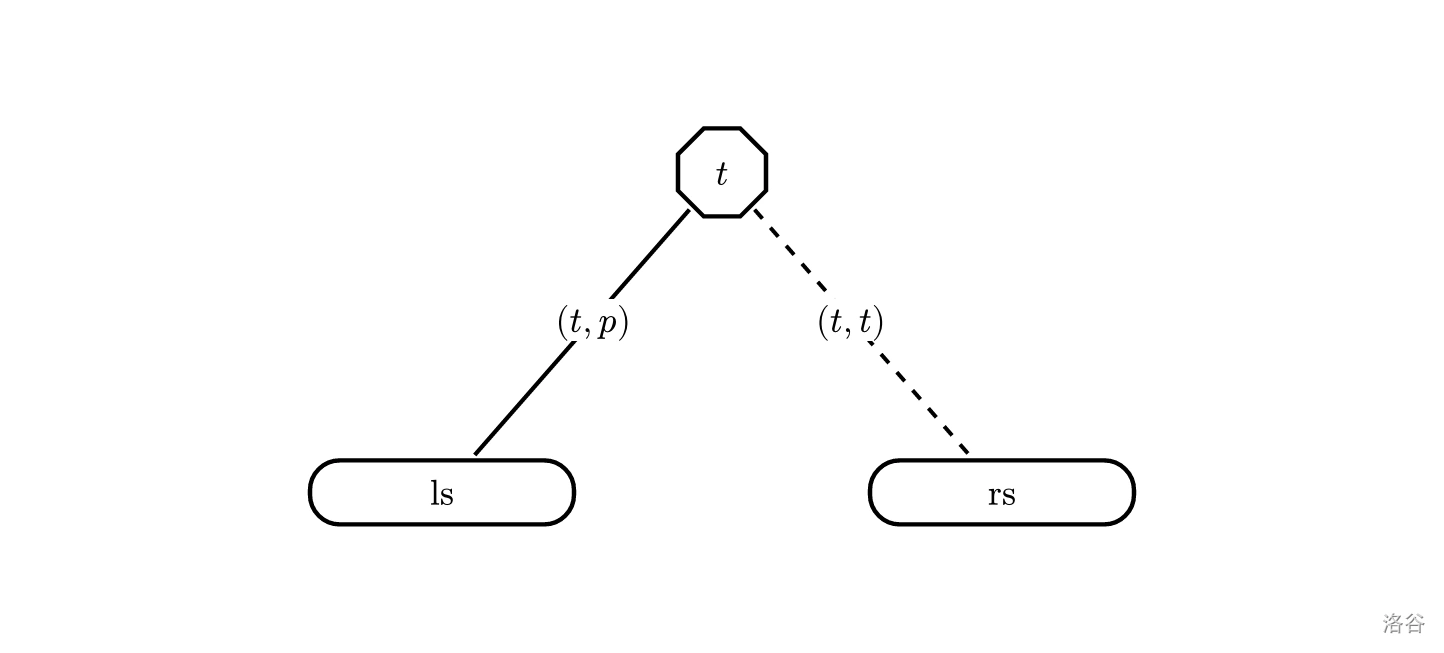
$\texttt{c}$ 的左右儿子在簇路径上,拿完整标记;中儿子整块属于旁支,只拿 `tree()`。$\texttt{r}$ 的三个儿子都拿 $\mathrm{tlaz}$,中儿子是一条路径,再额外拿一份 $\mathrm{plaz}$。$\texttt{t}$ 是新增的分流,两条路径里短的在 $P$ 里,长的整条在 $T$ 里。
设 $w$ 为左右儿子的 $d$ 之差。$w<0$ 时左儿子短,拿完整标记;右儿子整条进 $T$,拿 `move()`。$w>0$ 对称。$w=0$ 时两条都是最短路,都拿完整标记。这三个分支与 `twist()` 里的比较是一回事。
分流如下图。图中 $(t,p)$ 表示 $(\mathrm{tlaz},\mathrm{plaz})$,虚线表示这个儿子不在簇路径上。
$\texttt{c}$:两个儿子拿完整标记,中儿子只拿 $\mathrm{tlaz}$。
$\texttt{r}$:三个儿子都拿 $\mathrm{tlaz}$,中儿子再额外拿一份 $\mathrm{plaz}$。
$\texttt{t}$、$w<0$:左侧拿完整标记,右侧拿 `move()`。
$\texttt{t}$、$w=0$:两侧都拿完整标记。
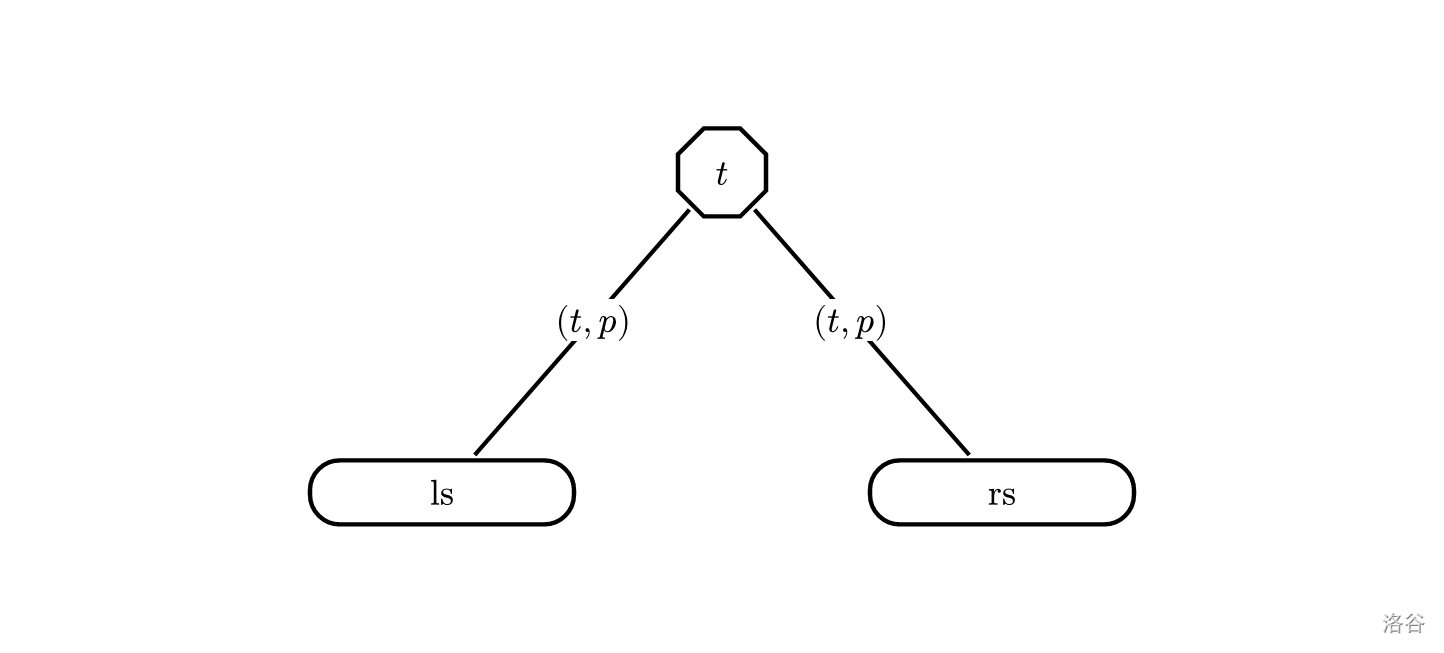
#### 3. 结构操作
##### 3.1 Access、Splice 与 Retwist
`access(x)` 沿用 SATT 的 Access,只在向上跳的循环里多了一个分支。开头有右儿子时,要把它和中儿子打包成 Rake 结点。父亲是 $\texttt{t}$ 时先跳过这一步,把这一段路径留给 `retwist()`。
```cpp
for (; splay(x), fa(x);) {
if (type(fa(x)) == 'r')
splice(fa(x));
else
retwist(x);
}
```
$x$ 已经 Splay 到 Compress Tree 的顶端,父亲只可能是 $\texttt{r}$ 或 $\texttt{t}$。是 $\texttt{r}$ 就跨过一棵 Rake Tree,走 `splice()`;是 $\texttt{t}$ 就穿过一个环,走 `retwist()`。
`splice()` 的交换与 SATT 的 Splice 相同,只多了一个出口。$y$ 的父亲是 $\texttt{t}$ 时改走 `retwist()`;否则照常交换 $x$ 的中儿子与 $y$ 的右儿子。
```cpp
int a = ms(x), b = rs(y);
setf(a, y, 1);
setf(b, x, 2);
pushup(x);
```
它改的是重链的划法,原图不变。
`retwist()` 处理 Splice 走进环的情形。Splice 把主链伸进环里,环簇原来的两个端点随之失效,Twist 分解要拆开重装。下图中 $a,b$ 是环簇原来的端点,主链经过 $u,v$,$u,v$ 与 $a,b$ 不同。
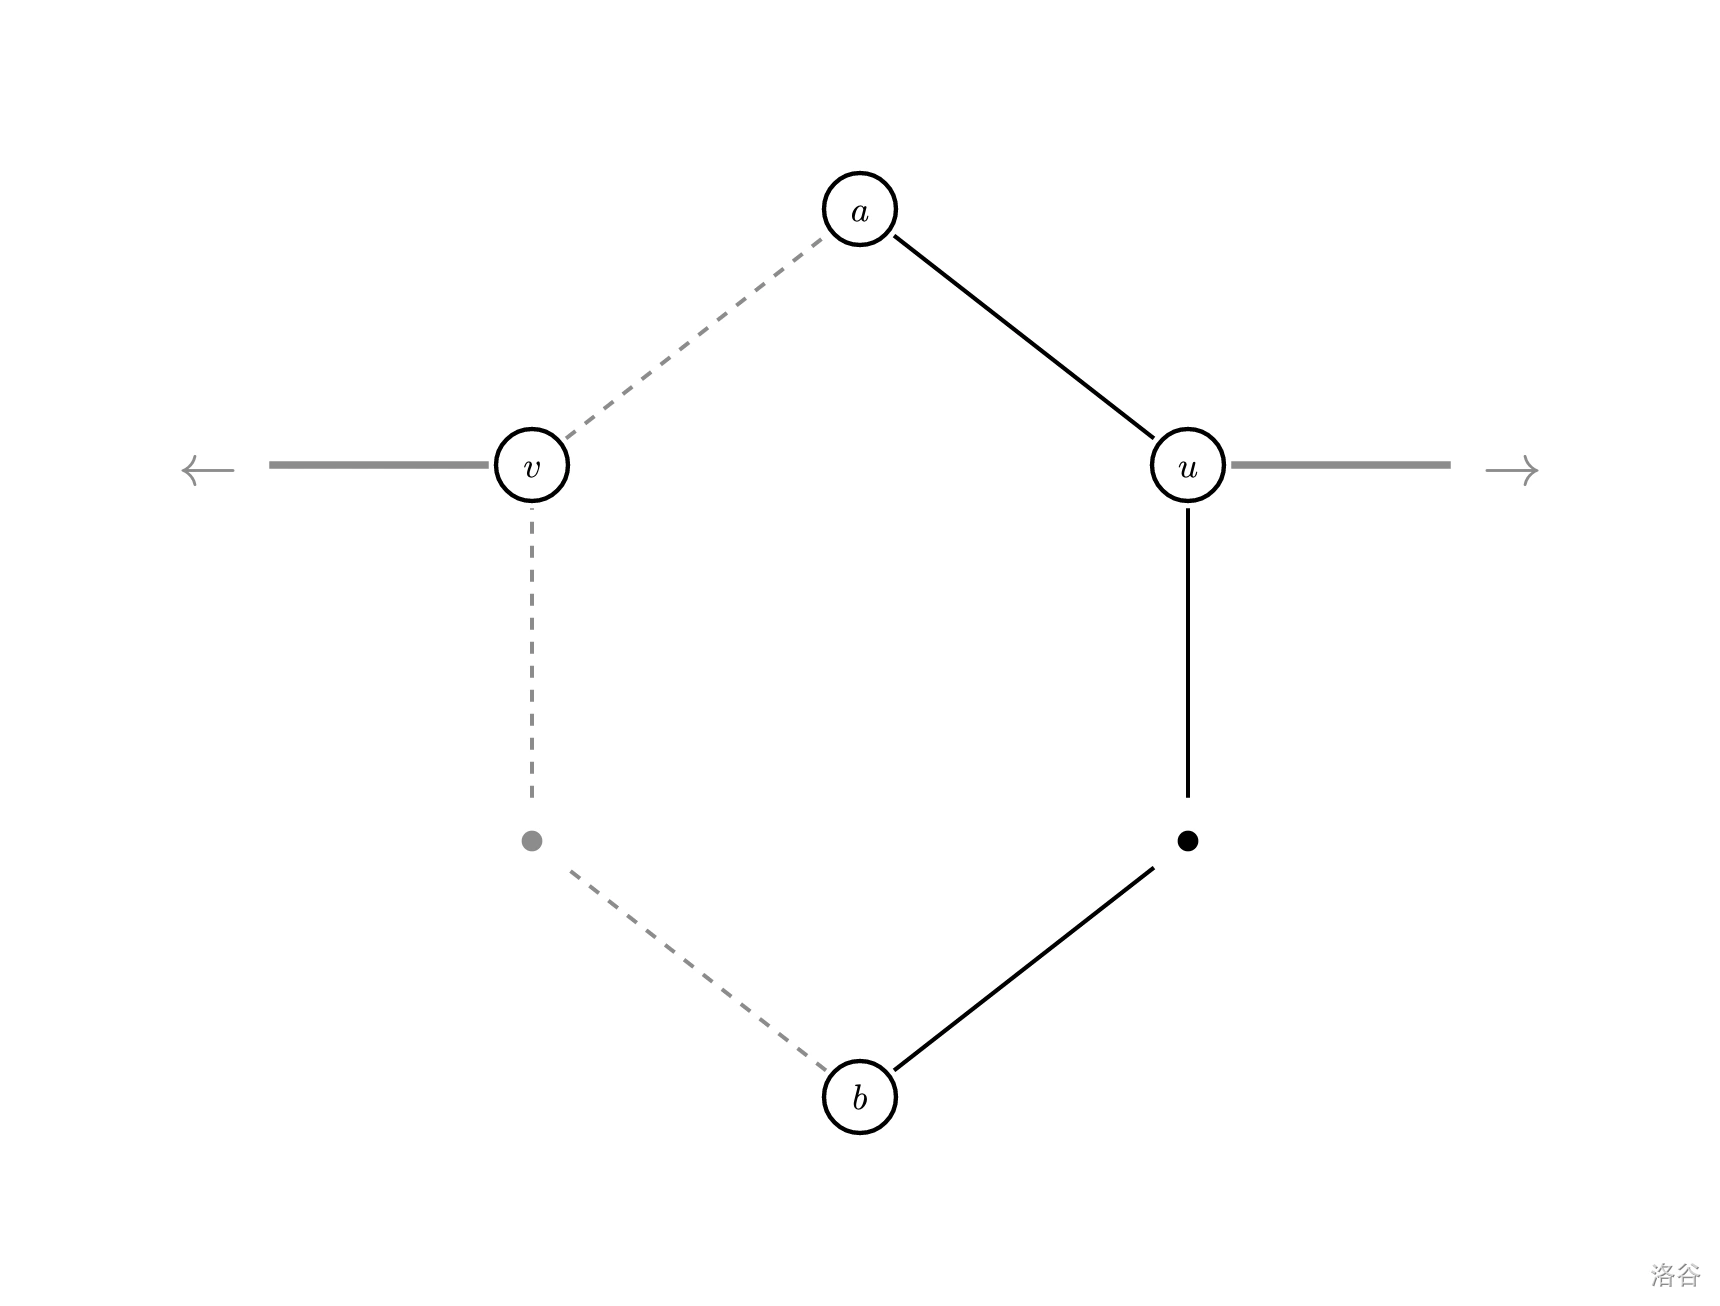
重装分为五个步骤:
1. 取出环的两个原端点 $a,b$。
2. 对 $b,a$ 依次做 Local Splay,把环转到可以重装的位置。
3. 拆开 Twist,选一条路留作主路径,另一条整条变成旁支。
4. 路径上挂着的旁支先 rake 成新的 $\texttt{r}$ 结点。Twist 的两条路径之间不能夹别的边,这一步是前提。
5. 重新 Twist,环的两个端点换成 $u,v$。
第 2 步对应这段代码。
```cpp
int a = f(x).u, b = f(x).v;
splay(b);
if (ls(b) == y) {
splice(fa(b));
return retwist(x, p);
}
splay(a);
```
第 4 步要把 $b$ 上多出来的旁支收成一个新的 $\texttt{r}$ 结点。`rs(b)` 作它的中儿子,`ms(b)` 作左儿子。
```cpp
if (rs(b)) {
int z = newnode('r');
setf(rs(b), z, 2), rs(b) = 0;
setf(ms(b), z, 0);
pushup(z), setf(z, b, 2);
}
```
其余操作只在 Splay 树上摆父子关系。Retwist 与 SATT 的 Access 一样,改的是表示,原图不变。
##### 3.2 Link 与 Cut
```cpp
bool link(int x, int y, int w) {
if (x == y)
return 0;
makeroot(x);
if (findroot(y) == x) {
if (cir(x))
return 0;
fa(rs(x)) = 0;
splay(y), setf(y, x, 1);
int z = newnode('t'), e = newnode('b');
f(e) = {x, y, w, 0, MAX, 0, 0, MAX, 0, 0};
pushdown(y);
setf(ls(y), z, 0);
setf(e, z, 1);
pushup(z), setf(z, y, 0);
pushup(y), pushup(x);
} else {
access(x), access(y);
int e = newnode('b');
f(e) = {y, x, w, 0, MAX, 0, 0, MAX, 0, 0};
setf(e, x, 0);
pushup(x), setf(x, y, 1);
pushup(y);
}
return 1;
}
```
两点不连通时,新边是一条普通的 $\texttt{b}$ 边,接到 SATT 上即可。这一步和 SATT 的 Link 是同一个思路,只是多了一个结点记边权。
两点已经连通时,新边一定成环。先看 `cir(x)`。$x\to y$ 的路径上若已经有环,再加一条边会让某些边属于两个环,直接失败。合法时,断开 $x$ 的右儿子,$x,y$ 就是路径两端。再造一个 $\texttt{t}$ 和一个 $\texttt{b}$。$\texttt{b}$ 是新边,$\texttt{t}$ 的左儿子是原路径,右儿子是新边。最后把 $\texttt{t}$ 挂到 $y$ 的左边。
```cpp
bool cut(int x, int y, int w) {
if (x == y)
return 0;
makeroot(x);
if (findroot(y) != x)
return 0;
access(y);
fa(ls(y)) = 0;
splay(x), setf(x, y, 0), pushup(y);
if (type(rs(x)) == 'b') {
if (f(rs(x)).dis != w)
return 0;
clear(rs(x)), rs(x) = 0;
fa(x) = ls(y) = 0;
pushup(x), pushup(y);
return 1;
} else if (type(rs(x)) == 't') {
int z = rs(x), k = 0;
pushdown(z);
if (type(son(z, k)) != 'b' || f(son(z, k)).dis != w)
k = 1;
if (type(son(z, k)) != 'b' || f(son(z, k)).dis != w)
return 0;
setf(son(z, !k), x, 1), pushup(x), pushup(y);
clear(z);
return 1;
} else
return 0;
}
```
Cut 与 Link 对偶。先把 $x\to y$ 的路径露成 $x$ 是 $y$ 左儿子的形态,再看 $x$ 的右儿子。
如果 $x$ 的右儿子是 $\texttt{b}$ 且 $\mathrm{dis}=w$,直接回收。是 $\texttt{t}$ 就在它的两个儿子里找权值为 $w$ 的 $\texttt{b}$。把另一条路径接回 $x$ 的右边,回收整个 $\texttt{t}$,环随之消失。其余情况失败。
Cut 只比较 $\mathrm{dis}$。同一对端点之间可能有多条同权边,删掉任意一条都不影响答案。
#### 4. 实现
##### 4.1 查询与修改
四个操作都不长,困难都在 `pushup()` 里。
```cpp
pair<int, ll> pquery(int x, int y) {
makeroot(x);
if (findroot(y) != x)
return {-1, -1};
if (f(x).flag)
return {-2, -2};
return {f(x).pmin, f(x).psum};
}
pair<int, ll> tquery(int x, int y) {
makeroot(x);
if (findroot(y) != x)
return {-1, -1};
splay(y);
return {min(f(ms(y)).tmin, val(y)), f(ms(y)).tsum + val(y)};
}
bool pupdate(int x, int y, int w) {
makeroot(x);
if (findroot(y) != x)
return 0;
if (f(x).flag)
return 0;
return pushlaz(x, {0, w}), 1;
}
bool tupdate(int x, int y, int w) {
makeroot(x);
if (findroot(y) != x)
return 0;
splay(y), val(y) += w;
return pushlaz(ms(y), {w, 0}), pushup(y), 1;
}
```
`query1` 换根为 $v$ 后判连通。$\mathrm{flag}$ 为真说明最短路不唯一,返回 `-2 -2`;否则 $v$ 被 Splay 到根,它的簇就是 $v\to u$ 这条路径,直接取 $P$。
`query2` 在 `splay(u)` 之后,$u$ 的右儿子方向已经剥空,后代全在它的中儿子里,再加上 $u$ 自己的点权就是子仙人掌。
`add1` 给整条路径打 `{0,w}`。`add2` 给中儿子打 `{w,0}`,再单独改 $u$。
##### 4.2 完整代码
在[云剪贴板](https://www.luogu.com.cn/paste/pg8oru9s)中查看。
#### 5. Bonus
该代码能通过 UOJ 的数据,但是仅更改输入输出格式后无法通过洛谷的动态仙人掌 4,结合讨论区以及与 ds 讨论目前认为本题极有可能是 std 有锅,导致只能用一种不完全正确的 LCC 写法才可通过。
理论上我应该补充 Top Tree 维护广义串并联图,对 Top Tree 做 Top Tree 的部分,不过目前先搁置着吧。
## References
[1] OI-wiki. Top Tree[EB/OL]. https://oi-wiki.org/ds/top-tree.
[2] Autre. 简明 TopTree 指南[EB/OL]. 洛谷专栏. https://www.luogu.com.cn/article/arezeyav.
[3] 251sec. 这个世界就是一棵巨大的 SATT[EB/OL]. 洛谷专栏. https://www.luogu.com.cn/article/bh8zlk4j.
[4] negiizhao. Top tree 相关东西的理论、用法和实现[EB/OL]. UOJ 博客. https://negiizhao.blog.uoj.ac/blog/4912.
[5] ExplodingKonjac. Top Tree 相关理论扯淡[EB/OL]. 博客园. https://www.cnblogs.com/ExplodingKonjac/p/17890636.html.
[6] Tarjan R E, Werneck R F. Self-Adjusting Top Trees[C]//Proceedings of the 16th Annual ACM-SIAM Symposium on Discrete Algorithms (SODA). 2005: 813-822. https://renatowerneck.wordpress.com/wp-content/uploads/2016/06/tw05-self-adjusting-top-tree.pdf.
[7] Werneck R F. Design and Analysis of Data Structures for Dynamic Trees[D]. Princeton University, 2006. https://www.cs.princeton.edu/techreports/2006/750.pdf.