字符串综合
chenhanzheapple
·
·
算法·理论
未完工。
文章中,\lvert S \rvert 表示字符串 S 的长度,sub(S,i,j) 表示字符串 S 的第 i \sim j 个字符连起来组成的字符串。
字符串哈希
算法介绍
我们考虑将每个字符串变成一个数,将数去重得到答案。
考虑将字符串看做一个 base 进制的数,这个数的第 i 位就是该字符串第 i 位的 ASCII 码值,这个数被称为改字符串的哈希值。
当然这个数可能很大,因此要取模。可以发现,如果取模,则两个不同字符串的哈希值可能相同,这就是哈希冲突。一般在字符串哈希题目中,出题人会卡掉一些常见模数(比如洛谷里的字符串哈希模板题卡掉了 10^9+7、998244353 和 19260817),因此我们需要使用尽可能大或生僻的模数,如 212370440130137957。
另一种解决数太大的办法是使用自然溢出,也就是开 unsigned long long,且不取模,当数超过最大上限时,它会从最小上限开始重新计数。利用这一点,也可以解决这道题。这种方法虽然很容易被卡,但是这道题可以通过。
代码实现
以 P3370 【模板】字符串哈希 为例。
### 取模
```cpp
#include<bits/stdc++.h>
#define int long long
using namespace std;
int n,m;
const int MOD = 212370440130137957;
string s;
map<int,bool> vis;
signed main(){
ios::sync_with_stdio(0);
cin.tie(0);
cout.tie(0);
cin >> n;
while(n--){
cin >> s;
m = s.size();
s = " "+s;
int hashs = 0;
for(int i=1;i<=m;i++){
hashs = (hashs*233+s[i])%MOD;
}
vis[hashs] = 1;
}
cout << vis.size();
return 0;
}
```
### 自然溢出
```cpp
#include<bits/stdc++.h>
#define int unsigned long long
using namespace std;
int n,m;
string s;
map<int,bool> vis;
signed main(){
ios::sync_with_stdio(0);
cin.tie(0);
cout.tie(0);
cin >> n;
while(n--){
cin >> s;
m = s.size();
s = " "+s;
int hashs = 0;
for(int i=1;i<=m;i++){
hashs = hashs*233+s[i];
}
vis[hashs] = 1;
}
cout << vis.size();
return 0;
}
```
## 例题
> 【模板】字符串匹配
>
> 给定两个字符串 $S$ 和 $T$,求 $T$ 有多少个连续子串等于 $S$,即 $S$ 在 $T$ 中的出现次数。$1 \le \lvert S \rvert \le \lvert T \rvert \le 10^6$。
考虑处理出 $h_i$ 表示 $T$ 前 $i$ 个字符的哈希值,这可以递推得到。然后计算出 $S$ 的哈希值。
然后枚举 $T$ 所有长度为 $\lvert S \rvert$ 的子串,用类似前缀和的方式判断该子串的哈希值是否等于 $S$ 即可。
代码:
```cpp
#include<bits/stdc++.h>
#define int long long
using namespace std;
int n,m,ans;
const int MOD = 1e9+7;
int p[1000005],h[1000005];
string s,t;
int id(char c){
if(c>='A' && c<='Z'){
return c-'A'+1;
}
return c-'a'+27;
}
int Hash(int l,int r){
return (h[r]-h[l-1]*p[r-l+1]%MOD+MOD)%MOD;
}
signed main(){
ios::sync_with_stdio(0);
cin.tie(0);
cout.tie(0);
cin >> s >> t;
n = s.size(),m = t.size();
p[0] = 1;
for(int i=1;i<=n;i++){
p[i] = p[i-1]*53%MOD;
h[i] = (h[i-1]*53+id(s[i-1]))%MOD;
}
int hasht = 0;
for(int i=1;i<=m;i++){
hasht = (hasht*53+id(t[i-1]))%MOD;
}
for(int i=1;i+m-1<=n;i++){
if(Hash(i,i+m-1)==hasht){
ans++;
}
}
cout << ans;
return 0;
}
```
自然溢出同理,就不演示了。
# KMP 算法
KMP(Knuth–Morris–Pratt) 算法可以在 $O(\lvert S \rvert+\lvert T \rvert)$ 的时间复杂度内找到模式串 $S$ 在文本串 $T$ 的所有出现位置。
## 暴力算法
首先考虑暴力算法,显然对于每一个 $i \le m-n+1$,暴力匹配即可。
但是这样做复杂度是 $O(nm)$ 的,考虑优化。
## 优化
对于每一次匹配,如果失配,我们会将字符串往后挪,希望失配的位置能够匹配,且前面的位置也能匹配。
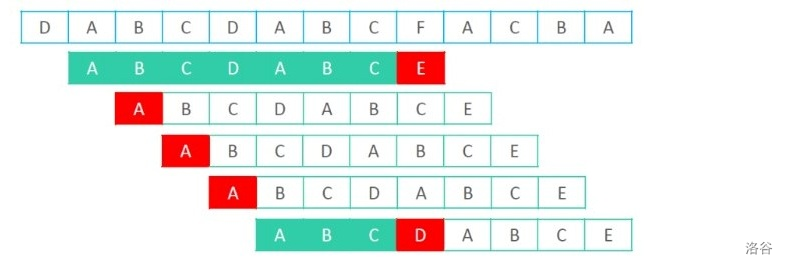
上图是暴力算法的匹配过程,显然中间有许多匹配是不可能匹配成功的,考虑每次挪动字符串不一个位置一个位置的挪,而是挪动多个位置。
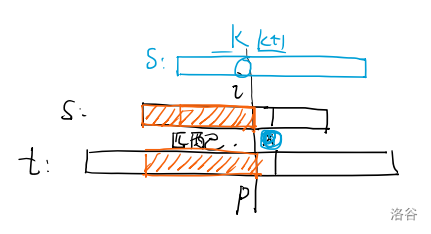
如图,假设 $T$ 在 $p$ 位置上匹配了 $S$ 长为 $i$ 的前缀,但在 $T_{p+1}$ 的位置失配,即 $T_{p+1} \ne S_{i+1}$,现在我们希望能匹配上 $T_{p+1}$。
此时我们想要找到最大的 $j$,使得 $sub(T,1,p+1)$ 的后缀能成功匹配 $sub(S,1,j)$,即 $sub(T,p-j+1,p+1)=sub(S,1,j+1)$,也就是 $sub(T,p-j,p)=sub(S,1,j)$。又因为刚才已经匹配上了 $S$ 长为 $i$ 的前缀,所以 $sub(T,p-j,p)=sub(S,i-j+1,i)$,即 $sub(S,1,j)=sub(S,i-j+1,i)$。
我们把这个最大的 $j$ 定义为 $nxt_i$,这就是 KMP 算法的核心——$nxt$ 数组(又称 $border$,$kmp$ 数组,前缀函数,$\pi$ 数组)。
根据上面的推理,字符串 $S$ 的 $nxt_i$ 表示 $\forall j \le i,sub(S,1,j)=sub(S,i-j+1,i)$ 中最大的 $j$,也就是 $S$ 的长度为 $i$ 的前缀中,真前缀和真后缀相同的最大长度。特别的,$nxt_1=0$,若不存在 $j$,则 $nxt_i=0$。
设 $\lvert S \rvert=n$,$\lvert T \rvert=m$。
因此每次我们失配时,把模式串 $S$ 的结尾 $now$ 移到 $nxt_{now}$ 即可。
## 计算 $nxt$ 数组
问题来了,如何计算 $nxt$ 数组呢?可以理解为 $S$ 和自己匹配。
考虑递推计算。假设已经计算好了 $nxt_{1 \sim i-1}$,要计算 $nxt_i$。
一步一步来看。
显然 $nxt_i$ 的可能最大值是 $nxt_{i-1}+1$,然而不一定能取的到,所以进行分讨。
若 $S_i = S_{nxt_{i-1}+1}$,那 $nxt_i$ 就可以取到 $nxt_{i-1}+1$。
若 $S_i \ne S_{nxt_{i-1}+1}$,则有 $nxt_i \le nxt_{i-1}$。那我们就只能把 $S$ 往后移动一些位置,如图。
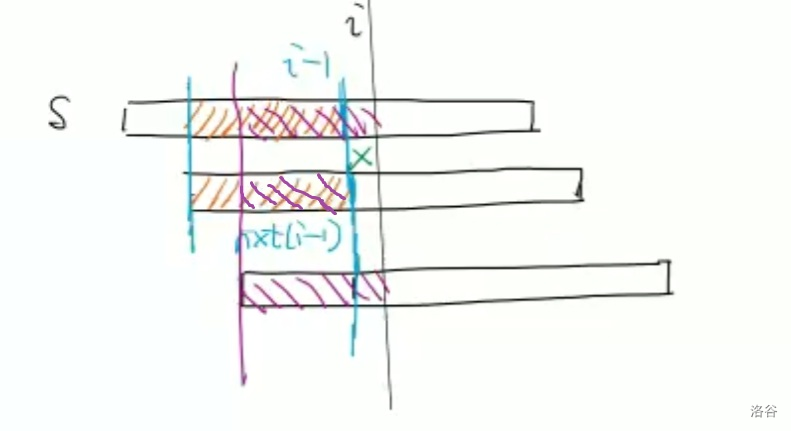
在最开始的时候,准备进行匹配的位置是黄色部分,但是在 $i=nxt_{i-1}+1$ 的位置匹配失败。将 $S$ 向后移动一些位置后,匹配成功。此时不仅新的 $S$ 和最初的 $S$ 的那一段匹配成功,还和移动之前的 $S$ 的那一段匹配成功。所以 $nxt_i=nxt_{nxt_{i-1}}+1$。
以此类推,$S \in nxt_{i-1}+1,nxt_{nxt_{i-1}}+1,nxt_{nxt_{nxt_{i-1}}}+1,\ldots,0$。在匹配成功时取最大值。
因此要找到最大的 $j < nxt_{i-1}$,使得 $sub(S,1,i)$ 也就是 $sub(S,1,nxt_{i-1})$ 的后缀与 $sub(S,1,k)$ 匹配。
## 参考代码
给出 [P3375 【模板】KMP](https://www.luogu.com.cn/problem/P3375) 的代码。
```cpp
#include<bits/stdc++.h>
#define endl '\n'
using namespace std;
string s,t;
int nxt[1000005];
int main(){
ios::sync_with_stdio(0);
cin.tie(0);
cout.tie(0);
cin >> s >> t;
int n = s.size(),m = t.size();
s = " "+s;
t = " "+t;
int now = 0;
for(int i=2;i<=m;i++){
while(now>0 && t[i]!=t[now+1]){
now = nxt[now];
}
if(t[i]==t[now+1]){
now++;
}
nxt[i] = now;
}
now = 0;
for(int i=1;i<=n;i++){
while(now>0 && s[i]!=t[now+1]){
now = nxt[now];
}
if(s[i]==t[now+1]){
now++;
}
if(now==m){
cout << i-m+1 << endl;
now = nxt[now];
}
}
for(int i=1;i<=m;i++){
cout << nxt[i] << " ";
}
return 0;
}
```
## 复杂度证明
时间复杂度为 $O(\lvert S \rvert+\lvert T \rvert)$。
因为 $nxt_i$ 每次至多增大 $1$,所以 $now$ 每次循环中至多跳 $1$ 次,也就是 `while` 循环在两次循环中最多总共执行 $\lvert S \rvert+\lvert T \rvert$ 次。
# Z 算法(exKMP)
# Manacher
# AC 自动机