【2026 联赛前重置版】顺着风的方向:近年 CSP-S2 & NOIP 补题笔记
JuRuoOIer
·
2026-11-04 10:46:24
·
算法·理论
顺着风的方向。
说明
浏览次数:
仅使用 GenAI 进行了查错及部分题目的简要题意整理。有几处直接引用题解区的内容均已在引用处作说明。
可能会 typo 或者脑抽犯错。如果您发现了任何问题,或者有我没能讲明白的地方,欢迎通过 B 站、洛谷或者 QQ(群 616057779 )撅我。
为了和游记、迷行赏等错峰,在今年 S2 及 NOIP 后本文应该不会立刻更新,而会等一段时间,请勿催促由于新版考前未能完成审核,考后将与 S2 26 一并更新。此外说到迷行赏,笔者非常菜所以已经要退役了,大抵是更不了了。希望山东能有其他的后起之秀能接下这一重任。画饼:《我循信风而行》。我也不知道我退役前能不能做完了。
本次送审更新
2/11/2026:找我的一位朋友更新了 CSP-S2 2026 的题目。主播太菜,高二了还是没有 WC 打。
28/10/2026:彻底人工重读本文并利用免费的 GPT,修复了大量细节,优化了很多表述问题,重置了部分当时理解不够透彻的题目的讲解。此外,重置了排版,加入了题意简述,并更新了关于今年试题的讨论。
:::info[本次问题修复内容]
S2 19 D2A:最后的方程有误。
S2 19 D2C:在推式子时默认了 x 在 k 子树内。
NOIP 20 B:复杂度中带常数。
NOIP 21 C:对 d_k 求和的下标有误。
S2 22 B:漏判了区间中存在 A_i=0 的情况。
NOIP 22 C:对 g_y 的贡献处有误。
NOIP 22 D:口胡的 52 分做法是假的。
NOIST 23 B:结论缺少限制条件。
NOIST 23 D:第一个转移方程有误。
S2 23 D:复杂度有误。
:::info[历史更新日志]
30/12/2025:在参加 M***C*** 的过程中发现的问题:
修复了 CSP-S2 2021 T2 中不恰当的表述。
补全了 CSP-S2 2021 T4 中的知识点(统计部分是正确的,不影响)。
修正了 NOIP 2021 T2 中的知识点(统计部分是正确的,不影响)。
修正了 NOIP 2021 T3 中推式子部分不恰当的表述。
根据 eteste 结果,本文当前共 24000 汉字,不含标点。
14/12/2025:复训并写完了山东省 NOIP 迷惑行为大赏。来补这里。
更新了 NOIP 2025 的个人题解。时间原因 T4 只写一种做法(虽说视频里也只简单提及了三种)。
更新了含有 2025 年赛事的考频统计和考点趋势折线图。
更新了一个考场上判断题目难度的技巧。
删除了由于写作时间跨度太大导致标准十分不统一的锐评难度。
注意到某个卷王已经过掉了历年 NOIP 几乎所有题,所以恢复之前删去的题目筛选及分类信息。
12/11/2025:提前发布了本文 NOIP 前的终版。如不出现较大锅 NOIP2025 前将不再更新。
更新了 CSP-S2 2019 和题解及涉及的好题推荐。
更新了押题部分的相关信息。
再次回复@快速数论变换 的建议:为了方便大家做题只管把两道出题人想考高精度但 __int128 可过题(2019 和 2020 各一道)标注一下吧。
回复忘了是谁了(ta 已经删评了)关于我个人对 CSP-S2 2025 难度评价的评论:私以为在这种地方难度还是有必要考虑一下客观现实。CSP-S2 2025 的难度横向对比往年 CSP-S2 确实处于中等,对比往年 NOIP(不过 NOIP 确实较难)确实较简单,且思维链上大部分的点(也在题解里说明了)都很大程度上有迹可循。不过作者的水平确实不高,本文的风格中也有一定体现(洛谷的高水平选手题解通常 习惯使用大量公式代替语言表达),所以作者远需努力。
借楼宣传今年的山东省 CSP-S2 迷惑行为大赏。
借楼预告今年的山东省 NOIP 迷惑行为大赏。
4/11/2025:
更新了春季测试 2023 的题解及涉及的好题推荐。
回复@快速数论变换 的建议:双下划线开头的内容 21 年起才允许使用,秉承尊重历史、尊重出题人的原则不做修改。
2/11/2025:进行如下更新(不分顺序)。
更新了 CSP-S2 2025 的题解及涉及的统计信息和好题推荐。
根据@ljw0102 的建议,更正了 CSP-S2 2022 B 的知识点。
根据@Tiffake 的建议,更正了 NOIP2024 D 中的 typo,并补上了算法和难度锐评。
根据@_O_vO 的建议,更正了 CSP-S2 中首次卡掉 \log 的时间。
更新了押题的部分,不过为了防止组题人看到相关内容,本文在考前最后一周会再更一版,为了防止届时审核审不出来可以预先收藏。我们在 S2 2025 中作出了确实有用的预言,所以玩原神对 OI 确有帮助。
借楼预告今年的山东省迷惑行为大赏已经换新链接了,在 12/11/2025 版更新内容里。
31/10/2025:最后三道题也更完了,至此 2020 到 2024 年除送分题和大模拟外的所有联赛题都可以在本文找到。
30/10/2025:更新了 NOIP 2024 的题解。
29/10/2025:更新了考频分布和推荐题单,并投稿洛谷全站推荐。
26/10/2025:完成了 CSP-S2 2024 和 NOIP 2023 二三题的文字题解。
19/10/2025:重整了这篇博客,删掉了所有的代码。不贴代码了,再贴我破机器打不开编辑界面了。
做这个东西的灵感主要来自枫原万叶的起飞语音“顺着风的方向”及各 whk 教辅的考频统计。这篇文章的主要目的:
把真题用像我这种彩笔能理解的方法讲一下,同时敦促我自己补题。
期望能从试题的变化趋势中发掘出额外的价值。不过只是个实验,还是先观望吧,毕竟每年出题人都不一样。
前言
:::info[知识点考频及分布]
按照板块分类统计了题数,且除 入门组大纲内且不是题目核心考察内容的知识点 外没有其他可分入板块的知识点的(例如纯思维题),由于难以界定是否是思维题,一律归类为其他算法。板块之间不排序。
数据结构:11 次,共 9 题。
CSP-S2 2020 D(单调队列)
CSP-S2 2021 A(堆)
NOIP 2021 D(线段树,并查集)
CSP-S2 2022 B(多种高级数据结构选一)
NOIP 2022 D(线段树)
NOIP 2023 B(并查集)
NOIP 2023 D(线段树优化 DP)
NOIP 2024 D(线段树)
CSP-S2 2025 C(二维数点)
NOIP 2025 C(线段树优化 DP)
NOIP 2025 D(ST 表,单调队列)
数学:5 次,共 4.5 题。
NOIP 2020 D(拉格朗日插值)
NOIP 2021 A(筛法)
NOIP 2021 C(推式子)
NOIP 2022 A(加法原理,乘法原理)
NOIP 2024 B(加法原理,乘法原理)
动态规划:12 次,共 9.5 题。
CSP-S2 2021 B(区间 DP)
CSP-S2 2021 D(区间 DP)
NOIP 2021 B(数位 DP)
NOIP 2021 C(普通多维 DP,滚动数组)
CSP-S2 2022 D(树形 DP)
NOIP 2022 C(树形 DP)
NOIP 2023 D(线段树优化 DP)
CSP-S2 2024 C(普通多维 DP)
NOIP 2024 C(树形 DP)
CSP-S2 2025 D(普通多维 DP)
NOIP 2025 B(普通多维 DP)
NOIP 2025 C(线段树优化 DP,树形 DP)
图论:5 次,共 3.5 题。
CSP-S2 2020 C(拓扑排序)
NOIP 2020 A(拓扑排序)
CSP-S2 2021 D(最短路)
NOIP 2022 C(缩点)
CSP-S2 2025 B(最小生成树)
字符串:4 次,共 3.5 题。
NOIP 2020 B(扩展 KMP)
CSP-S2 2022 C(集合哈希)
CSP-S2 2023 B(进制哈希)
CSP-S2 2025 C(进制哈希,trie)
其他算法:19 次,共 18 题。
CSP-S2 2022 A(Meet-in-the-middle)
CSP-S2 2020 A(模拟)
CSP-S2 2020 B(位运算)
CSP-S2 2020 D(贪心)
NOIP 2020 A(高精度)
NOIP 2020 C(分治)
CSP-S2 2021 C(贪心)
NOIP 2022 B(模拟)
CSP-S2 2023 A(枚举)
CSP-S2 2023 C(模拟)
CSP-S2 2023 D(二分,贪心)
NOIP 2023 A(贪心)
NOIP 2023 C(贪心)
CSP-S2 2024 A(贪心)
CSP-S2 2024 B(二分,贪心)
CSP-S2 2024 D(若干基础算法)
NOIP 2024 A(贪心)
CSP-S2 2025 A(贪心)
得到统计图:
在 NOIP2025 之后,今年联赛的讨论热点主要是来自难度(以及 sale 和 dapingguo8)。事实上,这个并不能说得准,因为从洛谷难度来看,省选题的难度从 23 年一上去就没下来;但如果参考物理联赛近四年的试题难度走向(连续两年升高后今年回落),那降难度也不是全无希望的,所以没必要为这种无法预测的事情慌。
笔者认为,保持稳定良好的心态,无论题的难易都能有从容的应对策略,最终打下自己有能力打到的所有分、不留下什么遗憾,就已经是一场完满的比赛了。我们现在在这里分析试题,但身处考场时,仍应相信过去的任何数据都只属于过去,对手的荣光也只能留在往昔。追忆过去的目的是带着回忆向前,而不是无限沉缅于过往。
一定要有这种向上的、积极的心态。
:::align{right}
——张雪峰
:::
我不会再猜题目了,因为真的只能瞎猜 。
以前猜题这种事只是我不能干,因为我是典型的低天赋低水平且社交能力极差选手,无法进入高水平选手圈层,也就没有可能得知可能的出题人及他们的出题偏好、研究方向、近期动态等——而这些显然是科学的命题预测工作(如你们学校的中高考命题预测)所必需的。但这至少意味着有很多人(甚至很可能是现在或者未来的你)有条件完成比较准确的预测。
而我刚才说的却是,只能瞎猜 。你可以综合以下材料分析一下我这么说的原因。
材料一 你会发现今年 S2 没有计数题(T3 并不能算作计数题),而计数显然是热门考点。
材料二 @Zheng_iii 大神考前让 astra 进行了押题,结果是:
所以大家考前几天的时候可以问问 astra 会考什么;有富哥愿意的话也可以告诉我你获得的答案,thank you in advance。
::::info[NOIP 2025 前版]
在 CSP-S2 2025 前,我们猜中了:
会考图论算法 。会考线段树。
会考贪心。(这不是废话吗怎么可能不考)会考 DP。(这不也是废话吗怎么可能不考)
:::info[CSP-S2 2025 前版]
发现:
无知识点及 DP 的比重加大可以看出思维越来越重要。
左图中配合表显而易见的是 21 年开始 DP 和线段树年年都在考 ,而贡献了基础算法绝大部分题的贪心 同样十分重要。
另外就是图论算法好像两年没碰过了,今年……算了不说了自己悟吧。
::::
CSP-S2 2019
D1B - P5658 [CSP-S2019] 括号树
:::info[统计知识点]
给定 n 个点的树,以 1 为根。每个点上有一个 ( 或者 ),对于每个点,求从根到其的路径上的所有括号连起来形成的字符串中,有多少个不同的子串是合法括号串。
数据范围:n\le 5\times 10^5 。
:::success[做法]
括号匹配题,求的还是子串个数,和 S2 2023 消消乐颇像。
设现在有 cnt 层左括号未匹配,沿用消消乐的思路我们可以在遍历整棵树的过程中对每个 0\le i\le n 维护出 cnt=i 的情况数,然后就做完了。
但是有点问题,这个题是分左右括号的,消消乐没区分。所以当 cnt<k 时,cnt=k 的情况数应该清零,所以维护的时候改用栈。栈底要保持有一个元素记录 cnt=0 即当前已经完全匹配的情况。
然后空间不允许栈开在函数里,所以把栈开在全局,回溯的时候一定要考虑好下一个位置到底对栈做了什么修改。
下一个是左括号:只会向栈中插入 0 ,所以删除栈顶即可恢复。
下一个是右括号:分大小是否为 1 考虑。
栈大小为 1 时:只会导致栈底值清零,向下递归前记录栈底值然后替换回来即可。
栈大小超过 1 时:会导致顶层被删除且下一层被减一,记录最上面两层的值即可。
D1C - P5659 [CSP-S 2019] 树上的数
:::info[统计知识点]
给定一棵 n 个点的树,其各点权形成一个 [1,n] 的排列。每次操作需要删除一条边并交换该边两端点的点权。求在删完所有边后,将各点按点权从小到大排列的字典序最小是多少。
数据范围:多测,T\le 10,n\le 2000 。
:::success[做法]
对脑电波大获全胜,思考时长不到 1.5 小时。
由于要的是最小的字典序,肯定先保小的数字。对于一个数字,贪心地找到其能到达的最小的点即可。
但是路径之间可能会冲突,所以要确保数字能真的到达目标点,就要求:
起始边必须是起点删掉的第一条边,确保要移动的数字在起点上;
每个途径点删掉的两条边删除顺序必须连续,确保要移动的数字按照希望的路径走;
结束边必须是终点删掉的最后一条边,确保数字移动过去之后不要再被移走。
所以我们需要为各个边安排合理的删除顺序以确保每个路径正常移动。根据刚才的要求,
起始边要放到起始点删边顺序的最前面;
途经点需要插入连续两条边;
结束边要放到终点删边顺序的最后面。
插入操作不难用链表维护。对每个数字初始所在的点为根扫整棵树,判断每个点能否作为途经点及能否作为终点即可。复杂度 O(n^2) 。
根据题解区,也可以不用链表而是对于每个点建图,把原图的边建成新图的点,然后可以用并查集维护相关信息,这样更加直观。复杂度根据并查集优化程度 O(n^2\alpha(n)) 到 O(n^2\log n) 不等。
D2A - P5664 [CSP-S 2019] Emiya 家今天的饭
:::info[统计知识点]
有 n 种烹饪方法和 m 种食材,第 i 种烹饪方法用第 j 种食材可以做出 a_{i,j} 个不同的菜。求有多少种做若干个菜的方案,满足:
至少做一个菜;
每种食材至多用来做一半的菜;
每种烹饪方法至多用来做一个菜。
数据范围:n\le 100,m\le 2000 。
:::success[做法]
感觉 99.9\% 的人做过,我是那 0.1\% 。
首先在 CSP-S2 2025 的毒打后我们看到一个东西限制选一半就知道至多爆一个。
不难想到枚举爆掉的食材,此时设 dp_{i,j,k} 表示前 i 个烹饪方式中总共选了 j 次食材,我们枚举的那个(设为 x )被选了 k 次。这样不 贡献答案的状态就是 k>\lfloor\frac{j}{2}\rfloor 的情况。转移直接从上一列分类讨论一下就行:
不选:dp_{i-1,j,k}\to dp_{i,j,k} ;
选但没选到 x :dp_{i-1,j-1,k}\cdot\left({\displaystyle\sum_{l\in[1,m],l\neq x}a_{i,l}}\right)\to dp_{i,j,k} ;
选到 x :dp_{i-1,j-1,k-1}\cdot a_{i,x}\to dp_{i,j,k} 。
每种烹饪方式的和显然可以预处理。
至于为什么上述过程只能求不符合要求的情况,因为我们只能确定 x 是否爆了,没管其他的是否爆了。
所以还得拿总数减。当然这个对连刚才的过程都能理解的你来说就很容易了,设 g_{i,j} 表示前 i 种烹饪方法做了 j 个菜的方案数,讨论当前这个方法做没做菜即可。
然后我们获得了一个复杂度 O(mn^3) 的优秀算法,可惜过不去。
如果你顺着读我的题解你会发现前面那玩意就很有病:是怎么能做到直接发现设计 dp 数组是用来求不符合条件的情况的?
当然原因我也解释了:在方程推完之后我们知道它没法正向求。
那既然不能正向求,有没有什么更加省事的方法呢?
有的,兄弟,有的。
我们只在乎 k 与 \lfloor\frac{j}{2}\rfloor 的关系,而不在乎它们的具体数值。
然后有无数种办法搞个式子把后两维状态合并成一个能表示上述两者关系的状态。比如 2k-j 。于是如果我选到 x 上这一维就加 1 否则就减 1 。转移方程和上面本质其实是一样的:
dp_{i,j}=dp_{i-1,j}+dp_{i-1,j+1}\cdot\left({\displaystyle\sum_{l\in[1,m]\setminus x}a_{i,l}}\right)+dp_{i-1,j-1}\cdot a_{i,x}
D2B - P5665 [CSP-S 2019] 划分
:::info[统计知识点]
给定长为 n 的数组 a ,定义一种将之划分为若干非空段的方式是合法的,当且仅当其每段中 a_i 的和均不小于上一段,此时该方案的代价是各段 a_i 之和的平方相加。求最小代价。
数据范围:n\le 4\times 10^7 。
:::success[做法]
考虑暴力 DP,设 dp_{i,j} 表示枚举到 i 最后一次断掉了 j 的答案。暴力转移枚举 j 的上一个断点 k ,复杂度 O(n^3) 。
观察枚举的过程,发现在 j 变大时 k 能取的范围的左右端点显然均不会往左。于是用单调队列维护可以实现复用信息,复杂度 O(n^2) 。
类似于后文中某题(由于编写顺序原因这场是最后加上去的所以前文引用后文),DP 优化不动时有必要考虑贪心。
由于本题中 a_i\ge 1 ,所以有 (a_i+a_j)^2=a_i^2+a_j^2+2a_ia_j>a_i^2+a_j^2 ,即能不合并就别合并。所以最后一段应该尽可能小一点,而由于终点固定,其实就是让这段区间短一点。
于是根据刚才得出的 k 的右端点的单调性我们不再枚举 j ,只枚举 i 并找到最大的合法的 j ,这仍然可以单调队列。
手写高精度的话有些卡常可以试着压位(两个 long long 就搞定了),不过我们是现代人,他总的答案不超过 (\sum a_i)^2\le 1.6\times10^{33} ,根据公式 2^{10}\approx10^3 估算知道可以 __int128。
D2C - P5666 [CSP-S 2019] 树的重心
:::info[统计知识点]
给定一棵 n 个点的树,求其单独删掉每条边后,所得两个子树的重心编号和之和。有两个重心的都算入答案。
数据范围:多测,T\le 5,n\le 3\times 10^5 。
:::success[做法]
采用@xht 大佬的做法,简单解释了一下式子,方便和我一样不熟悉树的重心的选手理解。
首先将原式视为统计各点做重心次数的和。
根据 OI-Wiki,树的重心具有如下性质。
树的重心如果不唯一,则恰有两个。这两个重心相邻。而且,删去它们的连边后,树将变为两个大小相同的连通分量。
在一棵树上添加或删除一个叶子,那么它的重心最多只移动一条边的距离。
把两棵树通过一条边相连得到一棵新的树,那么新树的重心在连接原来两棵树的重心的路径上。
一棵有根树的重心一定在根结点所在的重链上。一棵树的重心一定是该树根结点重子结点对应子树的重心的祖先。
因为树上两点间路径唯一,删掉一条边后形成的两棵子树间路径必然经过这条边,根据上述第三条,我们取树的一个重心为根,则首先除根外一个点做重心时删掉的边必然不是其子树内的边 。
设 sz_i 表示 i 的子树大小,并预处理出每个点的重儿子 son_i 。考虑使 x 成为重心,若删掉边 (k,fa_k) ,设 sz 表示包含 x 的连通分量的大小,此时根据重心的定义 x 外的部分及 x 的重儿子均不能超过 \lfloor\frac{sz}{2}\rfloor ,即 2(sz-sz_x)\le sz 且 2sz_{son_x}\le sz ,去括号并移项得 2sz_{son_x}\le sz\le 2sz_x 。
所以我们需要求出不在 x 子树内(不含 x )的满足上述式子的 k 的数量。式子就是个单点加区间求和,随便搞个 ds 维护一下,跑两遍 dfs 即可。子树内点数这块,在第一遍 dfs(往 ds 上挂点信息)时,进子树的时候查询一遍式子,出子树的时候再查询一遍式子,减一下就是子树内符合条件的点数。
然后考虑根节点做重心的问题。这个时候可能把 son_{rt} 里的边割掉了,此时由糖水不等式(\frac{a}{b}<\frac{a+c}{b+c}(0\le a<b,0<c) )有 \dfrac{sz_{son_{rt}}-a}{sz_{rt}-a}<\dfrac{sz_{son_{rt}}}{sz_{rt}} ,所以 son_{rt} 必然合法,所以只需要看根节点次大的儿子是否合法即可;割掉其他边时则还是看最大的儿子是否合法。dfs 时顺便维护即可。
CSP-S2 2020
题目难度不大,写完难度巨大。好在大样例蛮强的,要不然至少考场上我儒略日是肯定要 0pts 了。
A - P7075 [CSP-S2020] 儒略日
:::info[统计知识点]
1. 公元 1582 年 10 月 15 日(含)以后:适用格里高利历,每年一月 $31$ 天、 二月 $28$ 天或 $29$ 天、三月 $31$ 天、四月 $30$ 天、五月 $31$ 天、六月 $30$ 天、七月 $31$ 天、八月 $31$ 天、九月 $30$ 天、十月 $31$ 天、十一月 $30$ 天、十二月 $31$ 天。其中,闰年的二月为 $29$ 天,平年为 $28$ 天。当年份是 $400$ 的倍数,或日期年份是 $4$ 的倍数但不是 $100$ 的倍数时,该年为闰年。
2. 公元 1582 年 10 月 5 日(含)至 10 月 14 日(含):不存在,这些日期被删除,该年 10 月 4 日之后为 10 月 15 日。
3. 公元 1582 年 10 月 4 日(含)以前:适用儒略历,每月天数与格里高利历相同,但只要年份是 $4$ 的倍数就是闰年。
4. 尽管儒略历于公元前 45 年才开始实行,且初期经过若干次调整,但今天人类习惯于按照儒略历最终的规则反推一切 1582 年 10 月 4 日之前的时间。注意,**公元零年并不存在**,即公元前 1 年的下一年是公元 1 年。因此公元前 1 年、前 5 年、前 9 年、前 13 年……以此类推的年份应视为闰年。
数据范围:$q\le 10^5$,公历年份不超过 $10^9$。
:::success[做法]
由于数据范围很大,所以我们要尽可能地划分周期以加速。下面列出一年以上的周期。
- 对于儒略历:只有 $4$ 年周期,一周期 $365\times4+1=1461$ 天。
- 对于格里高利历:需要 $400$ 年、$100$ 年和 $4$ 年三种周期,分别为 $146097$ 天、$36524$ 天和 $1461$ 天。
这样一周期不超过一年,可以直接模拟。
注意除最大的周期可以直接取模外,其他周期的出现次数不能大于或者等于更大的周期的年数除以该周期年数的商(例如 $100$ 年周期最多只计算 $400\div 100-1=3$ 次)。
:::
## B - P7076 [CSP-S2020] 动物园
:::info[统计知识点]
- 其他算法 - 位运算
:::
共有 $2^k$ 种动物,编号为 $0\sim2^k-1$,其中动物园已经有 $n$ 种,第 $i$ 种编号为 $a_i$。共有 $m$ 条限制,第 $j$ 条形如“若存在二进制第 $p_j$ 位为 $1$ 的动物,则必须购买第 $q_j\in [1,c]$ 种饲料”。求在所需饲料集合不变的情况下,还能再养多少种动物。
数据范围:$n,m\le 10^6,k\le 64,c\le 10^8$。
:::success[做法]
显然如果知道了需要购买的饲料能养的编号最大的动物的编号中有 $k$ 个 $1$,则能养的动物种类总数是 $2^k$,然后减掉已经养了的即可。
购买饲料时显然按照所有动物的或和购买,记录购买的集合后对于每一个二进制位枚举其是否需要饲料即可,不需要饲料的位同样或入或和中。
记得开 `__int128`。
:::
## C - P7077 [CSP-S2020] 函数调用
:::info[统计知识点]
- 图论 - 拓扑排序
:::
给定一个长为 $n$ 的数组 $a$ 和 $m$ 个函数。第 $j$ 个函数是以下三种之一:
1. 将 $a_{P_j}$ 增加 $V_j$;
2. 将所有元素乘 $V_j$;
3. 依次执行函数 $g_{j,1},g_{j,2},\dots,g_{j,C_j}$,保证不会出现递归。
$q$ 次操作,每次调用一个函数,求操作完后的 $a$ 数组。
数据范围:$\sum C_j\le 10^6$。
:::success[做法]
被蓝题击毙了。
操作类题目的思路基本上是固定的:先不考虑其中一部分操作看能不能做,再加上被忽略的部分。
然后我们发现:
- 没有一操作显然直接处理出每个操作乘多少即可。
- 没有二操作,此时由于一操作不能像二操作一样合并进行,所以不能沿用没有一操作的方法;但是我们发现一操作之间的顺序是任意的,所以我们可以计算每个一操作调用了多少次。由于函数调用不会递归,即调用过程自身形成一个 DAG,这个过程是可以直接拓扑排序后遍历解决的。
- 没有三操作,此时对于一个一操作,我们可以求出其之前进行的二操作乘的总数 $k$,然后将该操作的数字除以 $k$ 加到原始数据上,这样可以将一操作和二操作分离处理。
因为没有一操作后三操作变得没有意义而导致难以增强为原问题,所以我们忽略这种情况,只考虑后两者。遂发现后两者是可以合并的:在没有二操作时,我们可以计算每个一操作调用了多少次,而考虑进二操作之后我们参考没有三操作的做法,可以知道每个函数在调用之前一共乘的数 $k$,从而知道涉及每个一操作应该计算 $k^{-1}$ 次,然后就做完了。
但是,上述思路只是思考过程中比较自然的想法,劝大家写的时候按函数执行的顺序倒着跑,即加法操作的次数不按上一句说的使用调用之前乘的数的逆元、计算答案时先加后乘,而是使用调用之后乘的数、计算答案时先乘后加,否则处理乘 $0$ 相当麻烦。别问我怎么知道的,问就是我写了一遍正着跑的然后发现可能乘 $0$……
:::
## D - P7078 [CSP-S2020] 贪吃蛇
:::info[统计知识点]
- 其他算法
:::
共有 $n$ 条蛇,第 $i$ 条体力为 $a_i$。认为第 $i$ 条蛇比第 $j$ 条强,当且仅当 $a_i>a_j$,或者 $a_i=a_j$ 且 $i>j$。
每次场上最强的蛇可以选择:
- 吃掉最弱的蛇,自身体力减少被吃的蛇的体力;
- 结束整个战斗。
若所有蛇都采取最优策略,求剩下的蛇的个数。
数据范围:多测,$T\le 10,n\le 10^6$。
:::success[做法]
这题是有里程碑意义的:因为它标志着 CCF 能卡 $\log$ 了。
虽说是黑题,但是本身想到做法的难度不大(~~虽然主要是靠猜但是并不难猜,我找了两个分别退役两年半、三年的 whk 选手都猜出来了 ww~~),重点在如何落实边界情况,这在 OI 赛制的考场上同样是有区分度的,~~要是是我很可能就被区分了~~。
首先对着小样例开始猜,随便猜几个(比如我是第二次猜到的)发现猜到“当大的吃小的后不会变为最小的就吃”的时候发现能过样例,于是大胆假设它是对的并试图证明。然后我们发现证明是容易的:
- 假设所有的蛇从小到大是 $a_1,a_2,\dots,a_n$。
- 最大的吃完最小的后不会变成最小的,即 $a_n-a_1\ge a_2$,此时如果 $2$ 被 $n-1$ 吃(若还是被 $n$ 吃且吃完后 $n$ 不是最小的则可以将前两个视为一个,所以不需要额外考虑),则由于 $a_{n-1}\le a_n$ 而 $a_1\le a_2$ 根据不等式的同向可加性有 $a_{n-1}-a{2}\le a_n-a_1$,故 $n$ 将在下次吃之前永远不会变为最小的。
但这并不是能吃的唯一情况。我们刚才显然是没有考虑“吃了之后会变成最小的”的情况的。这种情况一定不能吃吗?
答案是否定的。我们考虑如果吃了之后会变成最小的,则下一条蛇有两种可能:
- 如果吃了不会变成最小的,或者只剩两条蛇,此时根据刚才“当大的吃小的后不会变为最小的就吃”的结论可以放心吃,此时当前的蛇则因此不敢再吃了。
- 否则,问题递归下去,由于上一种情况中有“只剩两条蛇”的条件,所以递归一定有终点。此时当前蛇根据终点与当前蛇之间的蛇数量的奇偶性来决定是否吃:如果是奇数则可以,因为下一条蛇不敢再吃一次;如果是偶数则不行,因为下一条蛇可以吃。
直接用 `set` 之类的东西存一下可以做到一个 $\log$,理论上只有 $70$ 分(实际能卡过)。
但是题中为我们排好序了,所以我们可以直接维护一个双端队列用来存蛇,根据刚才证明“当大的吃小的后不会变为最小的就吃”性质的过程,每次吃完后的蛇的大小是单调递减的,故我们可以再维护一个双端队列用来存吃之后的蛇,每次从两个队列尾部取最大值,头部取最小值,然后到最后一次单独扫一遍判断一下即可实现 $O(n)$。
:::
# NOIP 2020
## A - P7113 [NOIP2020] 排水系统
:::info[统计知识点]
- 图论 - 拓扑排序
:::
给定一张 $n$ 个点的 DAG,其中 $m$ 个入度为 $0$ 的点均获得 $1$ 吨污水,污水遇到分叉时会平均分到各个分叉,求所有出度为 $0$ 的点最终有多少污水。
数据范围:$n\le 10^5,m\le 10$,所有点出度不超过 $5$。
:::success[做法]
题目中保证图为一 DAG,然后该题即为拓扑排序板子,这里不再赘述。
本题需要高精度。
:::
## B - P7114 [NOIP2020] 字符串匹配
:::info[统计知识点]
- 字符串 - 扩展 KMP 算法(Z 函数)
:::
给定字符串 $s$,求将 $s$ 拆成形如 $\overline{ABAB\dots ABC}$,其中 $A,B,C$ 均非空,且 $A$ 中出现奇数次的字符数量不超过 $C$ 中出现奇数次的字符数量的方案数。
数据范围:多测,$T\le 5,|s|\le 2^{20}$。
:::success[做法]
设原串为 $s$,下标从 $0$ 开始。
先考虑一个弱化版的问题:如果不考虑 $A$ 中出现奇数次的字符数不超过 $C$ 中出现奇数次的字符数这个条件,我们该如何求解。
这个东西是容易的,我们先将字符串各位置的 $z$ 函数求出来,然后枚举循环节长度。
我们发现,枚举的循环节长度为 $i$ 时,原式中 $AB$ 的循环次数 $k$ 有 $\left\lfloor\dfrac{z_i}{i}\right\rfloor+1$ 个取值,因为 $s[0,z_i-1]=s[i,i+z_i-1]\Rightarrow s[0,i-1]=s[i,2i-1]=\dots=s\left[\left\lfloor\dfrac{z_i}{i}\right\rfloor\cdot i,\left(\left\lfloor\dfrac{z_i}{i}\right\rfloor+1\right)\cdot i-1\right]$,如果不懂上面的证明可以自行画图理解(或者直接去看[第一篇题解](https://www.luogu.com.cn/article/bti82yh8)的图)。
然后我们考虑刚才忽略的限制。这里我们仍设字符串 $AB$ 的循环次数为 $k$。根据限制内容,不难想到下述 $k$ 是偶数的部分,遂按照 $k$ 的奇偶性讨论:
- 对于 $k$ 是偶数的情况,所有 $AB$ 中涉及到的字符均在 $(AB)^k$ 中出现了偶数次,这对 $C$ 中各字符的奇偶性显然是没有影响的,所以定义域内无论 $k$ 取何值 $C$ 中出现奇数次的字符数量和 $f(s)$ 相等;
- 对于 $k$ 是奇数的情况,类比偶数的情况,因为奇数可以表示为 $2n+1$ 的形式,所以定义域内无论 $k$ 取何值 $C$ 中出现奇数次的字符数量和 $f(s[i,n-1])$ 相等。
所以我们需要求出(此处 $f$ 与题目中 $F$ 同义):
- 对于每个 $0\le i\le n-1$,求出 $f(s[i,n-1])$,这个直接开桶倒着扫一遍即可;
- 对于每个 $1\le i\le n-1$,求出 $f(s[0,0]),f(s[0,1]),\dots,f([0,i-1])$ 中大于 $f(s[i,n-1])$ 的和大于 $f(s[0,n-1])$ 的数的个数分别是多少,首先 $f(s[0,0]),f(s[0,1]),\dots,f([0,i-1])$ 可以扫一遍求出来,然后扫的过程中用一个数据结构(比如树状数组或者线段树)或一个容器(比如 `std::set`)存一下(或者由于其值域只有 $26$ 可以考虑开桶做到 $|\Sigma|$ 甚至把桶开到树状数组或者线段树上做到 $\log |\Sigma|$),就可以按上述方法求解答案了。
这样我们就做完了,根据实现方式不同复杂度为 $O(n\log n)$、$O(|\Sigma|n)$ 或者 $O(n\log |\Sigma|)$ 不等。
:::
## C - P7115 [NOIP2020] 移球游戏
:::info[统计知识点]
- 其他 - 分治思想
:::
共有 $n+1$ 个柱子,前 $n$ 个柱子上各有 $m$ 个球,其中颜色 $1\sim n$ 的球各 $m$ 个。每次操作可以选择一个有球的柱子 $x$ 和另一个球数少于 $m$ 的柱子 $y$,并将 $x$ 顶部的球移到 $y$ 顶部。
构造一种不超过 $820000$ 次操作的方案,使每种颜色的球都在同一柱子上,保证有解。
数据范围:$n\le 50,m\le 400$。
:::success[做法]
看到本题容易联想到 hanoi 塔,于是不难想到考虑最小的也就是 $n=2$ 的情况。
此时我们先将其中一列排序:
- 记该列中颜色 $1$ 的个数为 $k$。
- 先将另一列顶部的 $k$ 个球移入空列。
- 然后将该列中颜色 $1$ 的球移入另一列中,颜色 $2$ 的球移入空列中。
- 然后先将移入空列中的球放回,再将移入另一列中的球放回,这样这一列就实现了上面全是颜色 $1$ 而下面全是颜色 $2$。
在这之后,我们将另一列中移入空列的球放回,将该列中颜色 $1$ 的球放入空列,然后将另一列中的球归类,我们就用 $2m+3k$ 次操作完成了 $n=2$ 的问题。这里,由于到底谁是颜色 $1$ 并不妨碍做题,$k$ 最大为 $\left\lfloor\dfrac{m}{2}\right\rfloor$,故总操作次数最多为 $\dfrac{7m}{2}$ 次。
此时顺着 hanoi 塔的思路,我们需要将 $n$ 更大时的问题转化为 $n=2$ 的问题。遂考虑 $n=3$ 的情况。
我们发现,$n=3$ 其实是没法直接像刚才 $n=2$ 那样做的,所以我们转化为 $n=2$ 就只能分出一种颜色。怎么分呢?
既然我们会做 $n=2$,那我们将不需要分出的颜色视为一种,而需要分出的视为另一种,这样我们就可以跑 $n=2$ 的算法了。想到这一步,这题其实就做完了:每次将处理的颜色区间 $[l,r]$ 分为 $[l,mid]$ 和 $[mid+1,r]$ 然后两两跑 $n=2$ 的分类。总操作次数 $\dfrac{7nm}{2}\lceil\log n\rceil$ 次完全可过。
:::
## D - P7116 [NOIP2020] 微信步数
:::info[统计知识点]
- 数学 - 拉格朗日插值
:::
有一个 $k$ 维空间,第 $i$ 维的范围是 $[1,w_i]$。从起始点出发,每轮操作共 $n$ 次,第 $i$ 次将第 $c_i$ 维的坐标增加 $d_i\in\{-1,1\}$,重复循环所有的操作直至某次操作后坐标超出了范围。求空间中所有点作为起点可操作的次数之和,若某个点会无限循环,输出 $-1$。
数据范围:$n\le 5\times 10^5,k\le 10$。
:::success[做法]
个人感觉出得极好的一题。也纪念我第二次独立完成紫题。
这是一篇多图长文,希望能对大家有所帮助。
### 第一步:快速求一个点的答案
为了方便画图,我们先假设 $k=2$,即问题在平面内。
假设我们的路线是这样的:
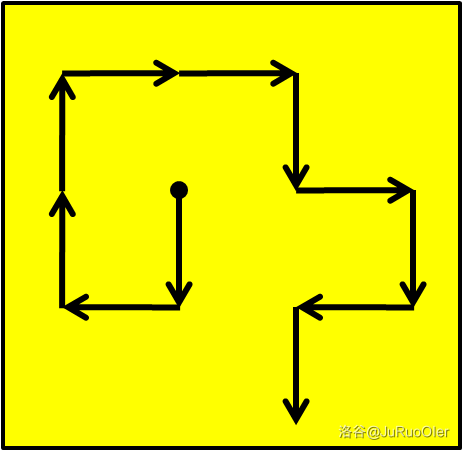
那么一个显然的想法是直接走红色的路径:
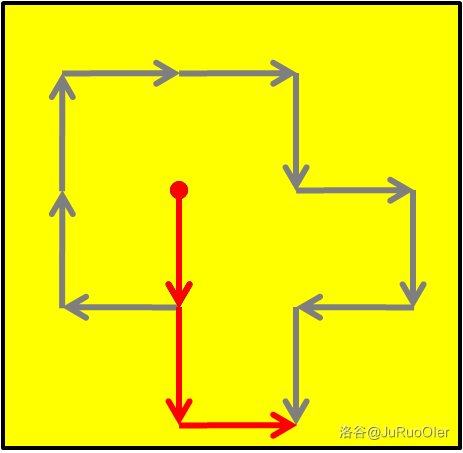
但是这立刻出现一个显然的问题:如果开始位置比较靠边,可能没有办法走完全部 $n$ 步就出界了。所以我们需要先判断当前起始的位置是否会出界,如果不会就走红色的路线直到到达一个会出界的起点,然后暴力地走 $n$ 步。
上述过程中显然只有走红色路线的部分有较大优化的空间:我们希望一下子算出走多少步之后会到达一个会出界的起点。
于是我们需要知道在靠边缘多近时我们才会出界。这意味着我们需要求出路线的四至点。下图中假设起点位于 $(0,0)$,采用传统坐标系。
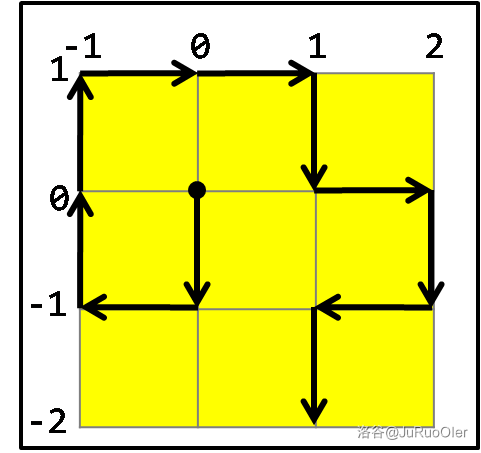
路线中向上、下、左、右最多分别会走一格、两格、一格、两格,也就是说,上、下、左、右最靠边的分别 $1$、$2$、$1$、$2$ 格范围内的所有点作为起点时会在 $n$ 步内出界。由于最终的合位移最多只会向两个方向,因此直接判断哪个方向更先到达上述范围,然后算出到达上述范围的步数即可。
### 第二步:快速求每个点的答案
我们这里以一个 $8\times8$ 的格为例。
即使都是作起点时 $n$ 步内会出界的点,出界所需的步数也是不一样的。接续刚才求“四至点”的思想,其实我们完全可以对每一步都求四至点,这样就知道最靠四边的每一行(或者列)会在多少步内移出了。比如:
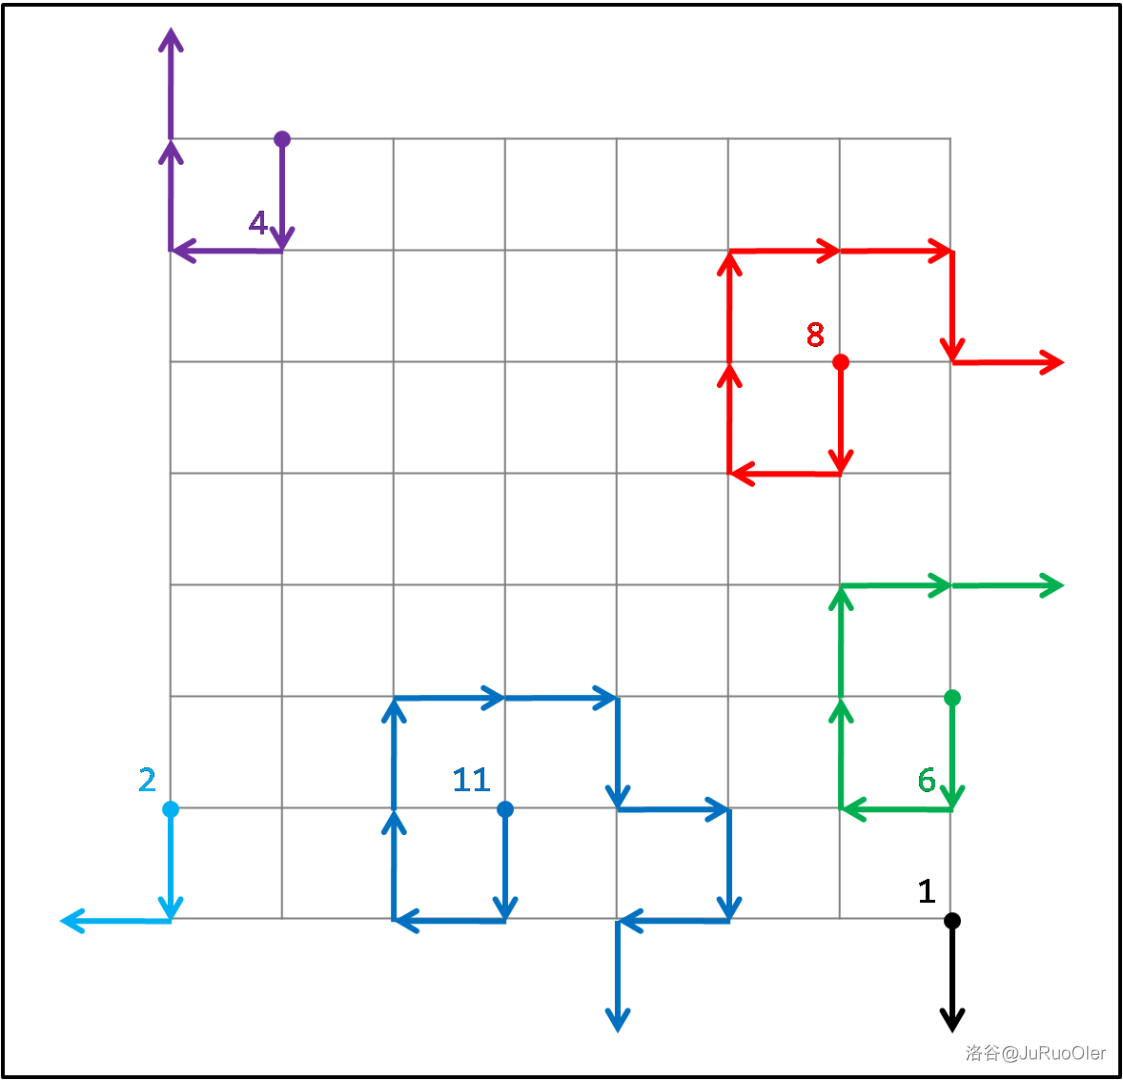
是上述路线中所有会改变路线四至点的步数。这启发我们不需要维护每一步的四至点,而**在四至点变化的每一步维护上述**“**最靠四边的每一行(或者列)会在多少步内移出**”。由于这最多影响 $n$ 行(或者列),所以我们可以开四个长度为 $n$ 的数组分别存四边向内各行(列)出界所需的步数(显然只存一轮内能离开的行或列)。比如上述情况可存储为:
|下标|$1$|$2$|$3$|$4$|$\dots$|$-3$|$-2$|$-1$|$0$|
|:-:|:-:|:-:|:-:|:-:|:-:|:-:|:-:|:-:|:-:|
|$\mathbf{x}$|$2$||||$\dots$|||$8$|$6$|
|$\mathbf{y}$|$1$|$11$|||$\dots$||||$4$|
而将上述数据放到地图里的时候,我们发现一个点可能存在于多个一轮内会出界的行(或者列)中,此时显然**需要对所有的出界步数取最小值**,因为这些步数中任何一个都会导致出界,而第一次出界之后就停止了。于是地图可以写成下面这样(数字表示右下角格点出界所需步数):
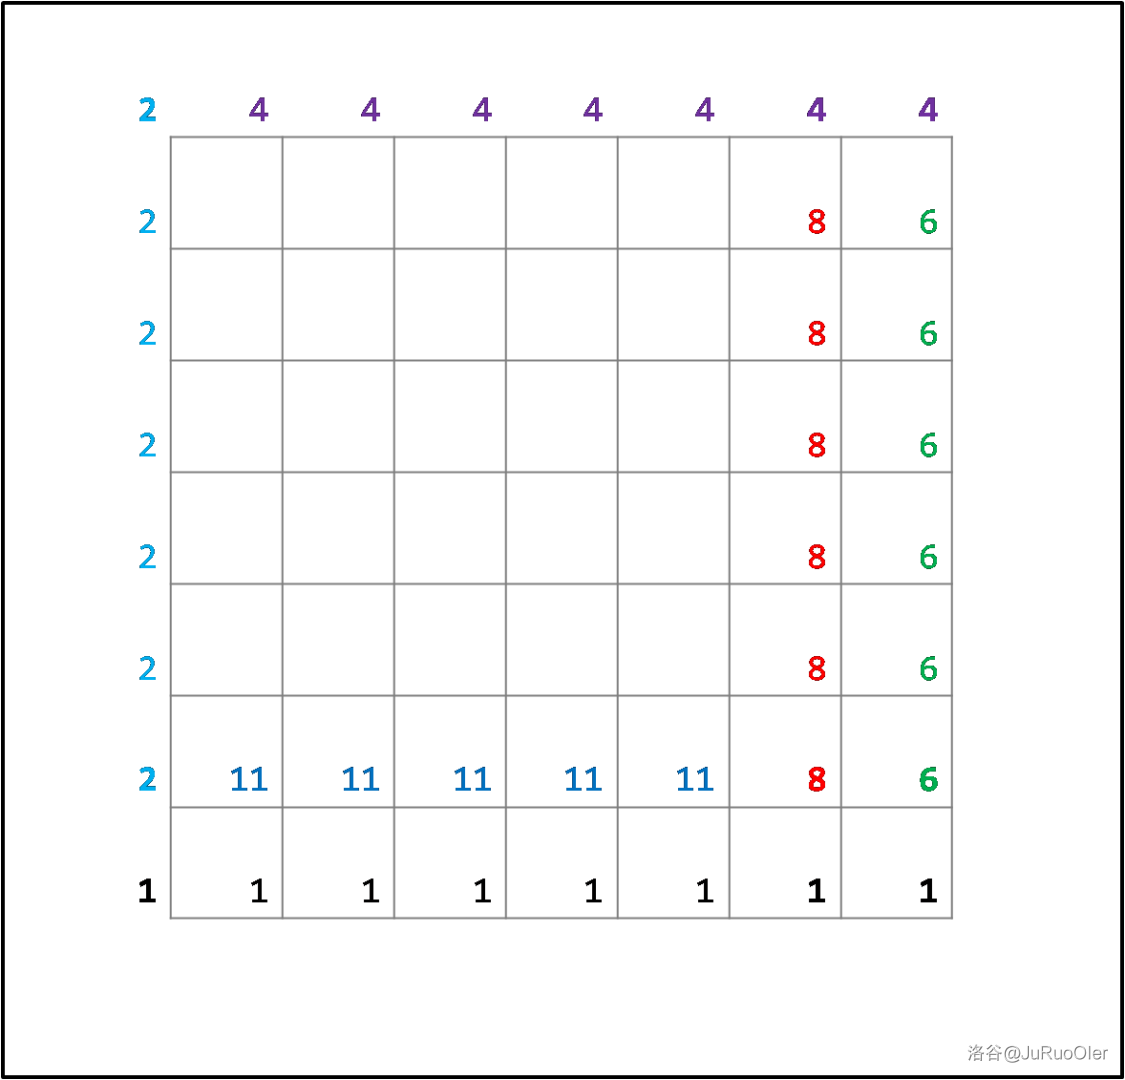
其中加粗的数字表示该格被多行(列)覆盖,取最小值。
边上的格子处理完了,接下来要处理内部的格子。
显然,如果路线有相对位移的话,走若干轮后一定会走到一个上图中有数字的位置,于是我们把格子填满:
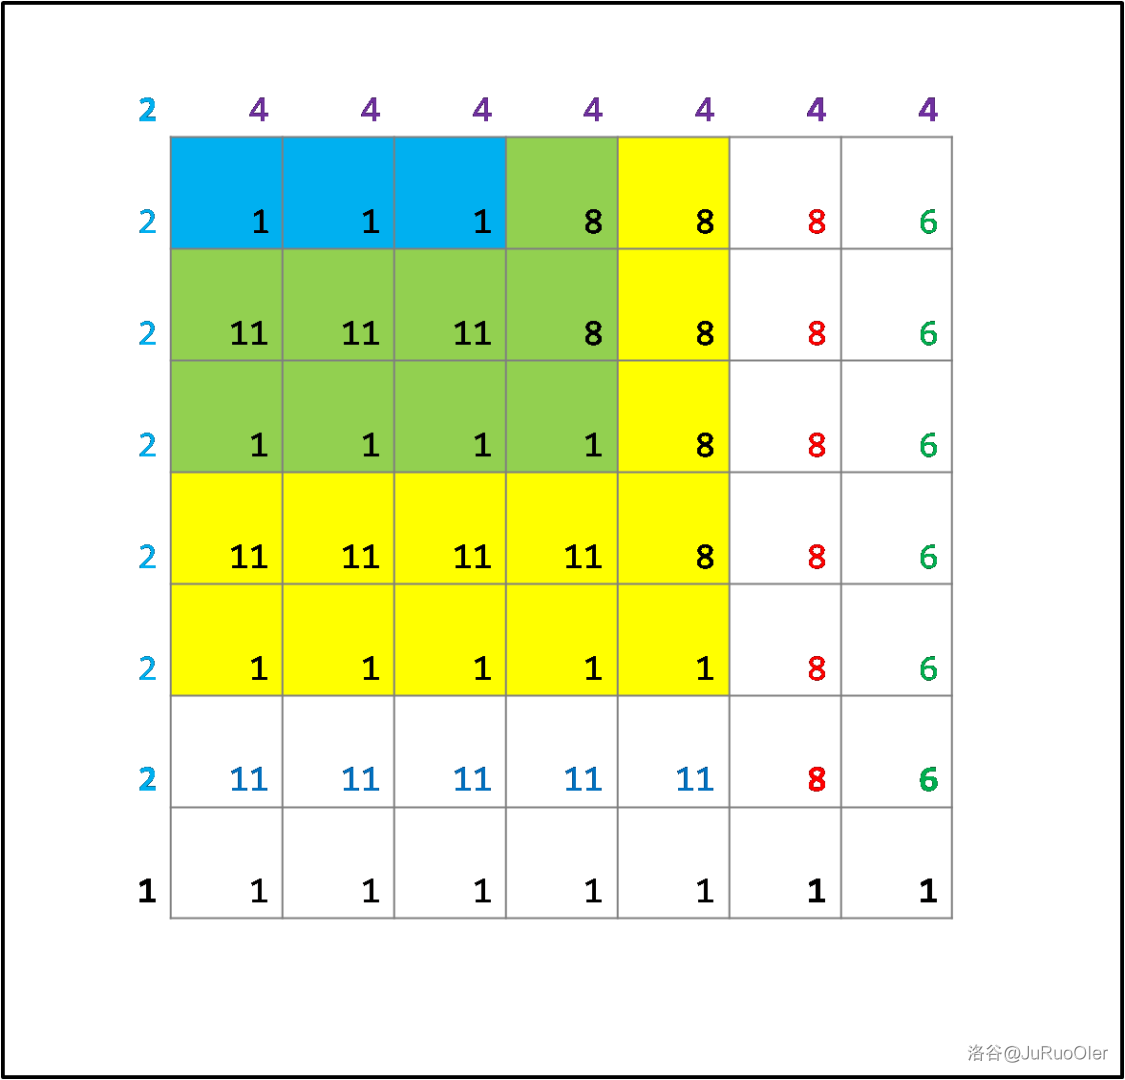
其中黄底、绿底、蓝底格子分别需要额外走 $1,2,3$ 轮。结合第一步中的快速移动至边上,中间部分的格子我们也就算出来了,于是我们已经完成了第二步:快速求出每个点的答案。
### 第三步:快速求所有点答案和
但是我们需要求所有点的答案之和。
刚才的图其实已经启发我们了:我们可以将格子的底色和数字分别求和。我们一个一个来考虑。
- 对于底色,我们发现同样颜色的块都是异形的,难以分开计算。但是我们发现一段颜色的后缀(最左上角的若干种颜色)拼起来是矩形,所以我们其实可以将 $3b+2g+y$ 视为 $b+(b+g)+(b+g+y)$,其中 $b,g,y$ 分别表示蓝、绿、黄色区域的面积,这样我们就可以将底色表示的答案变成若干矩形的面积和了。**如果一轮中 $n$ 步合位移是 $(x,y)$,则每个颜色后缀矩形依次增加 $|y|$ 行、$|x|$ 列**,显然每个矩形的面积都是一个与颜色数相关的二次多项式,即若设有底色的所有格子构成大小为 $a$ 行 $b$ 列的矩形,则我们需要求的是 $\displaystyle\sum_{k=0}^{\min\left\{\left\lfloor\frac{a}{|y|}\right\rfloor,\left\lfloor\frac{b}{|x|}\right\rfloor\right\}}(a-k|y|)(b-k|x|)$,其中求和符号内部的东西是一个关于 $k$ 的二次多项式,且除 $k$ 外的所有东西都是确定的,于是我们可以对所有的次数 $i$ 求出 $k^i$ 的总和并乘上这一次项的系数。
- 对于数字,我们发现**如果一轮中 $n$ 步合位移是 $(x,y)$,则每种底色的格子只涉及 $|y|$ 行、$|x|$ 列,且每换一种颜色每行宽度减少 $|x|$,每列高度减少 $|y|$**,这些都可以通过把上图画一遍来理解。于是这里变成了一个等差数列求和。
加上白底部分的答案(这显然在求解表格中值的时候就可以顺便求出来了),至此,我们已经解决了 $k=2$ 的问题。
### 第四步:将做法扩展到更高维
其实其他维度的问题和 $k=2$ 是相似的,只是最终的式子有所不同:底色部分变为一 $k$ 次式子,数字部分变为一 $k-1$ 次式子。而 $\displaystyle\sum_{i=0}^n i^k$ 是一个 $k+1$ 次多项式(证明可以参考[此题](https://www.luogu.com.cn/problem/CF622F)题解区,不过本题暴力做就行),故我们可以通过拉插等方法求出所需项的值,然后就可以用上述方法解决了。至此,我们就完成了这道题目,复杂度 $O(nk^2)$。
:::
# CSP-S2 2021
## A - P7913 [CSP-S 2021] 廊桥分配
怎么又降回去了。
:::info[统计知识点]
- 数据结构 - 模拟、堆(或者类似的能维护最值的东西)、前缀和
:::
有 $n$ 个廊桥,你需要将一部分(可以为空或全部)分给国内区,剩下的分给国际区。某区有飞机到时,只要该区还有廊桥,就会停靠在廊桥,反之不能依靠在廊桥。共有 $m_1$ 个国内航班飞机、$m_2$ 个国际航班飞机,给定所有飞机的抵达和离开时刻(这些时刻互不相同),求至多能让多少飞机停在廊桥。
数据范围:$n,m_1+m_2\le 10^5$。
:::success[做法]
不考虑廊桥数量的限制,每个飞机都安排在尽可能靠前的廊桥时,每个飞机安排到的廊桥位置就是其能使用廊桥时所需最小的廊桥数量。这容易用两个堆分别维护空闲廊桥和占用廊桥的方式计算,其中维护空闲廊桥的堆按编号建立小根堆,维护占用廊桥的堆按离开时间建立小根堆,每次先处理所有需要解除占用的廊桥,再取出编号最小的空闲廊桥停机。算完这个后分别前缀和即可求出国内和国际区安排 $i$ 个廊桥时可停靠航班数,然后扫一遍对 $s1_i+s2_{n-i}$ 求个最大值即可。
记得把前缀和跑到 $n$,只跑到 $m_1,m_2$ 会 WA on #9,因为可能存在 $m_1+m_2<n$ 的情况。
:::
## B - P7914 [CSP-S 2021] 括号序列
:::info[统计知识点]
- DP - 区间 DP
:::
定义“超级括号序列”是由字符 `(`、`)`、`*` 组成的非空字符串,并且对于某个给定的常数 $k$,给出了“符合规范的超级括号序列”的定义如下:
1. `()`、`(S)` 均是符合规范的超级括号序列,其中 `S` 表示任意一个仅由**不超过** $\bm{k}$ **个**字符 `*` 组成的非空字符串(以下两条规则中的 `S` 均为此含义);
2. 如果字符串 `A` 和 `B` 均为符合规范的超级括号序列,那么字符串 `AB`、`ASB` 均为符合规范的超级括号序列,其中 `AB` 表示把字符串 `A` 和字符串 `B` 拼接在一起形成的字符串;
3. 如果字符串 `A` 为符合规范的超级括号序列,那么字符串 `(A)`、`(SA)`、`(AS)` 均为符合规范的超级括号序列。
给出一个长度为 $n$ 的超级括号序列,其中一些位置的字符尚未确定(用 `?` 表示)。求有多少种将所有尚未确定的字符一一确定的方法,使得得到的字符串是一个符合规范的超级括号序列?
:::success[做法]
一个容易想到的思路是设 $dp_{i,j,k}$ 表示考虑了前 $i$ 个字符、有 $j$ 个左括号还未匹配、前 $i$ 个字符中最后有 $k$ 个 `*` 的方案数,转移直接分别考虑这个位置能否填入 `(`、`)`、`*` 并按照上述状态定义转移即可。
但是这个做法是有问题的:形如 `(SAS)`(即 `(*...*(...)*...*)`,两侧 `*` 个数不超过 $k$ 个)的情况并不合法,而上述算法统计了这样的情况。
这种情况下,我们根据字符串变换的方式,可以考虑区间 DP:设 $dp_{l,r}$ 表示符合条件的超级括号序列数量,则枚举断点 $i$ 后分别考虑每种变换方式:
- `()`、`(S)` 型:直接枚举 $|S|$。
- `(A)`、`(AS)`、`(SA)` 型:枚举断点即可。
- `AB`、`ASB` 型:枚举断点,用前缀和优化一下枚举 $|S|$ 的过程即可。
但这样第三类会每个断点都算一次导致很多重复。考虑去除重复。
考虑使每个第三类的合法串只在第一处断点被计算。这意味着,我们不再允许 DP 过程中将两个第三类连成一个大的第三类。
这是容易的:前两种情况的共同特征是最外面要套一层括号。所以我们按字符串最外面是否是相匹配的一对括号分类计算,上述错误做法中第三种情况则只允许断点左侧选择最外面是相匹配括号的情况。
:::
## C - P7915 [CSP-S 2021] 回文
:::info[统计知识点]
- 其他算法
:::
给定长为 $2n$ 的数组 $a$,其中 $1\sim n$ 中每个整数各出现 $2$ 次。每次操作可以从 $a$ 的开头或结尾选一个整数,将之删除并加入 $b$ 的末尾。求一个字典序(定义取开头小于取结尾)最小的操作序列,使所得的 $b$ 是回文串。
数据范围:多测,$\sum n\le 5\times 10^5$。
:::warning[观看视频题解时请注意]
**本题视频中的表述有点问题。文字题解是正确的,看视频题解时可以无视其与本题解的差异或者看置顶评论的勘误**。在此因给大家带来的不便谢罪。
:::
:::success[做法]
注意到由于每个数只会出现恰好两次,所以前一半和后一半必然是对称的两个**排列**,而由于每次往 $b$ 里放的时候只会往后放所以后一半在 $a$ 中是连续的,也就是要求 $a$ 中有一个连续段是排列。不过这是有解的必要不充分条件所以我们没法用这个来判掉所有的无解。
但是我们其实没必要额外判断是否有解。直接每次贪心地取左侧的值,既然后一半是连续的那我取的这个值也必须和我之前取值对应的后一半是相连的,如果不是就不能取,反之一定能取。于是不确定的只剩下第一次取哪里,这个直接第一次先取左边跑一遍没跑出来再跑右边即可。
:::
## D - P7916 [CSP-S 2021] 交通规划
:::info[统计知识点]
- 图论 - 最短路
- DP - 区间 DP
:::

如图,给定 $n$ 条横线、$m$ 条竖线形成的网格,其中最外圈数字所表示的端点(称“附加点”)有黑或白的颜色。任有边相连的两点(不含附加点)间有边权。
$T$ 次询问,每次指定一部分附加点及其颜色、到相邻格点的边权,求将格点染色后,两端点颜色不同的边的边权和最小是多少。
数据范围:$T\le 50,n,m\le 500$,每次询问指定的附加点个数不超过 $50$。
:::success[做法]
### $k=2
引用 xht 在 P4001 下的题解,其中给出了本题的关键性质:
平面图
边与边只在顶点相交的图。
对偶图
对于一个平面图,都有其对应的对偶图。
平面图被划分出的每一个区域当作对偶图的一个点;
平面图中的每一条边两边的区域对应的点用边相连,特别地,若两边为同一区域则加一条回边(自环)。
这样构成的图即为原平面图的对偶图。
定理
平面图最小割 = 对偶图最短路。
而在 k=2 且两点颜色不同(相同答案显然为 0 )时最优的方案明显是形如下图的(以样例为例):
也就是图中分为两个连通分量(定义有边相连的同色点为连通):询问给出的黑点连接若干染色得到的黑点形成一个连通分量,白色点同理。这其实就是这个图的最小割。
根据“平面图最小割 = 对偶图最短路”的定理,我们考虑先把对偶图建出来:
然后我们需要找到起点和终点。我们割掉的是两个连通块之间的边,所以边上一圈的点被两个给定点分成两部分,一部分连接起点,一部分连接终点,这样就能确保求出的最短路是能把原图割开的。
这样我们就把 k=2 的情况做完了。
完整做法
推广 k=2 的情况,大胆猜想一段连续的点同色点对应一个连通块。所以对偶图的各个起点应该在异色的给定点之间:
此时把原图割开就需要对起点进行配对后两两取最短路,这个过程可以无脑区间 DP 做到 k^3 ,然后只需要以每个点为起点跑遍最短路就做完了。
另外路线有时会转出去再转回来,所以同色给定点间也需要建点,只不过不进行配对。
:::info[相关题目]
P4001 [ICPC-Beijing 2006] 狼抓兔子
:::
NOIP 2021
A - P7960 [NOIP2021] 报数
:::info[统计知识点]
数据范围:$T\le 2\times 10^5,x\le 10^7$。
:::success[做法]
注意到本题的值域并不大,直接预处理所有 $1.1\times10^7$ 内的含 $7$ 的数字的倍数,并用类似链表的结构,预处理出每个合法数字的下一个合法数字加速查询即可。
:::
## B - P7961 [NOIP2021] 数列
:::info[统计知识点]
- DP - 数位 DP
:::
给定整数 $n, m, k$ 和一个长度为 $m + 1$ 的正整数数组 $v_0, v_1, \dots, v_m$。
对于一个长度为 $n$、值域 $[0,m]$ 的序列 $a$,我们定义它的权值为 $v_{a_1} \cdot \dots \cdot v_{a_n}$。
当这样的序列 $\{a_i\}$ 满足整数 $S = 2^{a_1} + 2^{a_2} + \cdots + 2^{a_n}$ 的二进制表示中 $1$ 的个数不超过 $k$ 时,我们认为 $\{a_i\}$ 是一个合法序列。
计算所有合法序列 $\{a_i\}$ 的权值和对 $998244353$ 取模的结果。
数据范围:$n\le 30,m\le 100$。
:::success[做法]
**为了避免混淆,本题解中使用 $K$ 表示题中的 $k$**。
仍然面向数据范围编程,数据范围很小但分析爆搜复杂度后发现差得远遂考虑 DP。
很难不注意到这玩意是需要处理进位的,遂从低往高考虑,不难设计出状态 $dp_{i,j,k}$ 表示考虑了前 $i$ 位,放了 $j$ 个 $1$,实际上 $S$ 中有 $k$ 个 $1$ 的答案。但我们实际上还要额外处理进位,而不同进位情况对应的状态显然应该不同所以把往下一位进了多少也丢状态里,然后直接转移即可。这里为了方便处理,选择用自己更新后面,故枚举这一位上放的 $1$ 的个数 $x$ 有转移方程:
$$dp_{i,j,k,l}v_i^x\text{C}_{n-j}^x\to dp_{i+1,j+x,k+(l+x\bmod 2),\lfloor\frac{l+x}{2}\rfloor}$$
根据状态的定义显然有初始状态 $dp_{0,0,0,0}=1$,答案为所有满足 $k+\text{popcount}(l)\le K$ 的 $dp_{m+1,n,k,l}$ 之和,记得取模。由于复杂度比较极限所以组合数需要预处理,有递推式(建议直接背下来):
$$\text{C}_n^m=\text{C}_{n-1}^m+\text{C}_{n-1}^{m-1}$$
其中 $\text{C}_i^0=1,\text{C}_0^i=0$(后者 $i>0$)。
:::
## C - P7962 [NOIP2021] 方差
>笔者比较菜,花了不少时间理解转移方程,遂在此展开解释了转移方程。
:::info[统计知识点]
- DP - 普通 DP
:::
给定长度为 $n$ 的非严格递增正整数数列 $1 \le a_1 \le a_2 \le \cdots \le a_n$。每次可以进行的操作是:任意选择一个正整数 $1 < i < n$,将 $a_i$ 变为 $a_{i - 1} + a_{i + 1} - a_i$。求在若干次操作之后,该数列的方差最小值是多少。请输出最小值乘以 $n^2$ 的结果。
数据范围:$n\le 400,a_i\le 600$ **或者** $n\le 10^4,a_i\le 50$。
:::success[做法]
注:本题差分数组的最后一项显然是没有意义的,所以本题解中涉及差分数组均无视最后一项。
这种让你操作的题可以先试着找操作到底在干什么。其实就是交换差分数组的两项:
- 设原数组中一个长度为 $3$ 的子段 $a_1,a_2,a_3$ 的差分数组是 $d_1=a_2-a_1,d_2=a_3-a_2$。
- 对 $a_2$ 进行操作所得 $a_2'=a_3+a_1-a_2$。
- 于是新的差分数组 $d_1'=(a_3+a_1-a_2)-a_1=a_3-a_2=d_2,d_2'=a_3-(a_3+a_1-a_2)=a_2-a_1=d_1$,即将 $d_1$ 与 $d_2$ 进行了交换。
考虑到方差是每个数**与平均值之差**的平方的平均值,显然差分数组中一个值越靠边,其贡献次数就越少,所以接着很显然的思路是把大的靠边放。(根本用不着题解区大坨式子证明,可以画数轴理解)
现在问题在于差分数组的每个值应该放在“中间”的左边还是右边。作者数学很差不会推式子,遂抄了题解的式子:
$$ans=n\sum_{i=1}^na_i^2-\left(\sum_{i=1}^na_i\right)^2$$
设 $dp_{i,j}$ 表示在放第 $i$ 个差分值(升序),$a$ 数组已填放部分之和为 $j$ 的最小平方和。
- 为了方便计算,状态中计算的和及最小平方和均只包含已经填入的部分。显然填入的部分是中间的一段。
- 如果将 $d_i$ 放在左侧,则已经填入的 $i$ 个数均会受到 $d_i$ 的影响(但新填入的数显然不会,因为它在 $d_i$ 左侧)所以要把已经填入的数都加上 $d_i$,有(设已填入的 $a$ 值为 $a'_1,a'_2,\dots,a'_i$):
$$\sum_{k=1}^{i}(a'_k+d_i)^2\to dp_{i+1,j+id_i}$$
完全平方展开 $(a'_k+d_i)^2$ 得:
$$\sum_{k=1}^i(a'_k)^2+\sum_{k=1}^i2a'_kd_i+\sum_{k=1}^id_i^2\to dp_{i+1,j+id_i}$$
代入 $\displaystyle\sum_{k=1}^{i}(a'_k)^2=dp_{i,j},\sum_{k=1}^{i}a'_k=j$:
$$dp_{i,j}+2jd_i+id_i^2\to dp_{i+1,j+id_i}$$
- 如果将 $d_i$ 放在右侧,则已经填入的 $i$ 个数不受影响,而新填入的数受前面所有 $d_i$ 的影响。故有:
$$dp_{i,j}+\left(\sum_{k=1}^i d_k\right)^2\to dp_{i+1,j+\tiny\displaystyle\sum_{k=1}^i d_k}$$
其中 $\displaystyle\sum_{k=1}^i d_k$ 可以直接开个变量记录实现 $O(1)$ 转移。
然后每个 $dp$ 值取能转移到的状态里的最小值即可。初始状态 $dp_{1,0}=0$,答案在所有的 $n\cdot dp_{n,j}-j^2$ 中取最小值,总复杂度 $O(n^2V)$,不能过题。
观察最后两档数据范围发现出题人明示我们写 $O(nV^2)$,而题中给出的原数组是单增的故最多只有 $V$ 个非 $0$ 的 $d_i$,显然根据转移的原理 $d_i=0$ 可以直接无视,于是直接从不为 $0$ 的位置开始转移就实现 $O(\min\{n,V\}nV)$ 了。
:::
:::info[相关题目]
- [CF2252D Array Replacement](https://www.luogu.com.cn/problem/CF2252D)
:::
## D - P7963 [NOIP2021] 棋局
:::info[统计知识点]
- 数据结构 - 并查集、线段树合并
:::
游戏在一张长 $n$ 行宽 $m$ 列的网格形棋盘上进行,棋子落在网格的交叉点上,我们不妨记左上角的交叉点的坐标为 $(1,1)$,右下角的交叉点坐标为 $(n,m)$。
棋子分为黑白两色,对局双方各执一方棋子。每个棋子除了颜色以外还有等级,不妨设 $\mathit{col}_i$ 为棋子 $i$ 的颜色,$\mathit{lv}_i$ 为棋子 $i$ 的等级。另外,棋盘上的网格线共有 $4$ 种状态,对于第 $i$ 条网格线,设其状态为 $\mathit{opt}_i$。
轮到每方下棋时,他可以选择棋盘上的一个己方棋子沿网格线进行移动到另一个交叉点,称为走子,需要满足:
- 走子必须沿着网格线走;
- 不能原地不动或走回原地;
- 走子时不能越过已有的棋子;
- 只能吃与自己颜色不同,且等级不高于自己等级的棋子;
- 不允许棋子在吃子后继续向前走。
网格线的状态含义如下所述:
- 如果 $\mathit{opt}_i=0$,代表此路不通,走子时不能经过这条网格线;
- 如果 $\mathit{opt}_i=1$,代表这条网格线是一条“普通道路”,每次走子时棋子最多只能经过 $1$ 条普通道路;
- 如果 $\mathit{opt}_i=2$,代表这条网格线是一条“直行道路”,每次走子时棋子可以经过任意条直行道路,但只能**一直沿横向或一直沿纵向走,不能转弯**;
- 如果 $\mathit{opt}_i=3$,代表这条网格线是一条“互通道路”,每次走子时棋子可以经过任意条互通道路,且中途可任意转弯。
同时规定在一次走子过程中,**棋子经过的网格线的状态必须全部相同**,比如从 $(1,1)$ 经过直行道路走到 $(1,2)$ 再经过互通道路走到 $(1,3)$ 是不允许的。
一开始棋盘是空的,有 $q$ 次询问,每次询问给定一个位置,在该位置设一棋子(会影响此后的询问),求棋盘上当前一共有多少个位置是它一次能被走到的。
数据范围:多测,$T\le 5,nm\le 2\times 10^5,q\le 10^5$。
:::success[做法]
~~其实感觉这把还是 D<C~~至少思维上 D 是容易想出来的你说是不是吧(逃)。
首先题意说明我们要维护 $3$ 类边组成的连通块。但是加入点后会导致连通块分裂,维护难度大增。故考虑时间倒流,删除点,于是连通块分裂变为连通块合并。对于连通块,我们需要维护:
- 其包含的点数
- 其上黑子不高于某一等级的数量
- 其上白子不高于某一等级的数量
显然后两者是权值线段树,第一个是并查集,于是直接并查集合并+线段树合并就做完了。
然后考虑由 $2$ 类边组成的连通块。这样的连通块是横平竖直的。所以我们可以分别维护横向和纵向的并查集,解决问题。
$1$ 类边直接暴力即可。
现在考虑 $2$ 类边和 $3$ 类边重复的情况。注意到 $2$ 类也可以视为横平竖直的连通块,故分别按行按列开线段树维护 $3$ 类连通块,实现区间查询某连通块某行某范围内有多少个点的功能,则也可以一起进行线段树合并,然后就做完了。
:::
# CSP-S 2022
## A - P8817 [CSP-S 2022] 假期计划
:::info[统计知识点]
- 其他算法 -(类)Meet-in-the-middle。
:::
给定 $n$ 个点 $m$ 条边的无向图及整数 $k$。称一个从 $1$ 出发,经过四个不同的点后回到 $1$,且任相邻两点间最短路径边数均不超过 $k+1$ 的路线是合法的。求最长合法路线经过的四个点的点权和。
数据范围:$n\le 2500,m\le 10^4,k\le 100$。
:::success[做法]
注:对于一条形如 $1\to x\to y$ 的路线(其中 $x$ 在 $1$ 的 $k+1$ 邻域内,$y$ 在 $x$ 的 $k+1$ 邻域内),后面称之为一条**半路线**,$x$ 称之为该半路线的**中转点**,$y$ 称之为该半路线的**终点**。
首先预处理 $k+1$ 邻域(注意到 $2500\times2500$ 的 `bool` 数组只需要不到 $6\text{MB}$)后纯纯大暴力复杂度 $O(n^4)$,不能接受。
注意到纯纯大暴力复杂度的指数除以 $2$ 后可以通过,遂考虑 Meet-in-the-middle,从枚举路线变为枚举半路线。则显然一条完整的环线是两个半路线拼起来,而能不能拼就是看这两个半路线的终点是否互为对方 $k+1$ 邻域内的点,以及两半路线是否共用除 $1$ 外的点。如果能快速地求出所有能拼的半路线的权值最大值,是不是就做完了?
但是半路线似乎是有 $O(n^2)$ 条的。所以即使真的存在一些能快速实现这种东西的 DS 科技,你的复杂度也带上了至少一个 $\log$,但 $n^2\approx6\times10^6$ 已经不宽裕了,于是通过实为困难。难道这个思路不能接着走了吗?
注意,我们刚才说的是,两个半路线能不能拼,就是看**这两个半路线的终点是否互为对方 $k+1$ 邻域内的点**。这意味着,忽略少数共用点的情况,能不能合并**与谁是中转点半毛钱关系没有**。而我们求的又是半路线的最大值,所以同样终点的半路线只有权值和最大的那条是有意义的。于是有效的半路线条数从 $O(n^2)$ 降至 $O(n)$,复杂度是可接受的。
然后判断共用点的情况。做题经验告诉我们,**删少量情况求最值时,如果最多会删 $x$ 种,就记录前 $x+1$ 最值**。分析共用点的情况在特判掉相同终点后包括:
- 共用中转点的情况
- 一个的中转点是另一个的终点的情况
所以极端情况下最大值会被删掉两种情况,于是我们维护每个终点的前三大半路线及其中转点,然后枚举终点对的时候若两点互为对方 $k+1$ 邻域内的点,则直接暴力枚举两点分别取第几小,如果没有共用点就判断能不能更新答案即可……**吗**?
你会发现把维护前三大改维护前两大照过不误。但其实是数据水了(~~不知道我的工单会不会有管理看 ww~~申请加的 hack 已经通过了)。有 hack:
```
5 7 0
4 3 2 3
1 2
1 3
1 4
2 3
2 5
3 5
4 5
```
显然应该输出 `12`,只维护前两大反正是输出别的。
所以这个题做完了,复杂度 $O(n^2)$。
:::
## B - P8818 [CSP-S 2022] 策略游戏
:::info[统计知识点]
- 数据结构 - 线段树
:::
给定长为 $n$ 的数组 $A$ 和长为 $m$ 的数组 $B$,在此基础上定义一个大小为 $n \times m$ 的矩阵 $C$,满足 $C_{i j} = A_i \cdot B_j$。
共有 $q$ 轮游戏,每次给出 $4$ 个参数 $l_1, r_1, l_2, r_2$,满足 $1 \le l_1 \le r_1 \le n$、$1 \le l_2 \le r_2 \le m$。小 L 先选择一个 $[l_1,r_1]$ 之间的下标 $x$,然后小 Q 选择一个 $[l_2,r_2]$ 之间的下标 $y$。定义这一轮游戏中二人的得分是 $C_{xy}$。
小 L 的目标是使得这个得分尽可能大,小 Q 的目标是使得这个得分尽可能小。求按照二人的最优策略,每轮游戏的得分分别是多少。
数据范围:$n,m,q\le 10^5$。
:::success[做法]
显然若 $x$ 确定,则:
- 若 $A_x$ 非负,则 $y$ 一定是给定区间内使 $B_y$ 最小的 $y$;
- 反之,则 $y$ 一定是给定区间内使 $B_y$ 最大的 $y$。
分别求出给定区间内 $B_i$ 的最小值 $a$ 和最大值 $b$。讨论:
- 若 $a\ge 0$,$A_i$ 直接选最大;
- 若 $a<0,b\ge 0$,根据上述选 $y$ 的方案,应该分别找 $A_x$ 能取到的非正数、非负数里绝对值最小的,并求出哪个更优。
- 若 $b<0$,$A_i$ 直接选最小。
上述所有过程都可以对 $A,B$ 分别建权值线段树搞定。
:::
## C - P8819 [CSP-S 2022] 星战
:::info[统计知识点]
- 字符串 - 哈希
:::
给定一个 $n$ 个点 $m$ 条边的有向简单图,初始所有边都存在,$q$ 次操作,操作有四种:
1. 给定 $u,v$,删除边 $(u,v)$;
2. 给定 $u$,删除终点在 $u$ 上的所有边;
3. 给定 $u,v$,恢复边 $(u,v)$;
4. 给定 $u$,恢复终点在 $u$ 上的所有边。
每次操作后,求所有点是否都出度为 $1$ 且在一个环上。
数据范围:$n,m,q\le 5\times 10^5$。
:::success[做法]
口嗨过一车哈希,但这个是真正写了的第二道紫哈希。
首先可以实现反攻的标准是,所有点出度均为 $1$ 且均在一个环上。即图是由若干个至少二元的环构成的。
于是每个点只会有恰好一条入边、一条出边。
所以将所有边的终点进行集合哈希,恰好等于全集时即为 `YES`,反之为 `NO`。
我直接随机了十个二次函数 $a_{i,1}x^2+a_{i,2}x+a_{i,3}$ 进行集合哈希,采用自然溢出,可过。
:::
:::info[相关题目]
- [P5270 无论怎样神树大人都会删库跑路](https://www.luogu.com.cn/problem/P5270)
- [P10785 [NOI2024] 集合](https://www.luogu.com.cn/problem/P10785)
:::
## D - P8820 [CSP-S 2022] 数据传输
:::info[统计知识点]
- DP - 树形 DP
:::
给定一棵 $n$ 个点的树,点有点权 $v_i$。称两个点之间能直接相连,当且仅当其树上路径的边数不超过 $k$。$q$ 次询问,每次给定 $s,t$,求从 $s$ 至 $t$ 的一条路线,满足其中任意相邻两点能直接相连,且路径中各点权和(含端点)最小,输出这个点权和。
数据范围:$n\le 2\times 10^5,k\le 3$。
:::success[做法]
作者数学很差,所以不讲 DDP,讲点人类能看懂的。
上来的暴力思路是,$k$ 邻域内所有点之间建边,查询变求最短路。
这可能会导致边数变得巨大,比如菊花图 $k\ge 2$ 时喜提建了个完全图。所以需要优化边数。
注意到其实原需求就是两做贡献的点间最多隔着 $k-1$ 个不贡献的点。遂直接分 $k$ 层第 $i$ 层表示这是连续第 $i-1$ 个没计入答案的点就做完了。于是开始优化。
考虑到此题是树上路径查询,先给倍增 LCA 搞里头。
然后树上路径问题最省事的方法是树上差分。至于为什么不是前缀和因为我们大胆猜测最短路是可以减的,直接树形 DP 求出走到 $1$ 的最短路然后减就做完了……吗?
我们发现其实不能减,因为 $s$ 到 $1$ 的最短路径不必然使 $s$ 与 $t$ 的 LCA 做贡献。
但是我们又发现虽然 LCA 不必然计入贡献,但它不管怎么说是必然在 $s$ 到 $t$ 的路径上的,所以我们想到可以沿用开始时建点的思路,DP 时也容易了,直接设 $dp_{x,i,y,j}$ 表示第 $i$ 层 $x$ 号点走到第 $j$ 层 $x$ 的 $2^{y}$ 级祖先对应点的答案,转移时只需要先转移 $dp_{x,i,0,j}$ 且为了方便后期合并 $x$ 自身贡献一律不算进 $dp$ 值中(后面算路径的时候单独加一下),故有几种可能:
- $x$ 和其父亲都不贡献答案,有 $dp_{x,0,0,1}=dp_{x,1,0,2}=0$。
- 其父亲贡献答案,$dp_{x,0,0,0}=dp_{x,1,0,0}=dp_{x,2,0,0}=v_{fa_x}$。
- 其走到其附近点权最小的点,再走到其父亲,$dp_{x,2,0,2}$ 为该点权。
后面 $j\neq0$ 的部分像 LCA 里处理 $fa$ 数组一样根据 DP 状态分别枚举所涉及的三个点(较低链较低点、较低链较高点或者较高链较低点、较高链较高点)所在的层进行合并即可。
然后我们分别枚举 $s,t$ 走到 LCA 时 LCA 的状态(即刚才分层图中的 $0/1/2$ 层)并合并答案,设二者分别枚举 LCA 在第 $i,j$ 层,则:
- $i=j=0$ 时 LCA 算重,需要减去 $v_{\text{LCA}}$。
- $i=j=k-1(k\neq1)$ 时无法直接跨过 LCA,需要找 LCA 附近点权最小的点作为中转点,加上该点点权。
- 其他情况可以直接合并路线。
算完了。复杂度 $O(k^3n\log n)$。
:::
# NOIP 2022
## A - P8865 [NOIP2022] 种花
:::info[统计知识点]
- 其他算法
:::
花园可以看作有 $n\times m$ 个位置的网格图,从上到下分别为第 $1$ 到第 $n$ 行,从左到右分别为第 $1$ 列到第 $m$ 列,其中每个位置有可能是土坑,也有可能不是,可以用 $a_{i,j} = 1$ 表示第 $i$ 行第 $j$ 列这个位置有土坑,否则用 $a_{i,j} = 0$ 表示这个位置没土坑。
一种种花方案被称为 $\texttt{C-}$ **形**的,如果存在 $x_1, x_2 \in [1, n]$,以及 $y_0, y_1, y_2 \in [1, m]$,满足 $x_1 + 1 < x_2$,并且 $y_0 < y_1, y_2 \leq m$,使得第 $x_1$ **行**的第 $y_0$ 到第 $y_1$ **列**、第 $x_2$ **行**的第 $y_0$ 到第 $y_2$ **列**以及第 $y_0$ **列**的第 $x_1$ 到第 $x_2$ **行**都**不为土坑**,且只在上述这些位置上种花。
一种种花方案被称为 $\texttt{F-}$ **形**的,如果存在 $x_1, x_2, x_3 \in [1, n]$,以及 $y_0, y_1, y_2 \in [1, m]$,满足 $x_1 + 1 < x_2 < x_3$,并且 $y_0 < y_1, y_2 \leq m$,使得第 $x_1$ **行**的第 $y_0$ 到第 $y_1$ **列**、第 $x_2$ **行**的第 $y_0$ 到第 $y_2$ **列**以及第 $y_0$ **列**的第 $x_1$ 到第 $x_3$ **行**都**不为土坑**,且只在上述这些位置上种花。
分别求 $\texttt{C-}$ **形**和 $\texttt{F-}$ **形**的种花方案数。
数据范围:多测,$T\le 5,n,m\le 10^3$。
:::success[做法]
虽然语言比较~~犯病~~稚嫩,但作为小蒟蒻第一篇过审的题解+第一个独立完成的绿题决定还是不动了(不过删掉了部分过于啰嗦的东西及格式问题),权当留个纪念。所以如果写得不清楚欢迎撅我。
### Part1 题意
一个 $n\times m$ 的方格,其中有一些格不能种花。求在能种花的格子里种 $\texttt{C}$ 形及 $\texttt{F}$ 形的方案数。$\texttt{C}$ 形及 $\texttt{F}$ 形的定义如下:
- $\texttt{C}$ 形要有两横一竖,其中“横”的长度不要求相等但至少是两格;“竖”的长度至少是三格。
- $\texttt{F}$ 形就是在合法的 $\texttt{C}$ 形的“竖”底下加一段。
### Part2 注意点
- 两种**不**合法的情况:
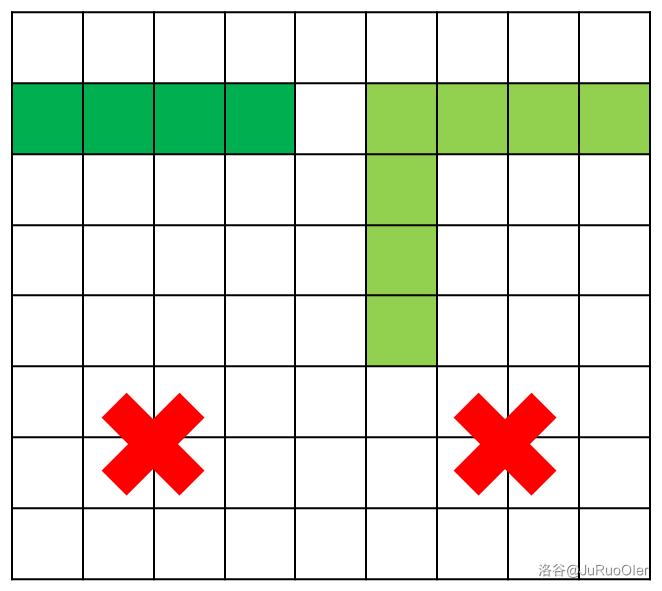
- **重合型**:即两横重合,如图(深绿色是 $\texttt{C}$ 的错误示范,浅绿色是 $\texttt{F}$ 的错误示范)。
- 
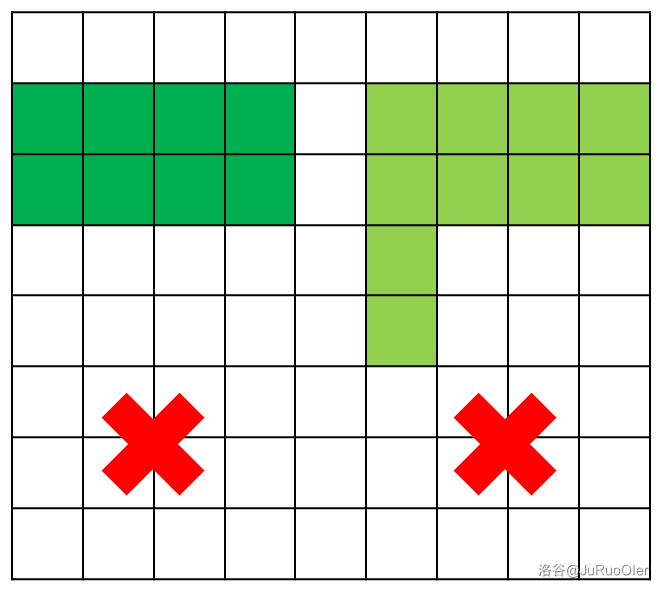
- **相邻型**:即两横相邻,如图(深绿色是 $\texttt{C}$ 的错误示范,浅绿色是 $\texttt{F}$ 的错误示范)。
- 
- 注意本题单个测试点内有多组数据。多测不清空,爆零两行泪。同时请注意换行。
- 注意输出时先乘给定常数再取模,取完模输出。
### Part3 $\text{O}(n^2m^2)$ 暴力做法
对于每一个格子,暴力找以这一格为左上角的所有可能性,一个个累加结果。时间复杂度 $O(n^2m^2)$。具体过程:
- 先找这一格往右有多少格;再从这一格向下走,从它下面的**第二格**(第一格会变成上文的“相邻型”)开始每格向右找,累计每行的格子数,最后乘开始那格往右的格数就是 $\texttt{C}$ 形的数量。$\texttt{F}$ 形还要乘上可以作为竖的格子数。
- 样例一中计算过程如图,其中 $\texttt{C}$ 形计算的两个因数分别是首行可选长度数和该行可选长度数,$\texttt{F}$ 形计算的前两个因数与 $\texttt{C}$ 形一致,最后一个因数是后面剩余的可作为竖的行数。
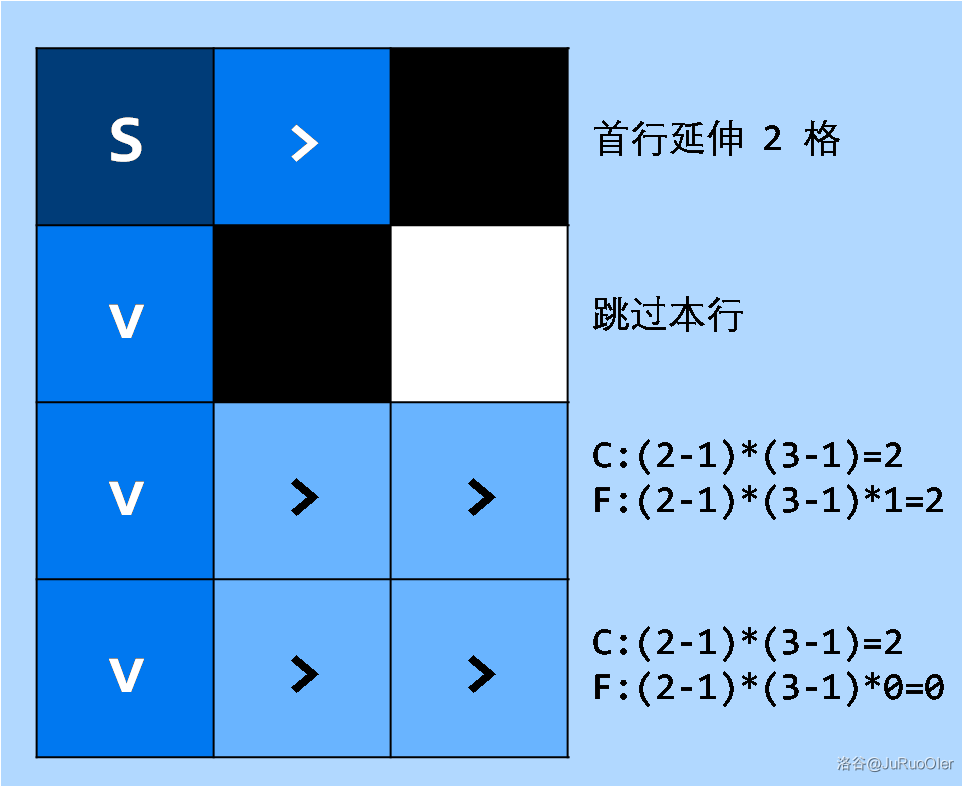
### Part4 如何优化到 $\text{O}(nm)$?
显然,$\text{O}(n^2m^2)$ 的做法最多只有 $39$ 分。依据数据范围,可以猜出,想通过就必须要 $\text{O}(nm)$。
可以发现在上面的图中,每个位置可向右延伸的格数会被算多次。我们就不能用 $\text{O}(nm)$ 的时间把每个点向右及向下到不能种花的位置的格数预处理出来吗?
显然是可以的。从右往左、从下往上一个个计数即可。例如样例第一列统计得:
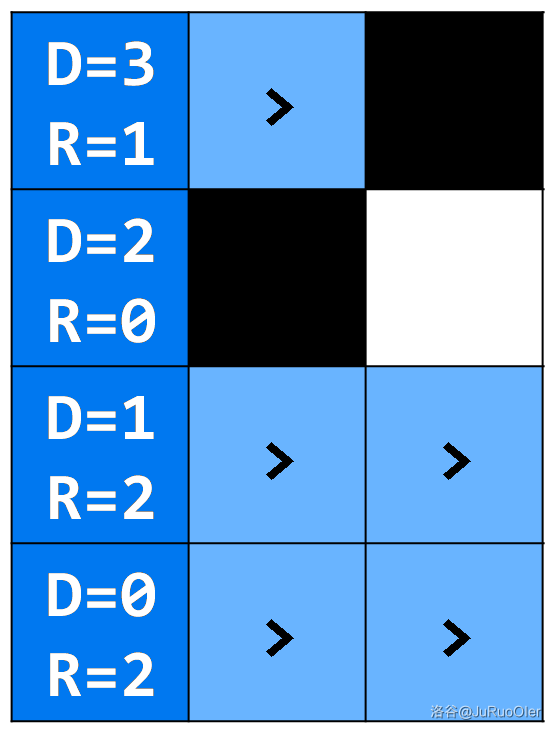
这样复杂度就变成了 $\text{O}(n^2m)$。
接着考虑,为什么非要枚举左上角,每次从上往下找呢?直接枚举第二横与竖的交点,就可以边枚举边计数,不需要每次都重新算上面的可能性有多少了。这样,我们的代码就变成了 $\text{O}(nm)$。
:::
## B - P8866 [NOIP2022] 喵了个喵
:::info[统计知识点]
- 其他算法 - Ad-hoc
:::
有一个 $m$ 张牌的牌堆 $a_i\in [1,k]$ 和 $n$ 个初始为空的栈。牌堆中每一种图案的卡牌都有偶数张。有两种操作:
- 选择一个栈,将牌堆顶上的卡牌放入栈的顶部。如果这么操作后,这个栈最上方的两张牌有相同的图案,则会自动将这两张牌消去。
- 选择两个不同的栈,如果这两个栈栈**底**的卡牌有相同的图案,则可以将这两张牌消去,原来在栈底上方的卡牌会成为新的栈底。如果不同,则什么也不会做。
构造一种操作方案,使所有牌都能被消去。
数据范围:多测,$T\le 1005,n\le 300,\sum m\le 2\times 10^6$。
:::success[做法]
首先注意到 $n=2(k-1)$ 的点放到了送分的位置,估计是没啥难度。
于是注意到最坏情况下前 $k-1$ 个栈可以使每种元素都出现在某栈顶部或底部,而且此时还空出了一个栈。然后就搞定了。然后开始大战多出的那个元素,也就是说我们面对的是变成前 $k-1$ 个栈有 $2(k-1)$ 个互不相同的元素而牌堆顶和这 $2k$ 个都不同的局面。
首先我们显然不可能给多出来那个元素放空栈里,因为这样会直接导致如果下一个是栈底就被封死了。于是为了解决这个问题我们直接开透视,找到下一个不是栈顶的元素(如果某一个元素重复来也不要紧,给它安排那个固定位置即可)。
- 如果这个元素就是我们刚才多的那个,那么可以放心地把多的那个放空栈里;
- 如果这个元素不是我们刚才多的那个,那么它显然是某个栈的栈底,此时看该栈栈顶是否被消去了,如果没有就把刚才多的放上去,消去了就把多的放空栈里,然后把这个栈变成新的空栈。
这个过程是容易维护的于是做完了。复杂度 $O(m)$。
在题解区看到了一个很好的思考方法,转一下:
>如果游戏更改一下规则,玩家必须在读入每个图案后就立即决定该图案应该放进那个栈里。
>
>那么 $k=2n-1$ 时很有可能玩家是必败的。这也启示我们在作当前决策时必须考虑之后的图案。考虑到这一点后本题就不是特别棘手了。
>
>——@[周子衡](https://www.luogu.com.cn/user/112794)
:::
## C - P8867 [NOIP2022] 建造军营
:::info[统计知识点]
- DP - 树形 DP
- 图论 - 缩点
:::
给定 $n$ 个点 $m$ 条边的无向图,你可以选若干个(至少一个)点建造军营,同时选若干条道路看守。求删除任一条未看守的边后,军营之间仍能两两连通的方案数。
数据范围:$n\le 5\times 10^5,m\le 10^6$。
:::success[做法]
读题:B 只会攻击**一条**边。~~这个人以为所有没看守的边可能同时被攻击然后不到一上午其实就做完了但愣是又凹了一下午+一晚上直到看了第一篇题解的第一句话……~~
由于 B 只会攻击一条边所以首先非割边防不防没啥区别。于是缩点变成一棵树。
由于是计数题考虑树形 DP。然后经过/不经过一条边的选点方式是经典问题了:
- 经过即子树内和子树外至少各选一点;
- 不经过即仅子树内任选或者仅子树外任选(本题按题意至少选一点)。
但只拿着这个玩意是算不了答案的,因为又有子树内又有子树外,多条边的答案很难不重不漏地合并。
所以为了方便合并我们直接钦定只能取子树内的点。设点 $i$ 缩点前对应 $v_i$ 个点、$e_i$ 条边,$i$ 的父亲为 $fa_i$,以 $i$ 为根的子树内选 $(i,fa_i)$ 这条边的答案为 $f_i$,以 $i$ 为根的子树内的总边数(含被缩掉的边)为 $sz_i$ 条,则:
- 一个点 $x$ 对其父亲 $y$ 的贡献有三种可能,一种是选择边 $(x,y)$,一种是不选该边但在子树内选点,一种是不选该边且不在子树内选点,其中最后一种不需要记录因为它显然等于 $2^{sz_x}$。
- 第一种可能允许多个儿子同时选择,且允许在 $y$ 上选任意多个点,而不选择这种可能的点则只能选择第三种可能(因为子树外面已经选点了),故这种情况下 $f_y$ 会获得 $2^{v_y+e_y}\cdot\displaystyle\prod_{x\in son(y)}(f_x+2^{sz_x})$ 的总贡献;
- 第二种可能只允许恰好一个儿子选择,且不允许在 $y$ 上选点,而选中边 $(x,y)$ 的情况在上一种可能中其实已经被计算了所以边 $(x,y)$ 不做贡献,故这种情况下 $f_y$ 会获得 $2^{e_y}\cdot\displaystyle\sum_{x\in son(y)}2^{\tiny\displaystyle\sum_{z\in son(y),z\neq x}(sz_z+1)}\cdot f_x$ 的总贡献。
- 但仔细分析,上述过程其实有问题:对于只在一个 $x$ 内选点的情况,我们仍然认为边 $(x,y)$ 选法任意,但不选该边的情况其实是不能更新 $fa_y$ 或以上点的,所以应该分开计算,即 $f_i$ 改为只计算 $i$ 与 $i$ 子树内所有选了的点能通过选了的边连通的方案数,而另设 $g_i$ 表示在 $i$ 子树内选点,选了的点间可以仅通过选了的边连通,但 $i$ 不能仅通过选了的边与选了的点的连通的方案数。说白了其实就是 $f_i$ 允许 $i$ 接着选点而 $g_i$ 不允许。此时转移是:
- 第一种情况不变;
- 第二种情况不再对 $f_y$ 贡献,而是对 $g_y$ 做 $2^{sz_y-sz_x-1}(f_x-2^{sz_x})+2^{sz_y-sz_x}g_x$ 的贡献,其中 $-2^{sz_x}$ 是去掉了光选边的情况。
答案即 $f_1+g_1-2^{sz_1}$,这里 $1$ 是钦定的根节点。
:::
## D - P8868 [NOIP2022] 比赛
:::info[统计知识点]
- 数据结构 - 线段树
:::
给定长为 $n$ 的排列 $a,b$。$q$ 次询问,每次给定 $l,r$,求 $\displaystyle\sum_{l\le p\le q\le r}(\max_{i\in[p,q]}\{a_i\})(\max_{i\in[p,q]}\{b_i\})$。
数据范围:$n,q\le 2.5\times 10^5$。
:::success[做法]
完全暴力枚举子区间并暴力找最大值,总复杂度 $O(qn^3)$,期望得分 $8$。如果求区间最大值的时候上个 ST 表,复杂度变为 $O(qn^2)$,但得分没啥区别。
但上述做法难以实现区间合并,也就难以上树维护。考虑另外的容易维护的暴力算法:将询问离线并按 $r$ 的值排序,然后我们记 $f_i$ 为以当前 $r$ 为右端点、$i$ 为左端点的子区间的贡献,则 $f_i=\displaystyle\sum_{j=i}^r(\max_{k\in[j,r]}\{a_k\})(\max_{k\in[j,r]}\{b_k\})$,而询问 $[l,r]$ 的答案就是 $\displaystyle\sum_{i=l}^rf_i$。这种算法每次向右移动 $r$ 时暴力更新各 $f_i$ 的复杂度是 $O(n^2+nq)$,然后把 $f_i$ 挂到树上可以变成复杂度 $O(n^2+q\log n)$ 的单点修改区间求和,得分只有 $20$。
现在就是怎么把 $n^2$ 优化掉。考虑利用每个 $a_i$(为例,$b_i$ 同理)贡献的区间连续的性质,用单调栈预处理每个 $a_i$ 的贡献范围的左端点,就可以首先实现快速维护各后缀的 $\max$ 值。即设 $x_j=\displaystyle\max_{k\in[j,r]}\{a_k\},y_j=\max_{k\in[j,r]}\{b_k\}$,则原询问变为:
- 对 $x$ 进行区间赋值
- 对 $y$ 进行区间赋值
- 将 $f$ 区间加 $x_iy_i
发现这个问题是一个二维历史和,作为完整研读过吉司机线段树原论文但其实啥也没学到的选手当然要申请出战:吉司机讲了一维的历史和,其本质是用矩阵维护区间长度、和和历史和;类比探究一下,用矩阵维护区间长度、\sum x_i 、\sum y_i 、\sum x_iy_i 及该区间历史和,然后根据定义可以得出转移矩阵,这里作者懒得推了(实际上是数学太差)可以去题解区看。
但是部分选手声称其使用这种做法常数太大被做局了,于是我们可以不用矩阵但保留上述思路,即拿标记维护 \sum x_i 、\sum y_i 、\sum x_iy_i 及该区间历史和,并另拿标记维护赋值操作和对区间长度、\sum x_i 、\sum y_i 和 \sum x_iy_i 加的倍数即可。
春季测试 2023
讲这场的原因是很多省份将它作为 NOIP 2022(因为疫情),甚至有传言称这才是真正的 NOIP 2022 试题。
不过统计 22 年知识点构成的时候还是按 NOIP 2022 计算,毕竟这两场强度差得有点大。
送分题不讲。
B - P9118 [春季测试 2023] 幂次
:::info[统计知识点]
给定 n,k ,求 [1,n] 中有多少个整数 x 可以表示为 a^b 的形式,其中 a,b\in\mathbb{N}^+ 且 b\ge k ?
数据范围:n\le 10^{18} 。
:::success[做法]
看数据范围,首先注意到:
暴力是 O(\sqrt[k]{n}\log n) (远不满)的,即 k\ge3 时可以直接暴力。
于是现在唯一的问题是 k=2 。一种思路是直接加个 \sqrt{n} ,但这样显然会算重。
考虑算重的情况是什么样子的。其实就是存在 c=a^p=b^q 的情况。此时如果 a 是最小的底数,则必然有 b=a^k ,因为否则若干个 a 相乘不可能出来一个 a 以外的因数,也就不可能实现 a^p=c 。
于是根据刚才 k\ge3 的算法,从小到大枚举 2\le i\le\sqrt[3]{n} ,若 i 还未标记则标记其在 \sqrt[3]{n} 内的所有幂次并记录其在 (\sqrt[3]{n},\sqrt{n}] 内幂次的个数 s 。则 (\sqrt[3]{n},\sqrt{n}] 内未被计算的数的个数就是 \lfloor\sqrt{n}\rfloor-\lceil\sqrt[3]{n}\rceil-s ,加上刚才暴力的结果即可。
C - P9119 [春季测试 2023] 圣诞树
:::info[统计知识点]
给定平面上一 n 个点的凸多边形。定义一个 1\sim n 的排列 p 的权值为 \sum_{i\in[1,n)}\text{dis}(p_i,p_{i+1}) ,其中 \text{dis}(x,y) 表示第 x 个点和第 y 个点间的欧几里得距离。设 k 为纵坐标最大的点中编号最小的,求所有 p_1=k 的排列中权值最小是多少。
数据范围:n\le 10^3 。
:::success[做法]
这题挺容易读成求最小生成树的。其实是要求以最高点为开头的一条链。
性质是电线不交叉的情况一定更优,可以用三角不等式证。
而题中本来就是按照凸包顺序给的,所以其实每次就是在现有区间往左或往右选。
于是考虑区间 DP,设 dp_{i,j,0/1} 表示考虑区间 [i,j] 且上一个选择了 i/j 的答案。根据状态定义进行转移:
dp_{i,j,0}=\min\{dp_{i+1,j,0}+dis(i,i+1),dp_{i+1,j,1}+dis(i,j)\}\\dp_{i,j,1}=\min\{dp_{i,j-1,1}+dis(j,j-1),dp_{i,j-1,0}+dis(i,j)\}
轮换一下,把最高点转到最左边就行了。复杂度 O(n^2) 。
D - P9120 [春季测试 2023] 密码锁
:::info[统计知识点]
密码锁共有 n 个拨圈,每个拨圈有 k (k \leq 4 )格,其中第 j 个拨圈的第 i 格上的正整数为 a _ {i, j} 。
你可以对每个拨圈拨若干次(也可以不拨),拨第 j 个拨圈一次,则会让第 j 个拨圈上第 i 格的数字移动到第 ((i \bmod k) + 1) 格,其他拨圈不动。
对于 1 \leq i \leq k ,定义密码锁第 i 行的松散度为 \displaystyle c(i) = \max \limits _ {j = 1} ^ n a _ {i, j} - \min \limits _ {j = 1} ^ n a _ {i, j} ,同时定义整个密码锁的松散度为 \displaystyle C = \max \limits _ {1 \leq i \leq k} c(i) 。求最小的 C 值。
:::success[做法]
与 CSP-S2 2023 遥相呼应。但一个 T1,一个 T4。
最值问题与计数问题不同,各板块都有很多算法都可以求解一类特定的最值问题。所以此时我们只能通过题目中给出的提示进一步确定答题方向。我们采用审政治题的思路:
一审设问:
本题要求最大值的最小值。学过二分的同学都知道,“最大值最小”“最小值最大”类问题可能是二分答案。
本题数据范围里 k 很小。由于 n 较大,且 k 的数据点分布与 T2 类似,任意 k\in[2,4] 都有一定量的点,所以较大可能是和 T2 一样对着 k 讨论。
二审材料:
经历了上述过程之后,我们发现:
$k=4$ 与 $k=3$ 区别在于多了一行不确定的值。但不变的是枚举最值所在行后剩下两行的取值集合只有不超过 $4$ 个,而每对取值经过上述转化后可以得到两个区间。由于区间之间有对应关系,将两个区间分开显然是不现实的,于是只能做矩形加,外面套一层容斥来解决重叠(所以最后还是矩形加)。然后你发现这题变成了 [P1502 窗口的星星](https://www.luogu.com.cn/problem/P1502),然后本题就做完了。
以防你没做过扫描线的题:
- 对每个矩形的左右边界找出其纵坐标的范围和权值(左边界记权值,右边界记权值的相反数)。
- 将各边界排序,对纵坐标建立线段树,上述操作就是区间加、区间取 $\max$ 的过程。
- 扫描线题都要注意处理好边界计算的顺序。
---
收录一下最高赞题解@[AL8624](https://www.luogu.com.cn/user/913226) 大佬的做法:
> 考虑枚举每个环并对当前环贪心。这显然是错的。
>
> 但是发现打乱 $600$ 次就很可能对一次。于是打乱 $600$ 次做即可。
>
> 为了避免被卡常 $k\le 3$ 可以只打乱 $300$ 次。
>
> 调整合理的种子后可过。
:::
# CSP-S2 2023
送分题及大模拟不讲。
## B - P9753 [CSP-S 2023] 消消乐
:::info[统计知识点]
- 字符串 - 哈希
:::
给定一个长为 $n$ 的字符串 $s$。我们称一个字符串是可消除的,当且仅当可以对这个字符串进行若干次操作,使之成为一个空字符串。其中每次操作可以从字符串中删除两个相邻的相同字符,操作后剩余字符串会拼接在一起。求 $s$ 中有多少个子串是可消除的。
数据范围:$n\le 2\times 10^6$。
:::success[做法]
注意到这玩意本质上是不分左右的括号匹配,所以两次相同的未匹配栈状态之间的部分必然匹配。
于是用哈希维护当前的栈状态然后开个 `map` 统计一下每种状态多少个然后用组合数在每种状态里选两个所有状态加起来就做完了。
用 `map` 带个 $\log$,换成 `umap` 线性,都能过就是了。
注意空栈和单个 `a` 的区分,即你应该将 `a` 记为 $1$ 而非 $0$。
:::
## D - P9755 [CSP-S 2023] 种树
:::info[统计知识点]
- 其他算法 - 二分答案
:::
给定 $n$ 个点的树,开始时所有点均为空。第 $i$ 天你可以任选一个与已经种树的点有边相连的未种树的点种一棵树,其中第 $1$ 天只能在 $1$ 号点种树。树种下时高度为 $0$,此后第 $x$ 天(这里指整个任务的第 $x$ 天)第 $i$ 个点上的树会生长 $\max\{b_i+xc_i,1\}$ 米。求对于所有 $i$ 均使 $i$ 号点上树高至少为 $a_i$ 所需的最小天数。
数据范围:$n\le 10^5$,答案不超过 $10^9$。
:::success[做法]
对于一个固定的总用时,容易求出每个位置的 ddl(最晚哪一天种植);又注意到总用时有单调性,遂考虑二分。
`check` 时每次找 ddl 最靠前的,把从根结点到该点路径上依次种上树,如果哪次没在 ddl 之前种上就是 `false`,都种上了就是 `true`。
复杂度 $O(n\log n\log V)$。
:::
# NOIP 2023
送分题不讲。
## B - P9869 [NOIP2023] 三值逻辑
:::info[统计知识点]
- 数据结构 - 并查集
:::
有 $n$ 个三值逻辑变量 $x_1,\dots,x_n\in\{T,F,U\}$,$m$ 次操作,操作共三种:
- $v\to x_i$,其中 $v\in\{T,F,U\}$;
- $x_j\to x_i$;
- $\lnot x_j\to x_i$,其中 $\lnot U=U$。
现要通过赋初值使操作后所有变量的最终值与初值相等,求初值中至少包含多少个 $U$。
数据范围:$n,m\le 10^5$。
:::success[做法]
注意到每个位置最终只可能是定值、某个初值或者某个初值取反。故先处理出来每个值的最终状态是什么,然后先处理两种一定是 U 的情况:
- 定值是 U 的;
- 自己初值取反的。
然后再把别的扫一遍,看有没有最终状态是某个初值为 U 的或者某个初值为 U 的取反的,来看自己是不是也需要赋值为 U。
写完发现过不了大样例。调试发现因为可能会间接连到一个初值为 U 的。例如依次有 $x_9\to x_2,x_{10}\to x_9,U\to x_{10}$ 三种操作,则你只确定了 $x_9,x_{10}$ 为 U,而没能确定出 $x_2$ 为 U。
发现将这种关系改为并查集维护,将 $x_i$ 与 $x_i$ 取反分成两个点即可(其他实现也没问题,重点在你写的时候保持思路清晰)。复杂度视并查集的实现而定,$O(n\log n)$ 即可过题。
:::
## C - P9870 [NOIP2023] 双序列拓展
:::info[统计知识点]
- 其他算法
:::
若能将一个序列的每个元素分别重复正整数次,得到另一个序列,则称后者是前者的拓展。给定两个序列 $X,Y$,需要判断能否分别将它们拓展为长度均为 $10^{100}$ 的序列 $F,G$,使得所有位置上的差 $f_i-g_i$ 均严格同号。初始时需要回答一次,之后还有 $q$ 次独立询问,每次会修改 $X,Y$ 中若干元素的值,修改后再次判断是否存在满足条件的拓展。
数据范围:$n,m\le 5\times 10^5$,$q\le 60$,所有询问涉及的修改总数不超过 $5\times 10^5$。
:::success[做法]
读题,题中给的合法的定义其实就是拓展完后一个偏序另一个。不妨设 $\forall i,x_i<y_i$,反之可以交换 $x$ 和 $y$(根据语言基础时期讲的“指针可以当成数组名”知可以定义两个指针从而实现 $O(1)$ 交换),一些题解里巧妙地选择了将 $x$ 与 $y$ 同乘 $-1$ 也是很好的。
手玩大样例发现题意又可以视为 $x$(或者 $y$,合法情况至少有一个可以)中的一个元素匹配 $y$ 中的一段然后反过来 $y$ 的下一个元素匹配 $x$ 中一段,直至两边都匹配完。显然有暴力 DP:设 $dp_{i,j}$ 表示 $x_1\dots x_i$ 匹配 $y_1\dots y_j$,直接 $O(1)$ 地往下一项转移即可,单组复杂度 $O(n^2)$。
>实际上由于这个 dp 状态维度过高且难以优化,自然可以考虑贪心。
>
>:::align{right}
>——@[_yjh](https://www.luogu.com.cn/user/222104)
>:::
我们枚举 $x_i$,同时维护一个指针 $p$ 维护当前 $x_i$ 可匹配到的右边界,如果 $x_i<x_{i-1}$ 则范围会变大,向右移动 $p$ 直至不合法或到边界;反之向左移动 $p$ 直至该边界合法即可。若最后 $p$ 能移到右端点则可以,否则不行。证明略去。
移动指针的过程可以线段树上二分优化到 $1\log$。还没试,有卡常大哥哥可以写一发,据说本题 $O(qn^2)$ 都能跑 $70$。
综合上述做法与特殊性质的提醒,不难想到关注最小值的位置。注意到只有前缀最小值会使指针往右移动,故两前缀最小值之间的部分只需要看最大的会不会跑到最左边。
然后将序列按全局最小值分开前一半跑一遍后一半倒着跑一遍就做完了。
:::
## D - P9871 [NOIP2023] 天天爱打卡
:::info[统计知识点]
- 数据结构 - 线段树优化 DP
- DP - 线段树优化 DP
:::
大 Y 计划在 $n$ 天内进行跑步打卡,初始能量为 $0$,每打卡一天能量减少 $d$,且能量可以为负数。他不能连续打卡超过 $k$ 天。另有 $m$ 个挑战,第 $i$ 个挑战由 $(x_i,y_i,v_i)$ 描述:若第 $x_i$ 天结束时已经连续打卡至少 $y_i$ 天,则能量增加 $v_i$。求试运行结束后能够获得的最大能量值。
数据范围:多测,$T\le 10$,$n\le 10^9$,$m\le 10^5$,$1\le d,v_i\le 10^9$。
:::success[做法]
纪念下第一次独立想出线段树优化 DP。难度评分也主要是线段树优化 DP 带起来的。
数据范围已经提示了让你把挑战看成区间。显然不浪费打卡天数的方式必然是打卡若干段,每段是从某个挑战的左端点到某个(不一定和前面相同)的挑战的右端点之间的所有点。
设 $dp_{i,j}$ 表示考虑到 $r_i$ 且 $[l_j,r_i]$ 进行打卡,可以暴力转移,复杂度 $O(m^2)$。
考虑优化。对于一个 $r_i$ 考虑所选的 $l_j$,则显然此时满足 $l_j\le r_i$ 的 $j$ 分为三段:
- $l_j\in[1,r_i-k]$:这些起点无法一直打卡到 $r_i$,不能转移。
- $l_j\in(r_i-k,l_i]$(如果有):这些起点可以一直打卡到 $r_i$,且可以达成挑战 $i$。
- $l_j\in(max\{l_i,r_i-k\},r_i]$:这些起点可以一直打卡到 $r_i$,但不能达成挑战 $i$。
这里视频漏掉的一个点是 $l_i$ 上值的更新问题,视频里直接就说拿 $dp$ 值了,实际上为了正确计算消耗应该对所有 $l_i$ 和 $r_i$ 放在一起排序,每段更新一次后两类区间的消耗,然后对于每个 $r_i$ 再把第二段加上第 $i$ 个挑战的贡献,这样才能准确统计答案。
最终答案对所有的 $dp_i$ 取 $\max$。复杂度 $O(m\log m)$。
:::
# CSP-S2 2024
送分题不讲。
## B - P11232 [CSP-S 2024] 超速检测
:::info[统计知识点]
- 其他算法 - 贪心
:::
一条长度为 $L$ 的道路上有 $n$ 辆车,第 $i$ 辆车从位置 $d_i$ 驶入,以初速度 $v_i$、加速度 $a_i$ 向前行驶。道路上设有 $m$ 个测速仪,位置为 $p_i$,每个测速仪可以开启或关闭。当车辆经过开启的测速仪且瞬时速度超过限速 $V$ 时,该车被判定为超速。求所有测速仪开启时被判定为超速的车辆数量,以及在不漏掉任何此时会被判定为超速的车辆的前提下,最多可以关闭多少个测速仪。
数据范围:$T\le 20$,$n,m\le 10^5$,$L\le 10^6$,$V\le 10^3$,$v_i\le 10^3$,$|a_i|\le 10^3$。
:::success[做法]
第一问他甚至没舍得让你离散化($L\le 10^6$)。直接对探头做个前缀和,用公式求出每辆车的超速区间即可。
第二问先找到所有有探头的区间并按左端点排个序,如果一个区间包含另一个则这个区间显然是没有用的(因为另一个里显然得包含一个探头,那这个肯定也就包含该探头)于是去掉这种的之后右端点也自动排好序了。然后从左往右枚举区间,每次贪心地找区间内最靠右的探头(如果这个区间已经选过探头了就跳过)来覆盖尽可能多的区间然后就做完了。
写代码的时候仔细点要不然一些小的 corner case 极其难调。本人考场上调了 3h 最终喜提没时间做 T3 了。
:::
## C - P11233 [CSP-S 2024] 染色
:::info[统计知识点]
- DP - 普通 DP
:::
给定长度为 $n$ 的正整数数组 $A$,需要将每个元素染成红色或蓝色。对于每个元素 $A_i$,若其左侧不存在与它同色的元素,或者左侧距离它最近的同色元素的值不等于 $A_i$,则令 $C_i=0$;否则令 $C_i=A_i$。求所有元素染色后,$\sum_{i=1}^n C_i$ 的最大值。
数据范围:多测,$T\le 10$,$n\le 2\times 10^5$,$1\le A_i\le 10^6$。
:::success[做法]
设 $dp_{i,0/1}$ 表示考虑到第 $i$ 个数且该数染红色/蓝色的答案。
则如果不想让 $i$ 贡献直接从 $i-1$ 转移,反之一定是取上一个与 $a_i$ 相同的数最优,设该数位于 $lst$,则贡献分为:
- $a_i$ 的贡献。
- $[1,lst+1]$ 的贡献。这部分直接取 $dp_{lst+1}$ 的最大值即可。
- $[lst+2,i-1]$ 的贡献。这部分是同色的,可以使用前缀和进行优化。
总复杂度 $O(n)$。
:::
## D - P11234 [CSP-S 2024] 擂台游戏
:::info[统计知识点]
- 其他算法
:::
小 S 举办一场擂台赛,共有 $2^k$ 名选手,按固定的淘汰赛顺序进行 $k$ 轮比赛。每场比赛通过抽签决定编号较小或较大的选手作为擂主,第 $R$ 轮的擂主当且仅当其能力值 $a\ge R$ 时获胜。现有 $n$ 名选手按报名顺序编号为 $1\sim n$,需要补充尽量少的选手,使总人数成为 $2$ 的整数次幂,补充选手的能力值可以任意选择。对于每次询问 $c_i$,求仅考虑前 $c_i$ 名报名选手时,所有可能成为冠军的选手编号之和。最终按询问顺序输出各答案乘以对应询问编号后的异或和。
数据范围:$2\le n,m\le 10^5$,$T\le 256$,选手能力值及相关参数均小于 $2^{31}$。
:::success[做法]
下称题目中补充的选手为“自由人”。
### 暴力算法
分别钦定每一个人赢,然后试图构造这样的方案。
思考两个问题。
首先:**规则中有什么值得注意的点?**
- 我们发现,虽然是擂台游戏,但胜负与攻擂者居然无关。这意味着,题中判断胜负的方式很可能具有某种特殊性质。
从写暴力的角度,为了判断胜负,我们提出第二个问题:**如果在某一回合中,一个选手与自由人对阵且自由人是擂主,是否可以通过控制自由人的权值来决定谁上?**
- 一定可以。这个其实乍一看感觉很有问题,因为这可能影响到其上升路径;但实际上可以分类讨论,假设我要送对面上:
- 如果上升路径中某一轮次是自由人当擂主,则由于获胜该轮比获胜我们刚才说的那轮的要求能力值低,所以一定存在这样的赋权值方法;
- 如果上升路径中某一轮次是自由人对面当擂主,则由于结果与该自由人无关所以赋什么权值自然也不影响。
这里暴力的算法就出来了:
- 枚举每个人并钦定他赢;
- 模拟各个对局,如果当前结果确定(两个自由人或者擂主不是自由人),则直接模拟;如果不确定,则如果对面不是钦定的赢家就让自由人上,反之让对面上。
总复杂度 $O(Tmn^2)$。
### 优化一点
最明显的优化方向就是最后那个 $n^2$。要不然绕开枚举每个人,要不然快速求出每个人。
- 绕开枚举每个人的过程:记录所有可能到达当前位置的人,这样一遍 $O(n\log n)$ 就能搞定。
- 加速求出每个人的过程:其实对一个人有影响的只有他经过的 $O(\log n)$ 条路径,其他位置的信息可以复用。
无论怎么搞,至少我们可以实现 $O(Tmn\log n)$ 的优秀复杂度了。
### 优化至 $1\log
感觉这题到现在给做死了,因为对于不同的询问,不管我们刚才采用什么样的优化方式,都会导致整个游戏过程被改变,所以难以快速地对询问进行更新。
于是剩下唯一的优化空间似乎是 m 这里。
而这个方向上,题中给出的询问每次都是一段前缀,似乎能以此入手……?
于是我们一厢情愿地希望,一个人只在 c 在一段范围内时可能获胜。
考虑二叉树形态完全相同,即 [2^k+1,2^{k+1}] 内的所有前缀中,最终的胜者会如何随前缀取值而变化。容易入手的情况是自由人获胜,这时显然的前缀越短自由人越容易上,所以最终自由人可能登顶的前缀长度肯定是有一个上界的。
考虑将二叉树加高一层时的情况。如果一非自由人能到达该层(显然此时该层左子树内必然已经没有自由人)且擂主是对面,则看对面的情况:如果对面必然上来一个非自由人时(此时谁上来是定死的)我照样能赢那显然我能赢的区间是对面一整个;反之就只能是能使对面上来自由人的一段前缀。
至此,在扫前缀的过程中,我们就可以求出每个人所贡献的前缀区间是谁,这个过程的总复杂度是 O(Tn\log n) 。
优化至线性
这里出现 \log 的原因显然是在枚举前缀的过程中自底向上走了一条长度为树高的路线,所以考虑能不能实现自顶向下,因为结点总数是 n 级别的。
考虑不再针对个人处理,而是对于每个子树,处理其在什么时候开始会有一个确定的胜者。这个过程中由于每个点只会走一遍(每个比赛只会有一人胜出并进入下一层),所以总复杂度其实是 O(n) 的。然后自顶向下根据预处理的信息,依照上述思路进行下传即可完成本题,复杂度 O(Tn) 。
启示
在看到一些比较特殊的条件时,我们应该试着寻求更加简洁的算法。
对于在变化的过程中计算贡献的问题,我们应该试着找到答案随着条件变化的方式。
NOIP 2024
A - P11361 [NOIP2024] 编辑字符串
:::info[统计知识点]
给定两个长度为 n 、仅包含 0 和 1 的字符串 s_1,s_2 。另给出两个限制字符串 t_1,t_2 ,其中 t_{j,i}=1 表示 s_j 的第 i 个字符可以参与交换,t_{j,i}=0 表示不能参与交换。可以在任一字符串中多次交换两个相邻且允许参与交换的字符,求操作后两个字符串对应位置字符相同的数量的最大值。
数据范围:多测,T\le 10 ,n\le 10^5 。
:::success[做法]
考虑贪心,能匹配就匹配,因为我匹配这个最多只会导致另外一个不能匹配,肯定不亏。
倒着扫两个串,预处理出各可编辑连续段中 0 和 1 的数量,这样第二遍扫的时候一边扫一边能实时维护当前还有多少个 0/1 可以换。然后就做完了,复杂度线性。
B - P11362 [NOIP2024] 遗失的赋值
:::info[统计知识点]
有 n 个变量 x_i\in[1,v] 。对于每个 i<n ,存在一条二元限制:若 x_i=a_i ,则要求 x_{i+1}=b_i ,否则不限制 x_{i+1} 。此外还有 m 条一元限制 x_{c_j}=d_j 。现在所有 a_i,b_i 的值都已遗失,只知道一元限制,并要求统计有多少种 (a_i,b_i) 的取值组合能够使这些限制至少存在一种满足条件的变量赋值方案,答案对 10^9+7 取模。
数据范围:多测,T\le 10 ,n\le 10^9 ,m\le 10^5 ,v\le 10^9 。
:::success[做法]
容易注意到不存在赋值方式的情况一定是两个一元限制之间的二元限制使得一元限制不能同时满足。这种情况下设这两个一元限制分别是 (c_1,d_1) 和 (c_2,d_2) ,则上述情况用数学语言表达就是:
也就是对于 i\in[c_1,c_2) ,只有 a_{c_1+1},\dots,a_{c_2-1} 是可以在 [1,v] 内任选的。而这段内全部的情况是,a_{c_1},\dots,a_{c_2-1} 和 b_{c_1},\dots,b_{c_2-1} 中所有的值都任选。减一下搞定一段,各段相乘搞定全局。复杂度由于有快速幂带个 \log 。
C - P11363 [NOIP2024] 树的遍历
:::info[统计知识点]
给定一棵有 n 个结点的树,将每条原边视为一个新结点,两条新结点对应的原边若有公共端点,就视为相邻。选择一条关键边作为起始边,按深度优先搜索的方式遍历所有边,并在每次第一次访问新边时连接对应的新结点与上一条边对应的新结点,最终得到一棵新树。给定 k 条关键边,求以任意一条关键边为起始边时能够生成的不同新树的数量,答案对 10^9+7 取模。
数据范围:多测,T\le 10 ,n\le 10^5 ,1\le k<n 。
:::success[做法]
这题整体的难度也不是很大。找到关键性质后整道题会变得很简单。
首先考虑 k=1 怎么做。
发现对于一个点,不同的遍历儿子的顺序必然导致生成 DFS 树的改变 ,因为根据题中定义一个点除了第一个遍历到的儿子连父亲之外都是其他都是连兄弟的。所以答案是 \prod(d_i-1)! ,其中 d_i 是度数(减一因为去掉父亲)。
但显然不是树上所有点都能生成这棵树,所以我们需要探究哪些点能生成这棵树。
鉴于学校机器的优秀性能(我在写这段文字的时候操作的平均延迟目测在 $100$ ms),我们去题解里偷张图来讲:
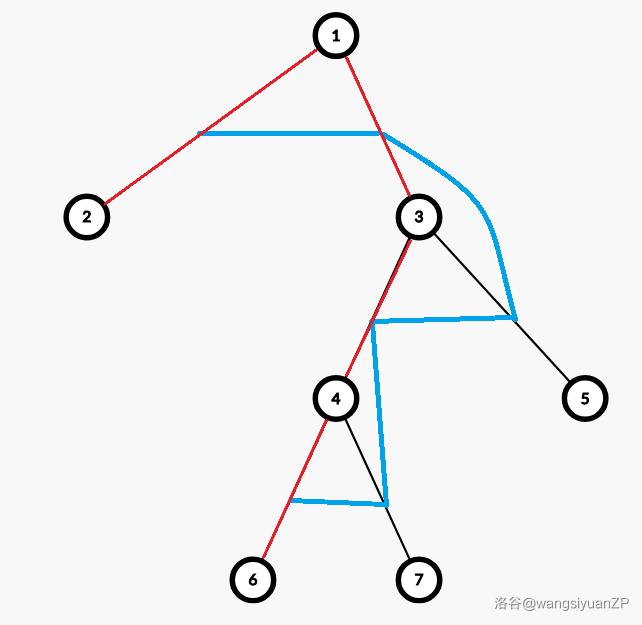
其中,蓝色边是新生成的树,红色边是可能作为根节点的原始边。
其实图都偷来了接下来的步骤就一样了。因为这个红边边集构成的链实在显眼,所以我也没法讲出朵花来,就是大胆猜想可能的根节点一定恰好是一条从原树的叶子到叶子的链。题解的证明是:
>证明也很简单,考虑一个点周围的所有黑边,这些边内部的蓝边一定是一条链,而只有链的两个端点可以作为根的方向。
要是想不明白或者考场上证不出来,你其实可以画一个三元环作为新图(对应原图是 $n=4$ 的菊花)并任取其中两条边得到一个可能的生成树,然后注意到未被选中的边两端点才能生成这棵树,于是你就理解上面那句话怎么证的了。(~~别说有时候感性理解还挺好用的~~)
于是当新图生成树形态确定的时候,这条链也就确定了,只要链上有关键边这棵生成树就贡献。而一条链可能对应多棵生成树,具体来说式子是:
$$\dfrac{\prod (d_i-1)!}{\prod (d_v-1)}$$
$v$ 是链上的点,且忽略 $d_v=1$ 的 $v$。也就是链上的点由于要保持链形态,而不能接着任选顺序了。
于是现在要快速统计所有有关键边的链的贡献。于是计数题七字真言又来了。设 $dp_{i,0/1}$ 表示走到第 $i$ 个点,当前是否有关键边的方案数,对着上面式子直接转移即可。
:::
## D - P11364 [NOIP2024] 树上查询
:::info[统计知识点]
- 数据结构 - 线段树
:::
给定一棵以 $1$ 为根的有根树,定义结点 $u$ 的深度为从根到 $u$ 的路径上的结点数量,并定义 $\operatorname{LCA^*}(l,r)$ 为编号在区间 $[l,r]$ 内所有结点的最近公共祖先。每次询问给定 $l,r,k$,求区间 $[l,r]$ 内所有长度至少为 $k$ 的连续子区间中,其 $\operatorname{LCA^*}$ 深度的最大值。
数据范围:$n,q\le 5\times 10^5$,$1\le l\le r\le n$,$1\le k\le r-l+1$。
:::success[做法]
介绍一个我比较喜欢的做法。本题题解区里 @[Rainbow_qwq](https://www.luogu.com.cn/user/151935) 老师发了这种做法。
题外话:喜欢这个做法的原因是,其实考前我一直在看一些线段树节点上维护比较复杂的信息的题目,所以考场上试图想这种做法来着,但没发现性质最终倒闭了。然后一出场看到 @[Rainbow_qwq](https://www.luogu.com.cn/user/151935) 老师的题解当时就崩了,立刻发给(机构的)教练,教练一通电话就过来了,于是我们又对着这题聊了近 $1$ h 才搞定。
首先容易注意到点多了 LCA 深度是不会下降的,所以长度恰好为 $k$ 就是最优的。
性质:**对于 $k\ge 2$ 的询问($k=1$ 的直接搞个线段树什么的维护下区间 $\max$ 就行),区间 LCA 的深度其实就是区间内相邻两点 LCA 深度的最大值**。这个学过虚树后可以知道。
于是问题转化为全局每相邻两数取一次 $\min$,并查询区间最值的最值。
维护所有的同深度连续段。分析一次邻数合并时一段的长度变化。显然只会在两段交界处发生变化,较小的吃较大的。于是小于两边的长度每次加 $1$,大于两边的每次减 $1$,一边大一边小的不变。然后每次段数出现变化就是在当前减 $1$ 的最短段消失时,由于最多就 $n$ 段所以直接用一个类链表的结构,维护每段两侧是谁就能快速删除。查询时线段树上二分一下即可。
:::
# CSP-S2 2025
## A - P14361 [CSP-S 2025] 社团招新 / club
:::info[统计知识点]
- 其他算法 - 贪心
:::
小 L 招收了 $n$ 名新成员,需要将他们分配到算法协会的三个部门。第 $i$ 名成员对第 $j$ 个部门的满意度为 $a_{i,j}$,分配方案的满意度为所有成员对应满意度之和。为了避免某个部门人数过多,要求每个部门分配到的成员数量均不超过 $\frac n2$。求满足要求的分配方案的最大满意度。
数据范围:多测,$T\le 5$,$n\le 10^5$ 且 $n$ 为偶数,$0\le a_{i,j}\le 2\times 10^4$。
:::success[做法]
注意到最多只会有一个社团爆掉。
于是先让每个人去自己最喜欢的,此时多余的人可以任意调剂到另两个社团而不会使它们爆掉。
所以多余的人都可以安排到自己第二喜欢的里面。于是按最喜欢的减第二喜欢的从小往大选调剂的人。
复杂度 $O(n\log n)$ 每组。
---
当你在坚持和放弃间飘摇不定的时候,也许你就会和刚才被我们调剂的那些人一样,被命运调剂。
他们不是无辜的,因为他们的意志不够坚定。所以,寄希望于下一把能考好,也许会带来转机……?
>我们所可以自慰的,想来想去,也还是所谓对于将来的希望。
>
>希望是附丽于存在的,有存在,便有希望,有希望,便是光明。
:::
## B - P14362 [CSP-S 2025] 道路修复 / road
:::info[统计知识点]
- 图论 - 最小生成树
:::
C 国原有 $n$ 座城市和 $m$ 条双向道路,所有城市原本互相连通,但地震损坏了全部道路。修复第 $i$ 条道路的费用为 $w_i$。另有 $k$ 个待改造的乡镇,改造第 $j$ 个乡镇需要花费 $c_j$,改造后可以在该乡镇与任意原有城市之间修建道路,连接城市 $i$ 的费用为 $a_{j,i}$。可以选择改造任意多个乡镇,并决定修复或新建哪些道路。求使所有原有城市重新互相连通的最小总费用。
数据范围:$n\le 10^4$,$m\le 10^6$,$k\le 10$,所有费用均不超过 $10^9$。
:::success[做法]
注意到直接贴板子有 $48$ pts($k=0$ 及性质 A)。
外层对 $k$ 枚举子集,则内层变成了能贴板子的情况,复杂度 $O(nk2^k\log m)$,保守估计有前 $20$ 个点,也就是 $80$ 分。
注意到 $n$ 小得不太正常。于是注意到先不考虑 $k$ 个额外点跑最小生成树然后再套上面的做法可以降到 $O(nk2^k\log n)$,常数减半。
此时除了把 $\log n$ 变成 $\alpha(n)$(排序常数很小其实可以不计的)外唯一的优化空间在 $k2^k$ 上。发现对于一种情况可以每加入一个新点跑一遍从而减少重复计算,上述优化全安上去是 $O(n2^k\alpha(n))$ 的,差不多就过了。
---
并查集合并的正确姿势是:
```cpp
inline void merg(ll x,ll y){
fa[fnd(x)]=fa[y];
}
```
**不是**:
```cpp
inline void merg(ll x,ll y){
fa[x]=fa[y];
}
```
下面的这段会把 $x$ 的子树分裂出来合并到 $y$ 上。
然后我试图检查并查集是否写错,检查的方式是加了一行 `assert(fnd(q[j].u)==fnd(q[j].v));`。
废话 `q[j].u` 的子树都分裂出来合并上去了当然查不出来啊!!!
:::
## C - P14363 [CSP-S 2025] 谐音替换 / replace
:::info[统计知识点]
- 字符串 - 哈希、trie
- 数据结构 - 二维数点
:::
给定 $n$ 个字符串二元组 $(s_{i,1},s_{i,2})$,每个二元组中的两个字符串长度相同。对一个字符串,可以选择一个子串,若其恰好等于某个 $s_{i,1}$,就将该子串替换为对应的 $s_{i,2}$。现在有 $q$ 次询问,每次给定两个不同的字符串 $t_{j,1}$ 和 $t_{j,2}$,求将 $t_{j,1}$ 经过一次替换得到 $t_{j,2}$ 的方法数。若替换位置或使用的字符串二元组不同,则视为不同的方法。
数据范围:$n,q\le 2\times 10^5$,规则字符串和询问字符串的总长度分别不超过 $5\times 10^6$。
:::success[做法]
其实 ACam 也可以做(且我考场上想出来了),但我整个字符串技能树就点了哈希,外加 ACam 超纲了,所以我们讨论比较正常的做法。
首先的首先,**由于 $\forall i,|s_{i,1}|=|s_{i,2}|$,所以 $|t_1|\neq|t_2|$ 时答案必然为 $0$**。
首先不要读错题,一共只准换一次。
然后开始瞪样例,注意到 `bc->de` 和 `xabcx->xadex` 的共同点都是 `bc->de`,容易发现其实可以选的二元组一定是不同处仅包含 `bc->de` 且 $s_{i,1}\subset t_1$ 的。
也就是说,若我们称两个字符串去掉两边相同部分后为交换的**本质**,例如 `xabcx->xadex` 的**本质**是 `bc->de`,则只可能是**本质**相同且 $s_{i,1}\subset t_1$ 的 $(s_{i,1},s_{i,2})$ 可选。
于是我们需要找“**本质**相同”和“$s_{i,1}\subset t_1$”两个条件。
前者容易想到将**本质**做哈希。
后者如果将前者筛出的字符串拎出来判断就完蛋了,复杂度是 $O(nq)$ 的。但是发现本题空间 2GB,联赛字符串算法还要大空间的只有可能是 trie,于是考虑对 $s$ 中的每种**本质**中**本质**前及**本质**后的部分建 trie,于是询问就变成查询两边 trie 上都是当前点(询问串**本质**前后的部分)的祖先有几个,把 trie 拍成 dfs 序就变二维数点了。
:::
## D - P14364 [CSP-S 2025] 员工招聘 / employ
:::info[统计知识点]
- DP - 普通 DP、推式子
:::
小 Z 和小 H 希望从 $n$ 名应聘者中录用至少 $m$ 人。面试共进行 $n$ 天,每天面试一人,面试顺序由一个排列 $p$ 决定。第 $i$ 天的面试题难度为 $s_i\in\{0,1\}$:若 $s_i=0$,无人能答对;若 $s_i=1$,所有人都能答对。每名应聘者 $i$ 的耐心上限为 $c_i$,若在其面试前已经有不少于 $c_i$ 人被拒绝或放弃面试,则其会放弃面试。求能使录用人数至少为 $m$ 的排列数量,对 $998244353$ 取模。
数据范围:$n\le 500$,$1\le m\le n$,$0\le c_i\le n$。
:::success[做法]
看到计数题这个数据范围直接可以考虑 DP。下设 $pre_i$ 表示 $c_j<i$ 的 $j$ 个数,$t_i$ 表示 $c_j=i$ 的 $j$ 个数。
设 $dp_{i,j,k}$ 表示前 $i$ 个人中有 $j$ 个没录上,$1\le l\le i$ 中有 $k$ 个 $c_l\le j$ 的,则考虑第 $i+1$ 天,若 $s_{i+1}=1$,讨论该天是否录用新的人:
- 如果录用,则在还没用掉的人里选一个就行,即 $n-pre_j+1>i-k$ 时有 $dp_{i,j,k}\to dp_{i+1,j,k}$。
- 如果不录用,则第二维的值要 $+1$,此时枚举 $l\in[0,t_{j+1}]$ 为 $i$ 及以前 $c=j+1$ 的人数,有方程:
$$dp_{i,j,k}\times(pre_j-k)\times\text{C}_{t_{j+1}}^l\times\text{C}_{i-k}^l\times l!\to dp_{i+1,j+1,k+l+1}$$
其中 $\times(pre_j-k)$ 即从第 $i+1$ 天会没耐心的人中选一个,$\times\text{C}_{t_{j+1}}^l$ 即选出 $l$ 个 $c=j+1$ 的人,$\times\text{C}_{i-k}^l$ 选出这 $l$ 个人在前 $i$ 个人里的位置,最后 $\times l!$ 计算他们的排列顺序。
类似的,对于 $s_{i+1}=0$ 的情况,有方程:
$$dp_{i,j,k}\times(pre_{j+1}-k-l)\times\text{C}_{t_{j+1}}^l\times\text{C}_{i-k}^l\times l!\to dp_{i+1,j+1,k+l+1}$$
此时对于被毙掉的选手恰好是 $c=j+1$ 的情况额外判一下即可。
看上去是 $O(n^4)$ 的,但实际上受制于 $\sum t_j=n$,内三层只有 $O(n^2)$,总复杂度为 $O(n^3)$。
:::
# NOIP 2025
菜,就要多练。
其实大家讲得已经很不错了,这里补上去纯粹是因为缺一块有点难看(?)。
## A - P14635 [NOIP2025] 糖果店 / candy(官方数据)
:::info[统计知识点]
- 其他算法 - 贪心
:::
小 X 售卖 $n$ 种糖果,每种糖果均有无限颗。对于第 $i$ 种糖果,购买第奇数颗的价格为 $x_i$ 元,购买第偶数颗的价格为 $y_i$ 元。小 R 有 $m$ 元钱,且不关心糖果种类,只希望购买尽可能多的糖果。求最多能买到多少颗糖果。
数据范围:$n\le 10^5$,$m\le 10^{18}$,$1\le x_i,y_i\le 10^9$。
:::success[做法]
注意到 $m$ 特别大,容易想到会大量买 $x_i+y_i$ 最小的情况。
从此出发发现一种糖买两个的话这样显然是最便宜的,但可能出现其他糖买一个更便宜的情况。于是我们想到先买这些单个便宜的,再成对买 $x_i+y_i$ 最小的,此时最多还能买一个(因为能买两个刚才就买完了),能买就买一下。
然后发现样例 $6$ 少了 $1$。
然后发现其实单买的时候少买一个可能就能多买一对。由于单买的每两个平均性价比都不低于成对买的,所以最多只需要反悔最后一个。
小细节:注意判掉买单个的时候钱就花完了的情况。
复杂度 $O(n\log n)$,瓶颈在排序。
:::
## B - P14636 [NOIP2025] 清仓甩卖 / sale(官方数据)
:::info[统计知识点]
- DP - 普通多维 DP
:::
商店有 $n$ 颗糖果,第 $i$ 颗糖果原价为 $a_i$ 元。每颗糖果的清仓价可以独立设置为 $1$ 元或 $2$ 元,其性价比定义为 $\frac{a_i}{w_i}$。小 R 按性价比从高到低购买,预算不足时跳过当前糖果;若性价比相同,则原价较高者优先,若原价也相同则编号较小者优先。求所有 $2^n$ 种定价方案中,能使小 R 按上述策略购买到的糖果原价总和达到最大值的方案数量,答案对 $998244353$ 取模。
数据范围:多测,单组 $n\le 5000$,所有测试数据的 $n$ 之和不超过 $5\times 10^4$,$1\le m\le 2n-1$,$1\le a_i\le 10^9$。
:::success[做法]
火药味已经上来了。感觉严格难于 employ。场上 $n^3$ 拼炸了。
首先 B 性质给了一个很强的提示。在性质中任何 $w=2$ 的排序都在 $w=1$ 的之后,所以唯一一种不合法的可能,就是我最后剩下 $1$ 块钱,但把最便宜的 $w=1$ 的换成没买的最贵的 $w=2$ 的会更优。
而有无 B 性质的差别就是没有性质 B 的时候 $w=2$ 后面还可能有 $w=1$,这时剩下的那一块钱会买到这段 $w=2$ 后的那个 $w=1$,此时要求的就是两个 $w=1$ 的原价和小于 $w=2$ 的那个。于是我们找到了不合法的情况的特征。这里为了方便,如果剩一块钱的时候后面没有 $w=1$ 了(即上面 B 性质中的情况)则第二个 $w=1$ 的原价视为 $0$。
所以不难想到的是设两个 $w=1$ 分别是 $i,j$,$w=2$ 的是 $k$,将**原价升序**排序(注意一下以防后面没法理解式子)后直接枚举 $i<j<k$,此时我们要求在 $j$ 之后的所有物品总共花 $m-2$ 块钱,其中 $k$ 花两块钱,所以这里方案数是 $\text{C}_{n-j-1}^{m-(n-k)-2}$。然后 $i$ 之前的价格是任意的所以再乘 $2^{i-1}$。
加上最后一块钱浪费掉的情况(也是 $\text{C}_{n-j-1}^{m-(n-k)-2}$ 种),一个 $n^3$ 的做法就完成了。
考虑优化。我们发现如果 $j,k$ 定下来那么合法的 $i$ 一定是一段前缀。那就是对着各段前缀求一个和,然后把 $\text{C}_{n-j-1}^{m-(n-k)-2}$ 提出来,即设前缀为 $[1,I]$ 则这组 $j,k$ 为 $2^{I}\text{C}_{n-j-1}^{m-(n-k)-2}$。
但我们还需要求 $I$ 的值。
好消息是对于同一个 $k$,当 $j$ 增大即我们买的另一个商品原价变大时,满足 $a_i+a_j<a_k$ 的 $a_i$ 的范围显然会变小(这就是为什么我们刚才没按性价比排序),于是 $j$ 整个扫过来 $I$ 就只要移动 $n$ 格。然后按上面式子算出答案就可以 $O(n^2)$ 解决了。
:::
## C - P14637 [NOIP2025] 树的价值 / tree(官方数据)
:::info[统计知识点]
- DP - 树形 DP,数据结构优化 DP
- 数据结构 - 数据结构优化 DP
:::
给定一棵以 $1$ 为根的有根树,保证树高不超过 $m$。为每个结点赋一个非负整数权值,设 $S_i$ 为结点 $i$ 的子树中所有结点权值构成的集合,定义树的价值为 $\sum_{i=1}^n \operatorname{mex}(S_i)$,其中 $\operatorname{mex}(S)$ 表示集合中未出现的最小非负整数。求所有权值赋值方案中树的价值的最大值。
数据范围:多测,$T\le 5$,$n\le 8000$,$m\le \min(n-1,800)$。
:::success[做法]
首先每个数是贡献到其自身到根的路径上的,所以显然不能祖孙填相同的数。进一步的,不会有祖先比子孙的数小。
然后硬做的方案是每个点设置成子树内 $\text{mex}$。但手玩发现这样容易被做局,所以我们需要拿出一些点来给上面做贡献。我们定义它们为白点,给自己做贡献的是黑点。于是白点贡献的就是其祖先中的第一个黑点。
做到这里有暴力 DP:设 $dp_{u,i,j}$ 为 $u$ 子树内 $\text{mex}=i$ 且留了 $j$ 个白点的最大答案。合并儿子直接按照状态定义即将 $dp_{v_1,i_1,j_1}$ 与 $dp_{v_2,i_2,j_2}$ 合并到 $dp_{u,max\{i_1,i_2\},j_1+j_2}$。
然后从后往前递推,从 $dp_{u,i,j}$ 转移到 $dp_{u,i+1,j-1}$ 来完成消耗白点并提升 $u$ 的 $\text{mex}$ 的情况。
然后参考上面的转移过程我们会发现一个更加惊为天人的性质:每个黑点 $\text{mex}$ 最大的儿子必然是黑的!我们定义其为“重儿子”,则题目变成了一个类似于重链剖分的东西。而根据刚才的贡献原则,每个点的贡献则是从它到根之间最长重链的长度。
于是我们将这个长度丢到状态上维护起来,设 $dp_{u,i}$ 为**链顶** $u$ 到根最长重链长度为 $i$ 的答案。转移时枚举链的底端,贡献就是从链上点的轻儿子贡献过来。由于第二维是最长重链的长度所以可以每层开线段树进行维护来实现 $1\log$ 的转移,外加状态数只有重链所以是 $nm$,相乘得到复杂度就是 $O(nm\log n)$ 了。
:::
## D - P14638 [NOIP2025] 序列询问 / query(官方数据)
:::info[统计知识点]
- 数据结构 - ST 表,单调队列
:::
给定长度为 $n$ 的整数序列 $a$,每次询问给出 $L_j,R_j$。若区间长度在 $[L_j,R_j]$ 内,则称其为极好区间,区间权值为区间内所有元素之和。对于每次询问,求每个位置 $i$ 所在的极好区间的最大权值 $k_i$,并输出 $\bigoplus_{i=1}^n ((i\times k_i)\bmod 2^{64})$,其中 $\oplus$ 表示按位异或。
数据范围:$n\le 5\times 10^4$,$q\le 1024$,$|a_i|\le 10^5$。
:::success[做法]
这里讲倍增分块,私以为这是最好理解的。
首先 $L=R$ 时此题为滑动窗口板子。但 $L\neq R$ 时不能再对着每个区间维护了,但首先我们发现可以滑动窗口求出以某个点为右端点的极好区间的最大值。尽管区间个数是 $O(n)$ 了,但我们不可能只考虑这些区间,因为无法保证贡献给每个点的区间都一定是其右端点可能取到的最值。
考虑在二维平面上刻画问题,用点的横纵坐标表示区间的左右端点。则点 $i$ 的答案就是同时满足 $l\le i\le r$ 和 $L\le r-l+1\le R$ 的点集,即图中黄色区域和蓝色区域的交叠部分(红色区域)。
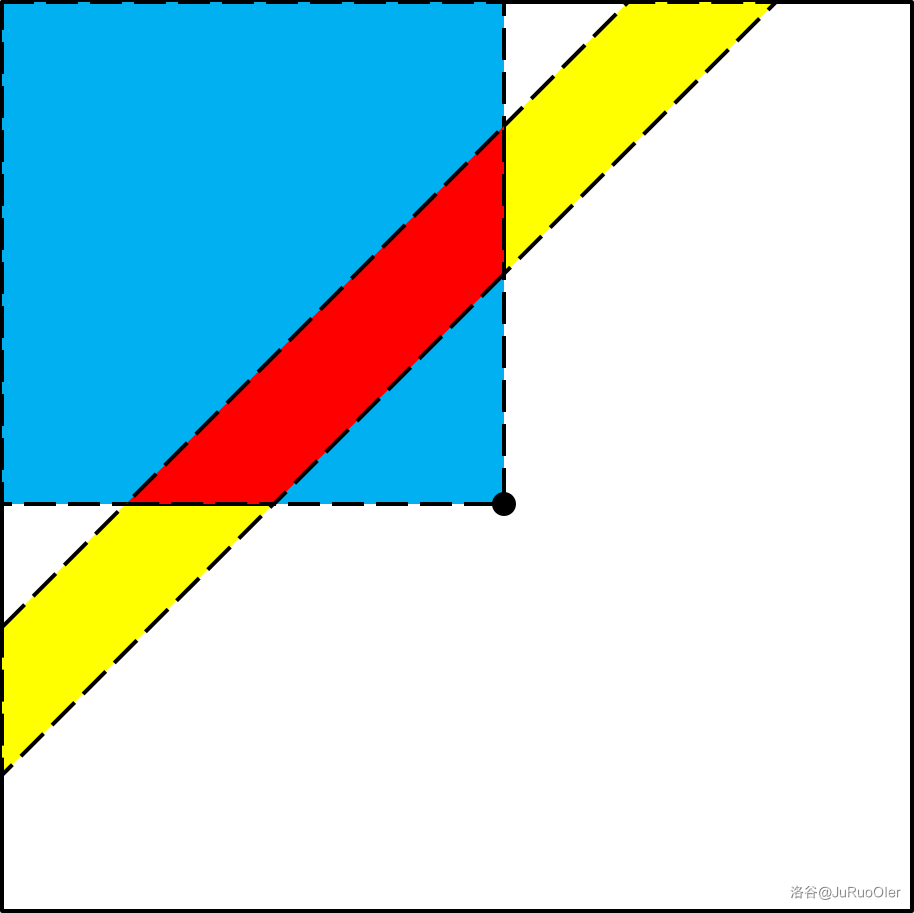
而我们刚才那个东西求出来的是一个平行四边形(下图中黄色、蓝色的部分分别可以求出):
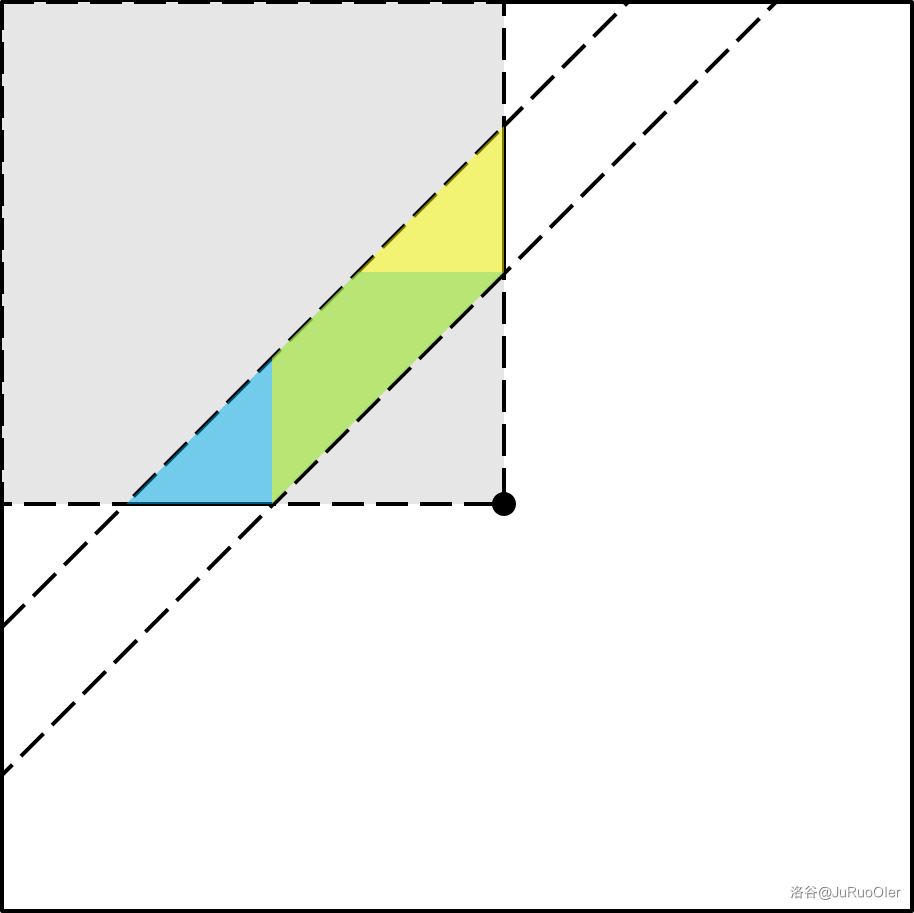
最值是允许重叠的,所以其实把两个平行四边形分别求一遍,也就是把以每个点为左端点和以每个点为右端点分别单调队列一次,就做完了。时间复杂度 $O(nq)$。
……吗?
在 $2L<R$ 的时候,图就变成这样了:
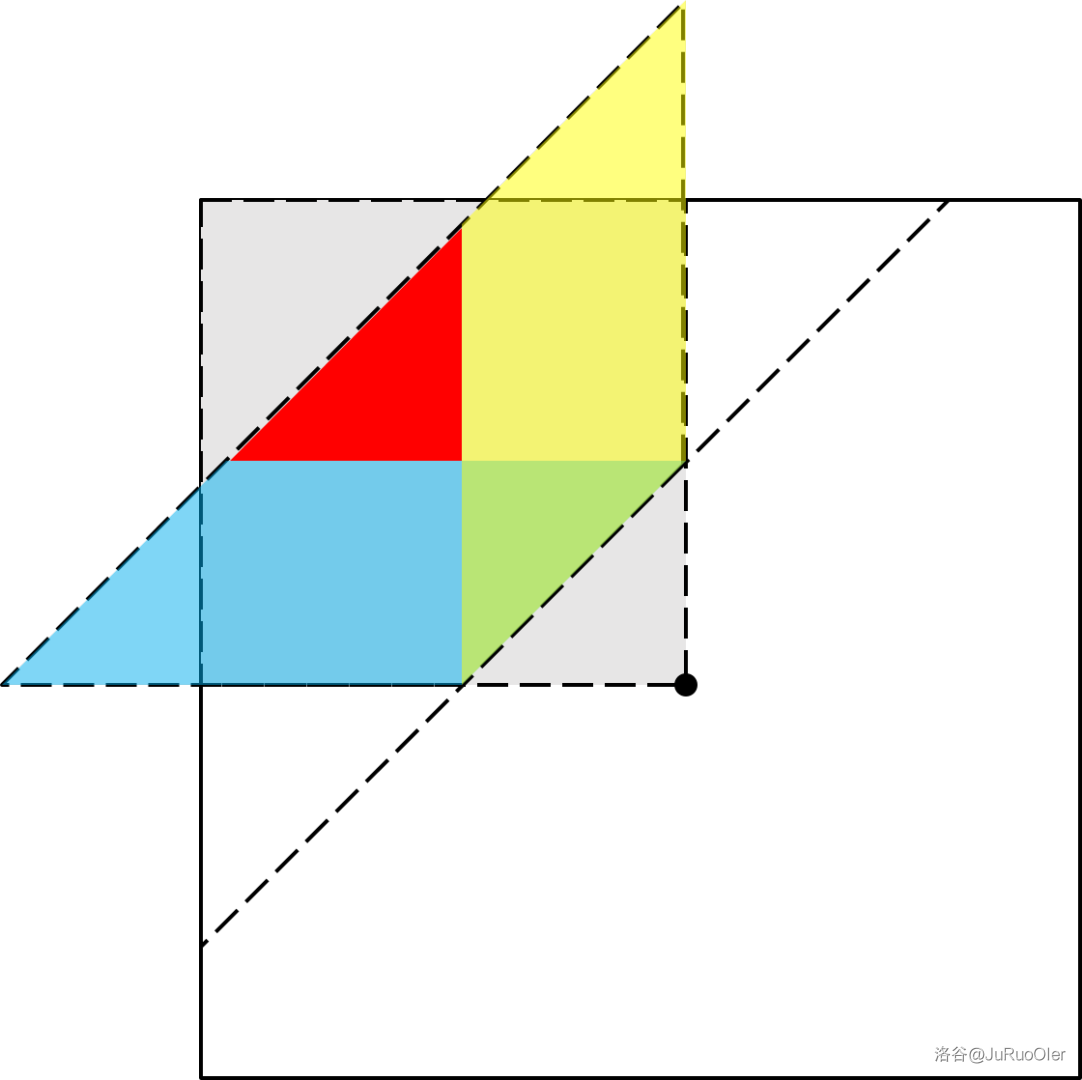
你会发现红色的三角形没算。
按刚才的方法递归地算下去固然没错,但复杂度会带 $\log$,所以需要优化。
考虑倍增分块,将长度范围分成若干块,第 $i$ 块是 $[2^i,2^{i+1}-1]$,则一共只会分成 $\log n$ 块。但这并不能改善复杂度。
但我们可以预处理每个“块区间”,即每段连续的块中每个位置的答案。这时,原询问区间 $[L,R]$ 就被“大卸三块”:设 $[l,r]$ 为其内最长的“块区间”,则答案必然在 $[L,l-1],[l,r],[r+1,R]$ 三段中,取个最值即可。
复杂度 $O(nq+n\log^2 n)$。
:::
# CSP-S2 2026
前两题不知道对不对,反正大样例是过了。
由于主播想睡觉所以今年的部分是我一个朋友写的。
---
我有一个朋友:
- t3 在会正确的 $O(n^2)$ 的前提下把 $O(nm)$ 当 $O(n^2)$ 了所以没写;
- t4 在会正确的 $O(n^2)$ 的前提下因为在 t3 浪费 $150$ min 想假算所以没空写。
如果最后发现加上上述分数后他能进 WC 那他真要叶瞬光了。
让我评价一下?我觉得 T3 T4 都不太难哦,而且代码挺短的,我半小时就过完了。听说他 T1 T2 都做了 $50$ min,哈哈真菜。
另外他每个题默了一段歌词,做迷行赏的大神可以找一下。悄悄告诉你,他是 SD-S01346 哦。
你问我怎么知道这么多的?当然是他告诉我的呀。
## A - P17831 [CSP-S 2026] 能量水晶 / crystal
:::info[统计知识点]
- 其他算法 - 二分 或 双指针
:::
给定长为 $n$ 的数组 $a$,你可以进行至多 $m$ 次操作,每次选择一个数将其加一,求操作后众数个数的最大值。
数据范围:$n\le 5\times 10^5,m\le 10^{18},|a_i|\le 10^{12}$。
:::success[做法]
由于只能加不能减,所以选一些数作为最终的众数后,显然必须要把它们都变成所选数的最大值。
于是考虑枚举最大值 $x$,此时在选的数个数相同的情况下,显然选比 $x$ 小的最大的一些数所需的总操作次数最小。这个可以排序后双指针或者二分来完成,复杂度 $O(n\log n)$。
然后部分写法的二分需要把负数加成正的。
:::
## B - P17832 [CSP-S 2026] 地铁 / subway
:::info[统计知识点]
- 图论 - Floyd
:::
给定 $m$ 个站和 $n$ 个线路,$i$ 号线经过 $k_i$ 个不重复的站 $a_{i,1},\dots,a_{i,k_i}$,从第 $a_{i,j}$ 个站的站厅到该站 $i$ 号线的站台需要 $t_{i,j}$ 单位时间。此外,第 $i$ 个站进站或出站还需要 $w_i$ 单位时间。坐地铁的时间忽略不计。$q$ 次询问,每次给定 $x,y$,求第 $x$ 个站到第 $y$ 个站的最小时间。
数据范围:$n\le 500,m\le \sum k_i\le 5\times 10^5,q\le 10^5$,每个站至多有 $d\le 20$ 条线路经过。
:::success[做法]
作为一个【数据删除】出的题,本题有无数个地方在提示你做法哦。
第一你一看坐地铁只算步行时间就应该觉得不对了喵。
第二你一看 $n$ 这么小 $m$ 这么大就应该觉得不对了喵。
第三你一看 $n$ 这么小还要限制每个站的线路数就应该觉得不对了喵。
总之既然坐地铁都不算时间那不需要建边了呀。对每个线路建点,换乘关系建边,可以 floyd 求出任意两线路之间的最小时间。
然后要对每个询问算上下车时间。此时用到每个站不超过 $d$ 条线的限制,直接 $d^2$ 求出起点站上什么车,终点站从什么车下就可以啦。
复杂度 $O(d(\sum k_i)+n^3+qd^2)$。
:::
## C - P17833 [CSP-S 2026] 迁徙 / migrate
:::info[统计知识点]
- DP - 普通 DP
:::
给定数轴上的 $n$ 个点 $x_1,\dots,x_n$。称点 $i$ 可以直接到达点 $j$,当且仅当 $|x_i-x_j|\le d$。称点对 $(u,v)$($1\le u<v\le n$)为**双径点对**,当且仅当存在**恰好**两条从 $u$ 经过若干个点到达 $v$ 的路径,满足路径中相邻两点间可以直接到达,且路径经过的点数最少。求共有多少个**双径点对**。
数据范围:多测,$\sum n\le 2\times 10^6,|x_i|\le 10^{18}$。
:::success[思路一]
本题有多种不同的切入方向,所以这里稍微收录一些。
我们从整体的路径出发考虑,得到合法点对的性质是,两路径只能存在一个点不同,且不同的两点应相邻,否则都会导致产生更多的最短路径。
据此,<https://www.luogu.com.cn/article/jabb7kgu> 中选择设 $f_i$ 表示到点 $i$ 路径唯一的左端点数,$g_i$ 是到 $i$ 路径有恰好两条的左端点数,$h_i$ 是到 $i$ 和 $i-1$ 均唯一的左端点数。这种选择的好处是直观而且很好写,但是带来的难点是贡献不容易分析清楚呢。
先分预处理出点 $i$ 往左、右一步可以到达的最远点 $l_i,r_i$。顺序枚举每个 $i$,如果 $l_{r_i}=i$,则 $i$ 以左到 $r_i$ 的路径均唯一,此时 $i$ 对 $f_{r_i}$ 的贡献是 $f_i$,对 $g_{r_i}$ 的贡献是 $g_i$。然后分开考虑两路径不同点各处的贡献就好啦。
- 对 $h$ 的贡献在分叉处进行,即若 $r_i-1>i$,则 $i$ 这个点贡献至 $h_{r_i}$;此外若 $l_{r_i-1}=i$,则不同点为 $(r_i-1,r_i)$ 时必然经过 $i$,$f_i$ 贡献至 $h_{r_i}$。
- 对 $g$ 的贡献在分叉合并处进行,即若 $l_{r_i}=i-1$,则 $h_i$ 贡献至 $g_{r_i}$。
- 贡献答案同样在合并处进行,但是因为同一对不同点可以在多个位置合并,所以需要在枚举 $i$ 的时候再进行。首先 $g_{l_i}$ 贡献到答案,此外若 $l_i+1<i$,则可以产生一对不同点 $(l_i,l_i+1)$,故此时 $h_{l_i+1}$ 贡献到答案。
此外,别忘记判掉 $l_i$ 或 $r_i$ 为 $i$ 的边界情况哦。最终的复杂度是 $O(n)$。
:::
:::success[思路二]
除了从整体出发之外,我们也可以先关注断点位置,再从前后缀合并答案。我那个朋友说他是这个思路,想到这了还做不出来吗,哈哈真菜。
枚举不同点 $(i,i+1)$,利用思路一中提到的 $l_{r_i}=i$ 的转移条件,可以分别 DP 出前后缀路径唯一的点对数,则以 $l_i$ 结尾的前缀及 $(l_i,i)$ 中的合法点均可作合法左端点;同理以 $r_{i+1}$ 结尾的前缀及 $(i+1,r_{i+1})$ 中的合法点均可作合法右端点,将两侧的数量相乘,就能得到以当前点为不同点的合法点对数量啦!
复杂度同为 $O(n)$。
:::
## D - P17834 [CSP-S 2026] 研发基地 / hub
我朋友和我说他想了一点分来着,可惜他 T3 花了 $2.5$ 小时想假算导致时间只允许打暴力。可是我把 T4 秒了呀,怎么办喵……
:::info[统计知识点]
- 其他算法 - 二分答案、差分
:::
给定一棵 $n$ 个点的树,你需要在其中选恰好 $k$ 个点,满足:
- 所选点形成不超过两个连通块;
- 树上点到最近的所选点的距离的最大值最小。
求这个最小值。
数据范围:多测,$\sum n\le 2\times 10^6$。
:::success[做法]
首先第一步想到二分还是很简单的喵,你像我整理简要题意一样把关键词连起来就能看到“最大值最小”了喵!
二分答案 $R$,设剥 $R$ 次叶子之后的点集为 $S_R$,则 $|S_R|\le k$ 一定可以,问题在于 $|S_R|>k$ 时需要从 $S_R$ 中删掉一些。
用小猫爪在纸上画画可以发现,删掉的部分在 $|S_R|$ 中应形成一条二度链。
- 度数为 $1$ 的点不能删,因为度数为 $1$ 意味着它外面已经有 $R$ 层被剥去了,再删必然会出现距离为 $R+1$ 的情况。
- 度数大于 $2$ 的点不能删,因为删了之后显然会出现三个或以上连通块。
故枚举每条极长二度链,则受制于每个点所剥去的的子树的最大深度 $h_i$,该点到最近的未被删除的点的距离是有限制的。具体来说,设删除的区间为 $[l,r]$,则 $i-l+1+h_i$ 和 $r-i+1+h_i$ 均不能超过 $R$,也就是该点对 $l$ 和 $r$ 的取值都有限制。但是因为要两端同时不满足限制才不合法,所以不如直接维护有哪些 $l$ 对应的 $[l,l+|S_R|-k-1]$ 不能取,用差分记录所有区间即可。
单组复杂度 $O(n\log n)$。
:::