SAE Interprets MoE: SAE 发现 MoE 模型的专家具备人类可理解的细粒度分工
一扶苏一
·
·
科技·工程
\text{Anyuan Zhuo}^{1,2},\ \text{Shaohua Zhang}^{1},\ \text{Yuan Lin}^{1,\dagger},\ \text{Pinyan Lu}^{2,\dagger} \\
{}^1\text{ByteDance Seed}\qquad {}^2\text{Shanghai University of Finance and Economics} \\
{}^\dagger\text{Corresponding authors}
::::info[AI 使用说明]
本文使用 Muse Wonder 辅助写作
::::
::::info[tl;dr]
我们使用 SAE 将 MoE Layer 的输出分解到了 feature space,并算出了每个 expert 对每个 feature 激活的精确 contribution。在整个 corpus 上做聚合后,我们找到了每个 expert 所主要负责的 feature 集合,进而解读了 experts 的功能。例如我们在 Qwen3-30B-A3B 的中间层找到了负责 Java 开发的专家、负责前端开发的专家。
::::
Project Page · GitHub
Background
MoE
MoE (Mixture of Experts) [1] 架构是前沿 LLM 普遍采用的一种架构。它将传统 Transformer [2] 架构的 dense FFN 层换成多个平行的小 FFN 网络,每次 forward 时仅从其中选择(激活)一部分 FFN 进行计算,并把这些被选中的 FFN 的输出按一个 weight 加权求和,替代原来 dense FFN 的输出。这样可以在维持推理时的算力开销不变的情况下增大模型参数量,从而提升模型能力。其中每个小的 FFN 被称为一个专家(Expert)。
设某个 token 在进入 MoE layer 时的 hidden state 为 h(t),它是一个 d 维向量。Router 根据 h(t) 给每个 expert 打分,选出分数最高的 k 个,并给它们分配归一化的 gating weight。记被选中的 expert 集合为 A(t),第 j 个 expert 的 gating weight 为 g_j(t),它的输出向量为 u_j(t),这一层的输出为
y(t)=\sum_{j\in A(t)} g_j(t)\,u_j(t).
被选中的几个 expert 各自处理同一个输入,再把输出按 gating weight 做加权求和。本文研究的 Qwen3-30B-A3B [3] 一共有 48 层,每层有 128 个 experts,每个 token 激活其中 8 个。
SAE
SAE (Sparse Autoencoder) [4] 的输入是模型的 hidden state,本文里具体是 MoE layer 的输出 y(t)。它的 encoder 把 y(t) 映射到一个维度高得多的空间,decoder 再用映射结果近似重构 y(t):
f(t)=\text{TopK-ReLU}_{\kappa}(W_{\text{enc}}\,y(t)+b_{\text{enc}}),\qquad \hat{y}(t)=W_{\text{dec}}\,f(t)+b_{\text{dec}}\approx y(t).
通过解释总结所有激活了对应 latents 的 context,就能对 latents 作出解释 [5]。例如,一个 latents 可能被解释为「二分查找里的小于号」,「下雨的天气」,「算法竞赛的题目描述」等。
### Expert specialization
既往研究大多用带 domain 标签的 corpus 统计每个 expert 被选中的频率。例如,GitHub 上的文本标为 code,arXiv 上的文本标为 academic,再看哪些 expert 在这些文本上更容易被 router 选中。
在这套测量下,前人的结论分成几类。DeepSeek-V3 和 OLMoE 的分析报告 experts 对特定 domain 有明显偏好,呈现 domain specialization [6][7]。Mixtral 和 OpenMoE 的分析发现 routing 与人类划分的 domain 关系较弱,token identity 等表面属性的影响更突出 [8][9]。近期还有工作自动标注整个 expert,认为 experts 更接近细粒度的 task experts [10]。这些结论彼此并不吻合,experts 是否形成了 specialization、specialization 沿什么粒度组织,目前学界还没有共识。
这套测量方式本身有几个限制。第一,domain 的划分由研究者提前给定,分析只能检查模型的分工与这套划分的吻合程度。第二,corpus 层面的标签通常很粗,一篇文档会被整体记为 math 或 code,文档中的叙事、说明、公式和代码也随之得到同一个标签。第三,router 在每个 token 上单独做选择,单个 token 的工作内容很难由整篇文档的标签准确代表。第四,选中频率记录了 expert 是否被选中,gating weight 的大小和它对这层实际输出的影响还没有进入统计。一个 expert 经常被选中,仍然可能只提供很小一部分输出。
本文用 SAE latents 作为分析单位。Latents 从模型自身的 activations 中学出,分析的 granularity 可以细到单个 feature。统计的量是每个 expert 对每个 latent 激活实际提供了多少份额,统计粒度落在单个 token 上。Specialization 的问题由此变成:每个 expert 主要驱动哪些 latents,这些 latents 合起来对应什么功能。
## Method
我们的方法分为三部分:算出每个 expert 对每个 latent 的 contribution,把高 contribution 的关系整理成每个 expert 的 dominant set,再解释 dominant set 中的 latents,读出这个 expert 的职责。
**计算 contribution**。对一个已经激活的 latent $i$,它的激活值是 encoder 在 $y(t)$ 上的一个 affine 变换:
$$
f_i(t)=W_{\text{enc},(i)}\cdot y(t)+b_{\text{enc},(i)}.
$$
把 MoE 输出的公式代入,$y(t)$ 本身是 expert 输出的加权和,于是 latent 的激活天然地拆成每个 expert 一项,再加上 bias:
$$
f_i(t)=\sum_{j\in A(t)} g_j(t)\,W_{\text{enc},(i)}\cdot u_j(t)+b_{\text{enc},(i)}.
$$
每一项 $g_j(t)\,W_{\text{enc},(i)}\cdot u_j(t)$ 就是 expert $j$ 在这个 token 上对 latent $i$ 的原始贡献,它衡量 expert $j$ 的输出在 latent $i$ 对应方向上的投影有多大。投影为正时,expert 在推动这个 latent 激活;投影为负时,expert 在抑制它。没有被激活的 latent 无法进入观测,负贡献的统计会系统性地缺失,因此我们只保留正的部分,定义 contribution 为
$$
c(j,i,x_{1:t})=\text{ReLU}\big(g_j(t)\,W_{\text{enc},(i)}\cdot u_j(t)\big).
$$
单个 token 上,先把 $c$ 在被激活的 experts 之间归一化,得到 expert $j$ 在这一时刻占的份额:
$$
C(j,i,x_{1:t})=\frac{c(j,i,x_{1:t})}{\sum_{j'\in A(t)} c(j',i,x_{1:t})}.
$$
$j\notin A(t)$ 或 latent $i$ 未激活时,$C(j,i,x_{1:t})=0$。把这个份额在整个数据集的所有 token 位置上取平均,再对全部 $N$ 个 experts 归一化,得到 contribution fraction $s(j,i)$:
$$
C(j,i)=\mathbb{E}_{(x,t)}\big[C(j,i,x_{1:t})\big],\qquad
s(j,i)=\frac{C(j,i)}{\sum_{j'=1}^{N} C(j',i)}.
$$
$s(j,i)$ 越接近 1,latent $i$ 在 corpus 上的激活越集中地由 expert $j$ 驱动。128 个 experts 完全平均用力时,每个 $s(j,i)$ 为 $1/128\approx 0.008$。
**构建 dominant set**。取阈值 $\tau=0.2$,当 $s(j,i)\geq \tau$ 时,我们说 expert $j$ dominates latent $i$。0.2 比平均用力时的 0.008 高出 25 倍,能留下来的关系代表了很实质的贡献。对每个 expert 收集它 dominates 的全部 latents,就得到它的 dominant set,记为 $S(j)$。这些 (expert, latent) 关系连成的二部图称为 dominance graph,expert 的功能解读来自它在图上连接的那组 latents。
我们研究了 dominance graph 的结构,发现每个 latent 通常只有一到两个 dominators,不同 experts 的 dominant sets 之间重叠很小,每个 expert 的 dominant set 中平均约有一半 latents 只由它单独 dominates。每个 expert 因此都有一组相对专属的 latents,可以用来描述它的功能。
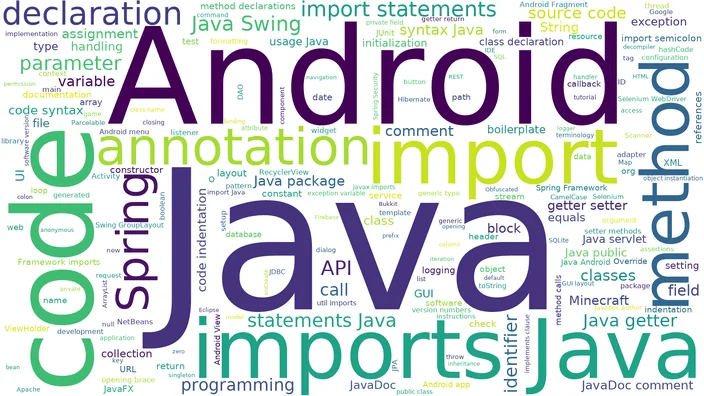
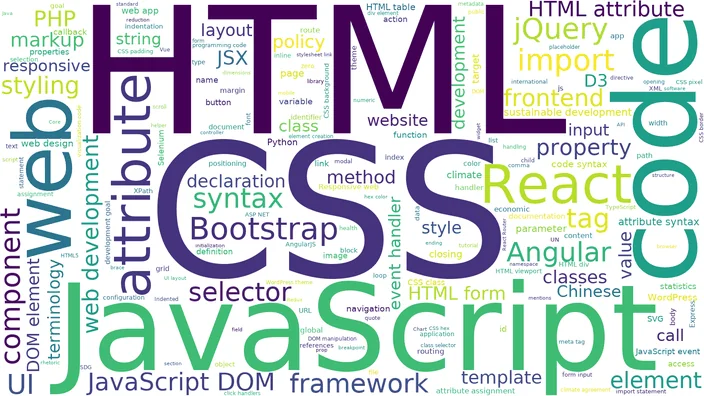
**解释 experts**。阅读一个 expert 的 dominant set 里 latents 的解释,就得到这个 expert 的功能说明。把全部解释按词频聚合成 word cloud 后,这个功能可以可视化地呈现出来,字号越大表示这个词在解释中出现得越频繁。第 30 层的 expert 50 和 expert 57 的词云如下,前者是一个和 Java 开发相关的 expert,后者是一个和 frontend 开发相关的 expert:
## Results
我们得到两个主要结果。
第一,experts 的分工细于 coarse domain。单个 coarse domain 内部还有多个各自独立的子领域专家。我们发现大部分专家的领域属于细粒度的子领域,而不是 code、math 这样的大领域。例如,上面的 expert 50 和 expert 57 同属 code,一个负责 Java 与 Android 开发,一个负责前端开发,各自的 dominant set 主题集中,内容互不相同。
类似的,我们同样在找到了在 Math 领域里具有细粒度分工的 expert。expert 1 负责 geometry,expert 76 负责 arithmetic 与 polynomial:
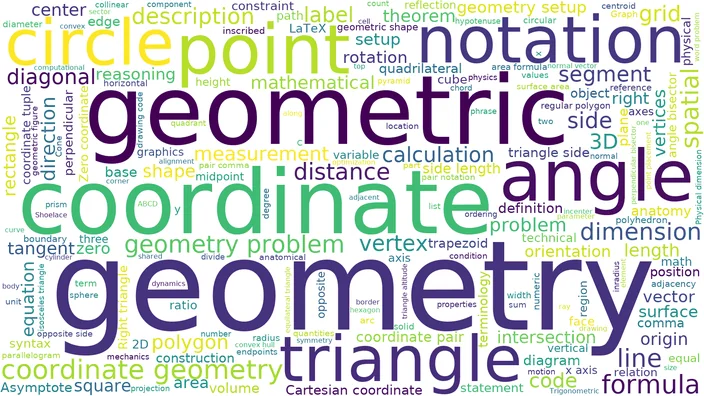
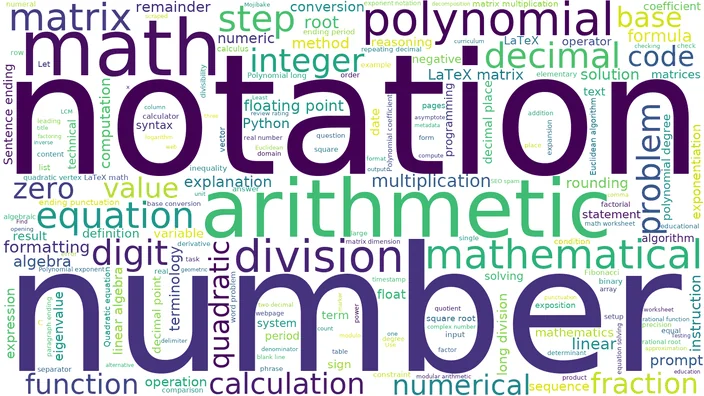
主题占比统计与词云一致:expert 50、57、1、76 的 dominant set 中属于各自主题的解释分别占 86.7%、78.6%、78.1% 和 59.1%,随机抽取的对照 latents 中同一主题只占 1.9% 到 6.7%。每个 dominant set 的主题都高度集中,细粒度专家确实存在。
第二,experts 在 domain level 的分布明显不均衡。我们用 GPT 给每个 expert 按大类进行了归类,第 30 层的 128 个 experts 被分到 11 个 domains,这套大类从 experts 的功能中恢复,归类前没有给定名称或标准。Computing 占了 28 个,Mathematics and reasoning 占了 20 个,两个 domains 合计 48 个,占全层的 37.5%。Text form 有 21 个 experts,Text form、Language 和 Entities and identifiers 这三个围绕文本形式与实体组织的 domains 合计有 36 个 experts,占全层的 28.1%,分配最少的几个 domains 各只有 4 到 5 个 experts。一个 domain 拿到的 experts 越多,内部能划分的子领域也越细,图中的 Java 与前端 experts 就是 Computing 内部的一个例子。
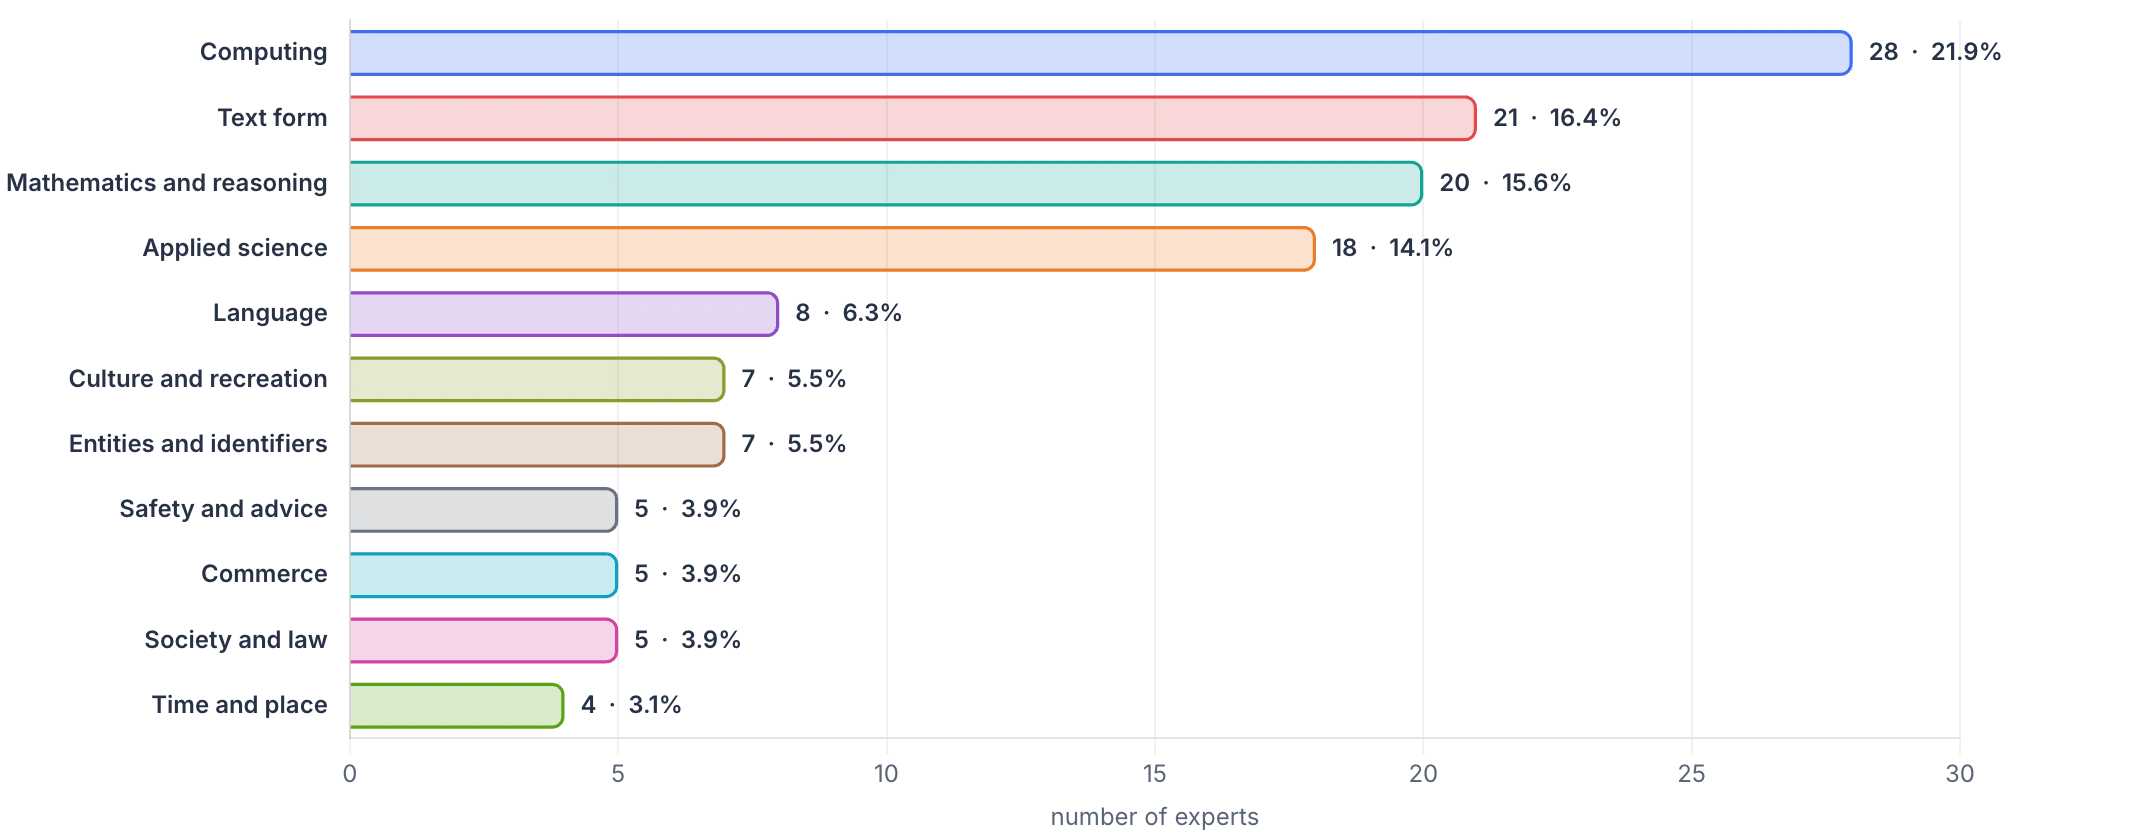
*第 30 层 11 个 domains 各自拥有的 expert 数量,数据同 [project page](https://bytedance-seed.github.io/SAE-interprets-MoE/) 上的 interactive chart。*
这种不均衡的一种可能来源是 pretraining 数据的构成:公开报道的训练数据配比中,code 和 mathematics 通常占比较高,模型会在这类数据里做更细的区分并投入更多 experts。Qwen3 没有公开自己的数据配比,这个解释目前保持为一个假说。
## Conclusion
MoE 层呈现出一套模型自发学到的分工:每个 expert 主要驱动一组相对专属的 latents,这组 latents 常常只对应一个细于 domain 的子领域,而整层在不同 domains 之间的分配极不均匀。这套分工可以为后续工作提供可验证的预测,例如剪掉或编辑一个 expert 时,受影响最大的应当是它 dominates 的那些 latents。
## Our Contribution
1. 这是第一个直接解读 experts 在训练中自然形成了什么层级的 specialization 的工作。分析单位来自模型自身学到的 SAE latents,specialization 的粒度从每个 expert 的 dominant set 中读出,整个过程没有预设 domain 分类体系,层级本身成为被测量的对象。
2. 在 Qwen3-30B-A3B 上,我们确认 specialization 真实存在,粒度比通常讨论的 domain 层级细得多。第 4、30、46 层上,多数 latents 只由一到两个 experts 主导,experts 之间的 dominant set 重叠很小;第 30 层里,code 内部有 Java 与前端的分工,math 内部有 geometry 与 arithmetic 的分工。
3. 我们开源了 Qwen3-30B-A3B 第 4、30、46 三层的 SAE,每个 SAE 含 $2^{20}$ 个 latents,权重发布在 [Hugging Face](https://huggingface.co/ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE),复现代码和数据在 [GitHub](https://github.com/ByteDance-Seed/SAE-interprets-MoE) 中。
第 30 层全部 128 个 experts 的词云、标签和 domain 归属可以在 [project page](https://bytedance-seed.github.io/SAE-interprets-MoE/) 的 interactive explorer 中逐个查看,复现实验的代码和数据在 [GitHub](https://github.com/ByteDance-Seed/SAE-interprets-MoE) 中。
## References
[1] Shazeer et al. Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. ICLR 2017. [arXiv:1701.06538](https://arxiv.org/abs/1701.06538)
[2] Vaswani et al. Attention Is All You Need. NeurIPS 2017. [arXiv:1706.03762](https://arxiv.org/abs/1706.03762)
[3] Yang et al. Qwen3 Technical Report. 2025. [arXiv:2505.09388](https://arxiv.org/abs/2505.09388)
[4] Huben et al. Sparse Autoencoders Find Highly Interpretable Features in Language Models. ICLR 2024. [arXiv:2309.08600](https://arxiv.org/abs/2309.08600)
[5] Paulo et al. Automatically Interpreting Millions of Features in Large Language Models. 2024. [arXiv:2410.13928](https://arxiv.org/abs/2410.13928)
[6] Liu et al. DeepSeek-V3 Technical Report. 2024. [arXiv:2412.19437](https://arxiv.org/abs/2412.19437)
[7] Muennighoff et al. OLMoE: Open Mixture-of-Experts Language Models. ICLR 2025. [arXiv:2409.02060](https://arxiv.org/abs/2409.02060)
[8] Jiang et al. Mixtral of Experts. 2024. [arXiv:2401.04088](https://arxiv.org/abs/2401.04088)
[9] Xue et al. OpenMoE: An Early Effort on Open Mixture-of-Experts Language Models. 2024. [arXiv:2402.01739](https://arxiv.org/abs/2402.01739)
[10] Herbst, Wermter and Lee. The Expert Strikes Back: Interpreting Mixture-of-Experts Language Models at Expert Level. 2026. [arXiv:2604.02178](https://arxiv.org/abs/2604.02178)